
机器学习与深度学习 / 系统课时
相似度与距离
相似度与距离
相似度和距离都用于比较样本,但回答的问题并不相同:距离关注两个点相隔多远,相似度关注它们有多像。掌握欧氏距离和余弦相似度的计算含义与适用边界,是理解聚类、检索和向量表示的重要基础。
学习目标
- 理解距离与相似度在含义和数值方向上的区别
- 掌握欧氏距离与余弦相似度的核心计算方式
- 能根据数据特点选择更合适的度量方法
距离与相似度分别回答什么
距离通常满足“越小越接近”的直觉。例如二维平面上的两个点,如果坐标差异很小,它们的欧氏距离也很小。相似度则通常采用“越大越相似”的定义,例如余弦相似度接近 1 时,说明两个向量方向非常接近。
因此,同一组对象可以同时拥有距离和相似度,但两种数值不能直接混为一谈。使用算法或 API 时,应先确认它要求的是“最小距离”还是“最大相似度”,否则排序方向可能完全相反。
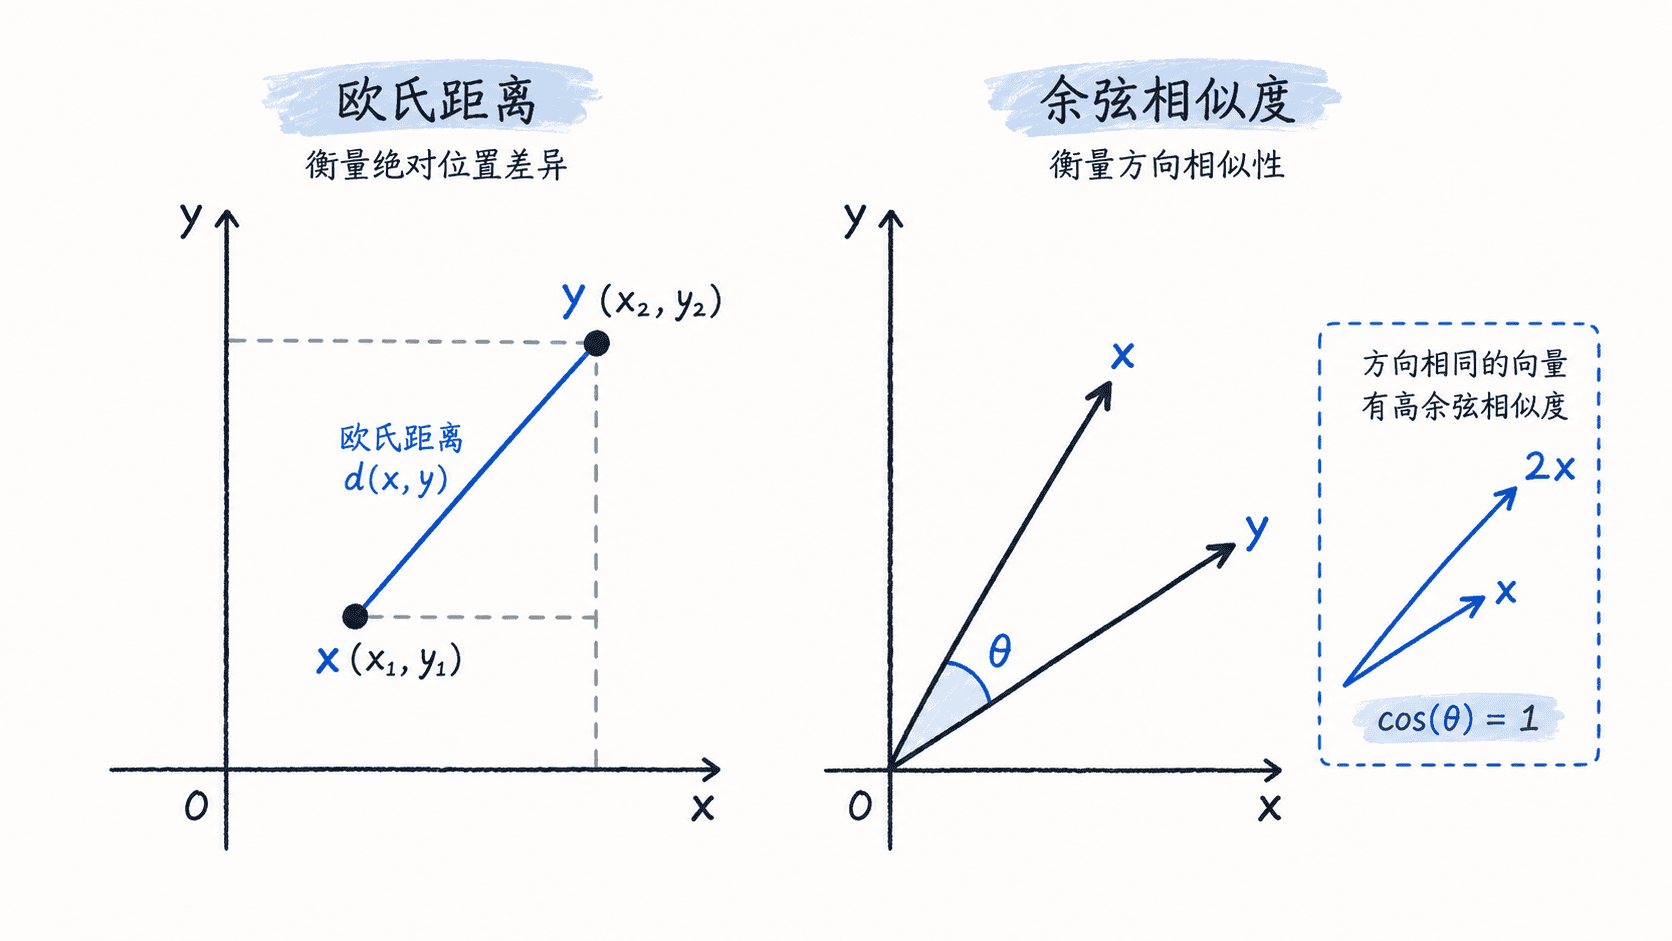
欧氏距离衡量绝对差异
对两个 维向量 和 ,欧氏距离为:
例如 、,两个维度的差分别为 3 和 4,因此距离为 5。它与平面中两点间的直线距离完全一致。
欧氏距离适合各维度量纲接近、数值差异本身有意义的场景,例如根据身高、体重等经过标准化的特征寻找邻近样本。它的主要风险是受尺度影响:如果一个特征取值范围是 0~1,另一个是 0~100000,后者很可能主导距离。
余弦相似度比较方向
余弦相似度使用两个向量夹角的余弦值:
对于非零向量,值越接近 1,方向越一致;接近 0 表示近似正交;接近 -1 表示方向相反。它更关注各维度之间的比例关系,而不是向量整体长度。
这使余弦相似度特别适合文本向量和语义嵌入。是否适合用余弦取决于向量模型训练时的度量和实际检索验证。文章字数、向量范数和主题接近度之间没有通用的一一对应。
看两个度量怎样改变排序
查询向量为 (1,0),候选 A=(10,0),B=(1,1)。欧氏距离分别为 9 和 1,B 更近。余弦分别为 1 和约 0.707,A 更相似。
from math import dist, fsum, hypot, isfinite

def unit(values):
    if not values or any(not isfinite(v) for v in values):
        raise ValueError("向量必须非空且有限")
    scale = max(abs(v) for v in values)
    if scale == 0:
        raise ValueError("零向量没有余弦方向")
    scaled = [v / scale for v in values]
    length = hypot(*scaled)
    return [v / length for v in scaled]

def cosine(x, y):
    if len(x) != len(y):
        raise ValueError("维度必须相同")
    u, v = unit(x), unit(y)
    value = fsum(a * b for a, b in zip(u, v))
    return min(1.0, max(-1.0, value))

query = (1, 0)
for name, row in [("A", (10, 0)), ("B", (1, 1))]:
    print(name, f"欧氏距离 {dist(query, row):.1f}", f"余弦 {cosine(query, row):.3f}")
把所有非零向量做 L2 归一化后,平方欧氏距离等于 2×(1−余弦),所以两种排序一致。未经归一化通常不一致。1−余弦也并不总是满足三角不等式。例如方向依次为 0°、60°、120° 的三个单位向量,两段相邻差都是 0.5,首尾差却是 1.5。使用要求数学度量的算法时要核对该约束。
如何选择度量
如果“数值相差多少”就是问题本身,应优先考虑欧氏距离;如果更关心特征比例或向量方向,而不希望整体大小产生过强影响,余弦相似度通常更合适。
| 场景 | 更常见的选择 | 原因 |
|---|---|---|
| 二维或三维空间位置 | 欧氏距离 | 真实空间间隔有直接含义 |
| 标准化后的连续特征聚类 | 欧氏距离 | 各维差值共同构成邻近程度 |
| 文本或语义向量检索 | 余弦相似度 | 更关注向量方向而非长度 |
| 数据各维尺度差异明显 | 先预处理再选择 | 原始尺度可能扭曲比较结果 |
不存在对所有数据都最好的度量。真正需要判断的是:哪些差异应该被算法认为重要。距离或相似度一旦改变,最近邻、聚类结果和检索排序都可能随之改变,因此度量方式本身就是模型设计的一部分。