
机器学习与深度学习 / 系统课时
激活函数
激活函数
激活函数决定神经元如何响应加权结果,并为网络引入非线性。本课将比较 ReLU、Sigmoid 和 Softmax 的输出范围、典型用途与常见误区,帮助你为隐藏层和输出层选择合适函数。
学习目标
- 解释激活函数为何不可缺少
- 区分 ReLU、Sigmoid 和 Softmax 的用途
- 根据任务类型选择输出层激活函数
三种常用激活函数
ReLU:隐藏层的常用选择
ReLU 定义为 。当输入为负数时输出 0,输入为正数时保持不变。它在正半轴的导数为 1,在负半轴为 0,在 0 处数学上不可微,自动微分实现会约定一个返回值。它常用于隐藏层。
ReLU 的风险是某些神经元长期落在负区间后始终输出 0,形成“死亡 ReLU”。可通过合理初始化、调整学习率或改用 Leaky ReLU 缓解。
Sigmoid:把结果压缩为概率
Sigmoid 定义为:
它把有限实数映射到严格介于 0 与 1 的值,浮点极端输入可能舍入到端点。二分类可用一个 Sigmoid,多标签可对每个标签分数分别映射。输入绝对值很大时,曲线趋于平坦,梯度接近 0,因此通常不再作为深层隐藏层的首选。
Softmax:形成互斥类别分布
Softmax 在每个样本的类别轴上归一化分数,输出之和在数学上为 1。批量计算时应选类别轴,避免把不同样本混在同一个分母中:
它适用于“猫、狗、鸟三选一”这类互斥的单标签多分类。若一张图可同时包含“人物”和“户外”,可分别估计两个标签为真的概率,它们可以同时较高,合计也可以超过 1。共享隐藏表示能利用共同特征,逐标签输出本身不要求实际标签统计独立。
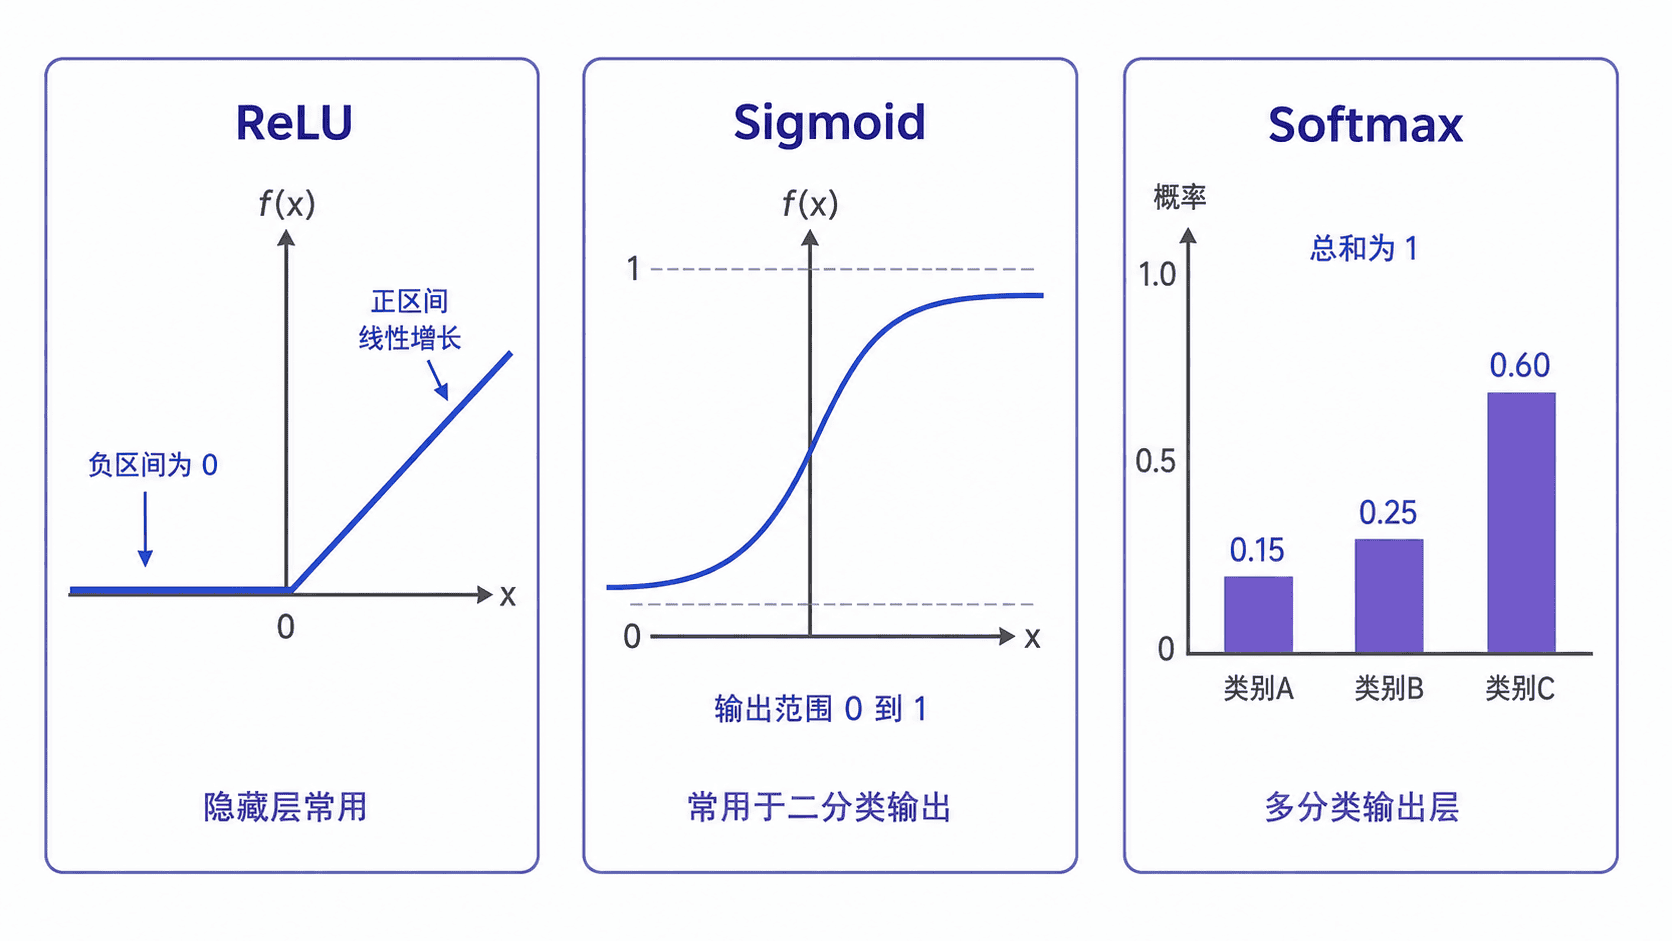
选择规则
| 场景 | 推荐函数 | 关键原因 |
|---|---|---|
| 深层网络隐藏层 | ReLU | 计算简单,正区间梯度直接 |
| 二分类输出层 | Sigmoid | 单个结果可解释为正类概率 |
| 多标签输出层 | 多个 Sigmoid | 标签可同时成立,按标签输出各自估计 |
| 单标签多分类输出层 | Softmax | 概率总和为 1,类别互斥 |
用极端分数核对归一化
下例使用非空、有限的一条分数向量。Softmax 先减去该向量的最大值,归一化结果保持不变,但指数输入不会为正,避免大正数导致溢出。
from math import exp, fsum

def sigmoid(z):
    if z >= 0:
        return 1 / (1 + exp(-z))
    value = exp(z)
    return value / (1 + value)

def softmax(scores):
    pivot = max(scores)
    weights = [exp(score - pivot) for score in scores]
    total = fsum(weights)
    return [weight / total for weight in weights]

print("ReLU:", [max(0, z) for z in (-3, 0, 2)])
print("多标签:", [round(sigmoid(z), 3) for z in (2, 1)])
print("三选一:", [round(p, 3) for p in softmax([1000, 999, 998])])
三项 Softmax 约为 0.665、0.245、0.090。两个标签的 Sigmoid 约为 0.881、0.731,合计超过 1。PyTorch 的 CrossEntropyLoss 和 BCEWithLogitsLoss 都直接接收原始 logits。在调用这些接口前应保留 logits,展示预测时再做概率映射。下一课比较训练损失与最终准确率。