
机器学习与深度学习 / 系统课时
均值方差与分布
均值方差与分布
面对一组数据,仅看最大值和最小值往往无法判断它的整体特征。均值描述数据大致位于哪里,方差描述数据围绕中心分散得有多开,而分布进一步说明不同取值出现的规律,这些量也是分析训练数据和模型输出的基础工具。
学习目标
- 会使用均值描述数据的集中位置
- 理解方差和标准差如何衡量数据离散程度
- 能从分布角度区分“中心相同但形态不同”的数据
均值描述数据的中心位置
对于 个数值 ,算术均值为:
例如数据为 2、4、4、6,则均值为:
均值把整组数据压缩成一个代表性的中心位置,常用于比较不同数据集的平均水平。例如,可以比较训练集与测试集某个数值特征的均值,快速发现明显的数据偏移。
但均值对极端值比较敏感。若数据从 2、4、4、6 变为 2、4、4、100,均值会被 100 大幅拉高。因此,均值提供的是重要信息,但不能单独描述整组数据。
方差衡量围绕均值的离散程度
两组数据即使均值完全相同,也可能有截然不同的稳定程度。方差通过计算每个值与均值之间距离的平方,再取平均来衡量这种分散程度。
若把总体方差记作 ,可以写成:
仍以 2、4、4、6 为例,均值是 4,各值与均值的偏差平方分别是 4、0、0、4,因此总体方差为:
标准差是方差的平方根,即 。方差的单位是原数据单位的平方,而标准差与原数据保持相同单位,因此实际解释数据波动范围时通常更直观。
相同均值不代表相同分布
考虑两组数据:A 为 2、4、4、6,B 为 0、4、4、8。它们的均值都等于 4,但 B 中的数据离 4 更远,因此 B 的方差更大。
| 数据 | 均值 | 总体方差 | 特征 |
|---|---|---|---|
| 2、4、4、6 | 4 | 2 | 更集中 |
| 0、4、4、8 | 4 | 8 | 更分散 |
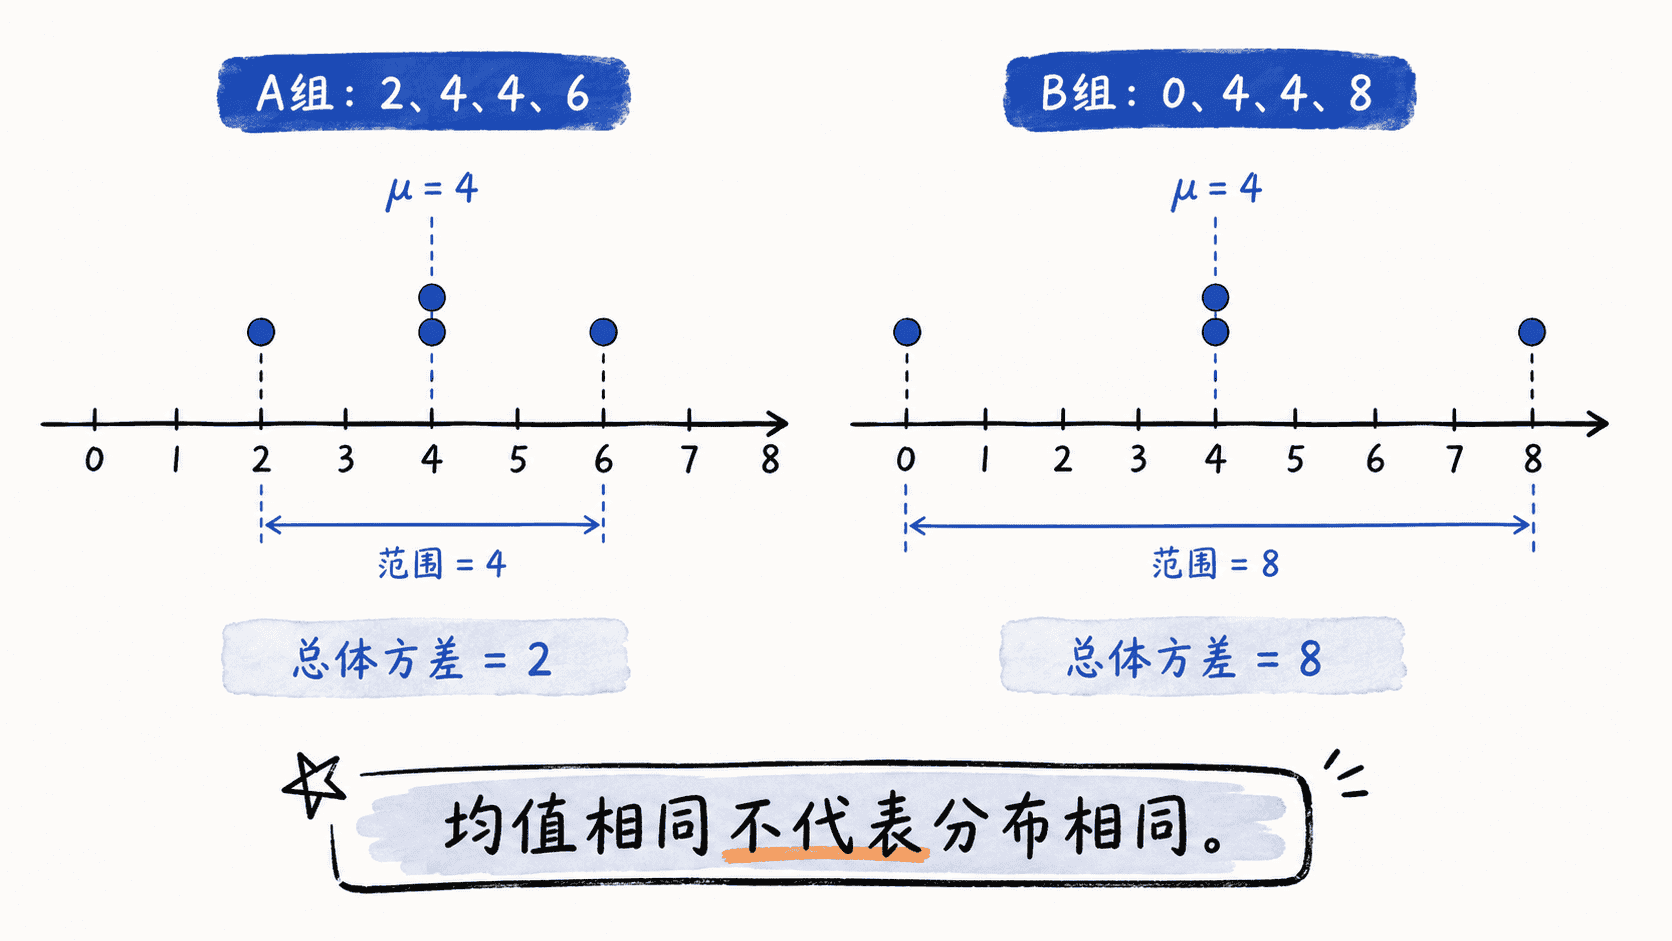
“分布”描述的是一个变量可能取哪些值,以及这些值分别有多常见或多可能。均值和方差只是分布的两个摘要指标,不能完整保留它的形状。偏斜、长尾、多峰等结构,都可能被单个均值和方差隐藏。
均值和方差相同也不能确定分布。比较 [-1,1] 与 [-2,0,0,0,0,0,0,2],两者的经验均值都为 0,总体口径方差都为 1,后者零值占 75%。
from statistics import mean, pvariance, variance

a = [2, 4, 4, 6]
b = [0, 4, 4, 8]
print("A 的总体方差和样本方差:", pvariance(a), f"{variance(a):.3f}")
print("B 的均值和总体方差:", mean(b), pvariance(b))
for values in ([-1, 1], [-2, 0, 0, 0, 0, 0, 0, 2]):
    print("均值、总体方差、零值占比:", mean(values), pvariance(values), values.count(0) / len(values))
代码中的 pvariance 描述给定值的总体口径,variance 按样本口径计算。前两组的总体口径方差分别为 2 与 8,A 的样本方差为 8/3。
常见分布与模型数据
不同类型的数据通常需要不同的概率分布来描述。二分类标签只有 0 和 1,可以用伯努利分布表达;多分类标签对应多个离散类别,可以用类别分布表示;若满足中心极限定理的条件,标准化的样本和或均值可能近似正态。这不会保证每个原始测量值的分布也近似正态。
这里的重点不是看到连续数据就假定它服从正态分布,而是先观察数据,再判断哪种分布假设合理。真实业务数据经常存在偏斜、截断、异常值和多个群体混合等现象。
在机器学习中,训练前可以比较训练集和验证集重要特征的均值、标准差以及整体分布;训练后也可以观察预测概率和残差的分布。如果均值变化不大但分布形态明显改变,仅比较平均值就可能漏掉重要的数据漂移。
均值回答“数据大致在哪里”,方差回答“数据散得多开”,分布回答“数据整体怎样出现”。实际分析时把三者结合起来,才能避免用一个平均数替代整组数据的真实结构。