
机器学习与深度学习 / 系统课时
训练集验证集测试集
训练集验证集测试集
数据怎样划分,取决于部署时哪些记录对模型来说是新样本。若要预测新用户,随机拆分订单可能让同一用户的历史出现在两边。若要预测未来交易,即使用户允许重复出现,也必须保证训练只看到相应时点可取得的信息。
学习目标
- 分清训练、验证和测试分别回答的问题。
- 按实体或时间划分,核对样本和标签的边界。
- 冻结最终方案,把测试结果和后续模型决策隔离开来。
三类数据的职责
| 数据 | 负责的决策 |
|---|---|
| 训练集 | 拟合预处理参数、模型权重等 |
| 验证集 | 比较候选特征、超参数、早停点和决策阈值 |
| 测试集 | 评估已冻结的方案,并记录适用对象和误差 |
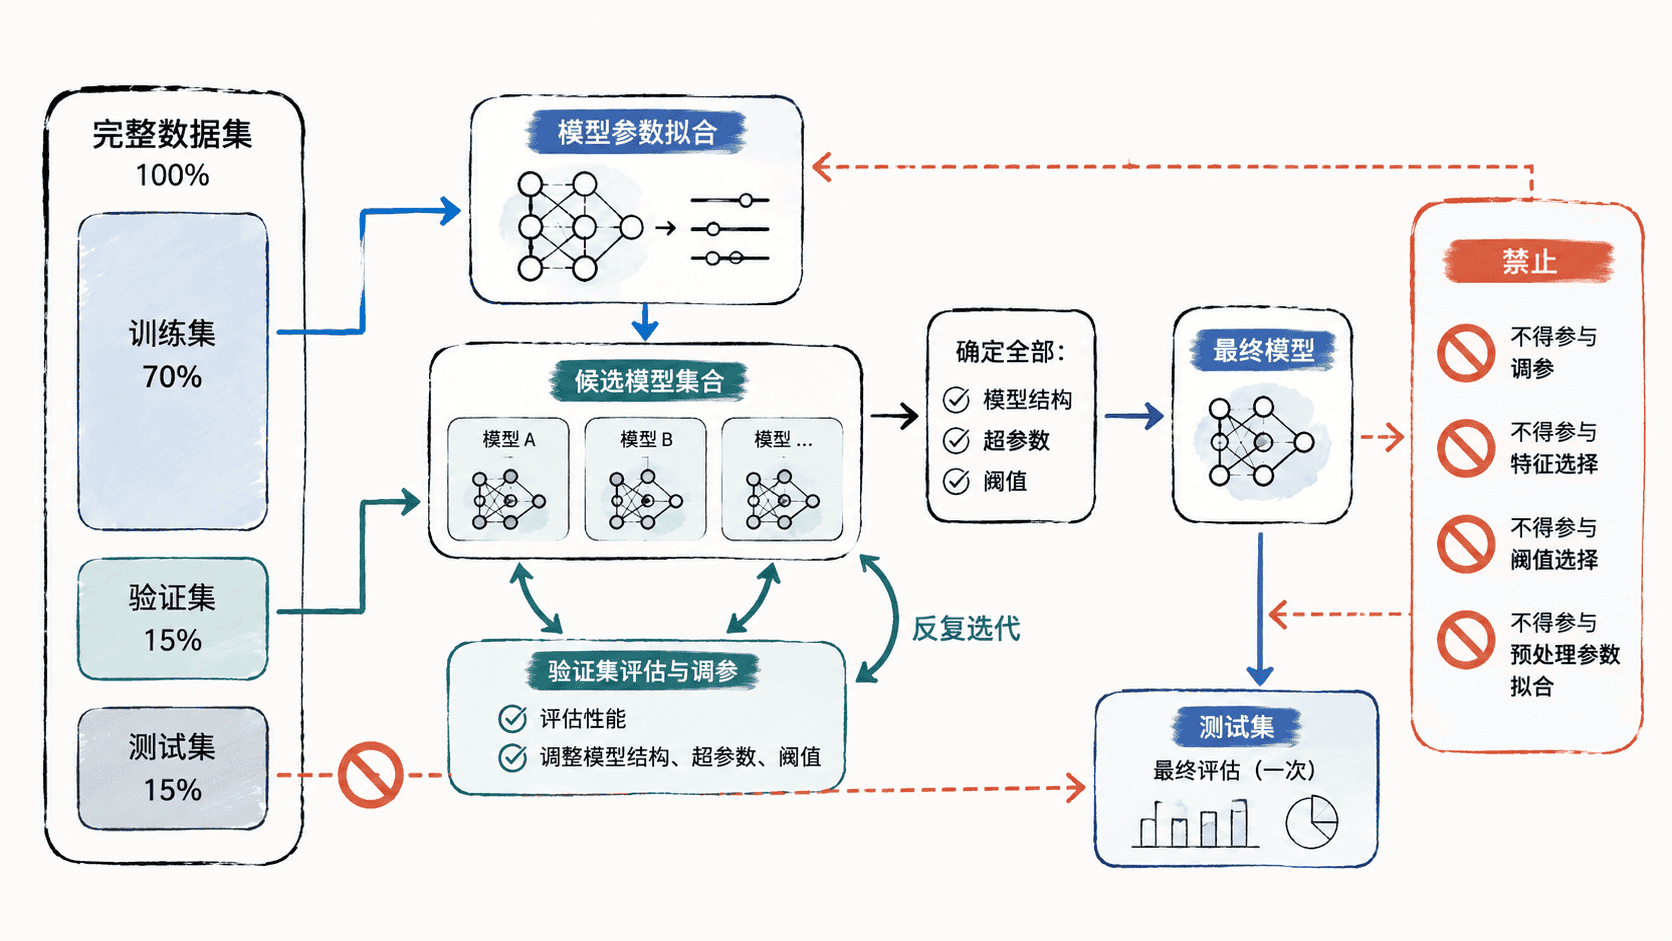
模型确定后,可以按计划用开发数据重训,例如合并训练集和验证集。重训会改变模型及其分数分布,若要选阈值或校准分数,要预先安排独立校准数据或折外预测;沿用旧阈值需要验证它适用。测试前冻结预处理、模型、阈值、指标和版本。用测试结果修改这些选择后,重新取得独立测试数据再报告最终分数。 Google 机器学习速成课程数据划分 scikit-learn 交叉验证
根据数据产生方式选择划分
| 部署对象 | 常见划分 | 必须核对 |
|---|---|---|
| 同分布、近似独立的新记录 | 随机划分,分类时可按类别分层 | 检查少数类样本数和各集合覆盖。分层不会阻止同实体重复 |
| 新用户、新设备、新患者 | 先按实体分组再划分 | 相同实体及其重复记录不得跨组。需要平衡标签时在组约束下尽量匹配分布 |
| 未来时段 | 按时间顺序划分或逐窗评估 | 时间戳、特征可用时点、标签成熟时点。标签窗口跨边界时可设置间隔或排除相应行 |
某个项目可能同时要求未来记录和全新实体。要在数据清单中明确这两个约束。只固定随机种子还不足以复现,需要同时保存数据版本、划分算法以及每条记录的集合归属。 scikit-learn 分层、分组和时间序列切分说明
示例:按用户做 70/15/15 划分
每位用户有五笔合成订单。脚本使用 Python 标准库,先切用户 ID,再按 ID 分配订单。本例用户数可整分,订单数也刚好满足比例。实际用户订单量不同,切的是用户比例,订单比例需另行统计。示例不承担类别分层。
from itertools import combinations
from random import Random


orders = [(user, f"{user}-{i}") for user in range(20) for i in range(5)]
users = sorted({user for user, _ in orders})
Random(42).shuffle(users)
train_users, val_users, test_users = map(set, (users[:14], users[14:17], users[17:]))
splits = [train_users, val_users, test_users]

assert all(left.isdisjoint(right) for left, right in combinations(splits, 2))
assert set.union(*splits) == set(users)
partitions = [[row for row in orders if row[0] in group] for group in splits]

for name, group, rows in zip(("train", "validation", "test"), splits, partitions):
print(name, len(group), len(rows))train 14 70
validation 3 15
test 3 15小数据集怎样验证
样本少时,可在开发数据上用交叉验证比较方案,切分仍要尊重实体与时间;预处理必须在每折的训练子集上拟合。独立测试集足够时,保留它做最终检验。无法保留时,可用嵌套交叉验证分别做内层选择与外层评估,并说明评估的是选模流程和它的局限。用于选超参数的同一组折得分不足以当独立验收。 scikit-learn 嵌套交叉验证示例 scikit-learn 预处理和切分
本课练习
让用户 0 产生更多订单,检查组间仍无交叉,但订单比例发生变化。再画出一个按时间预测未来的划分,标出训练截止日、标签观察窗和可用于验证的最早时点。下一课观察训练如何更新参数。