
机器学习与深度学习 / 系统课时
词向量与文本表示
词向量与文本表示
模型只能处理数值,因此词语、句子和文档最终都要转换为向量。本课从 one-hot 的局限出发,理解稠密词向量、句子向量和余弦相似度,并用一个小例子观察“方向相近”如何表示语义相似。
学习目标
- 理解 one-hot、词向量和句子向量的主要区别
- 解释“语义接近的文本在向量空间中更接近”这一直觉
- 能用余弦相似度比较两个文本向量
从离散编号到稠密向量
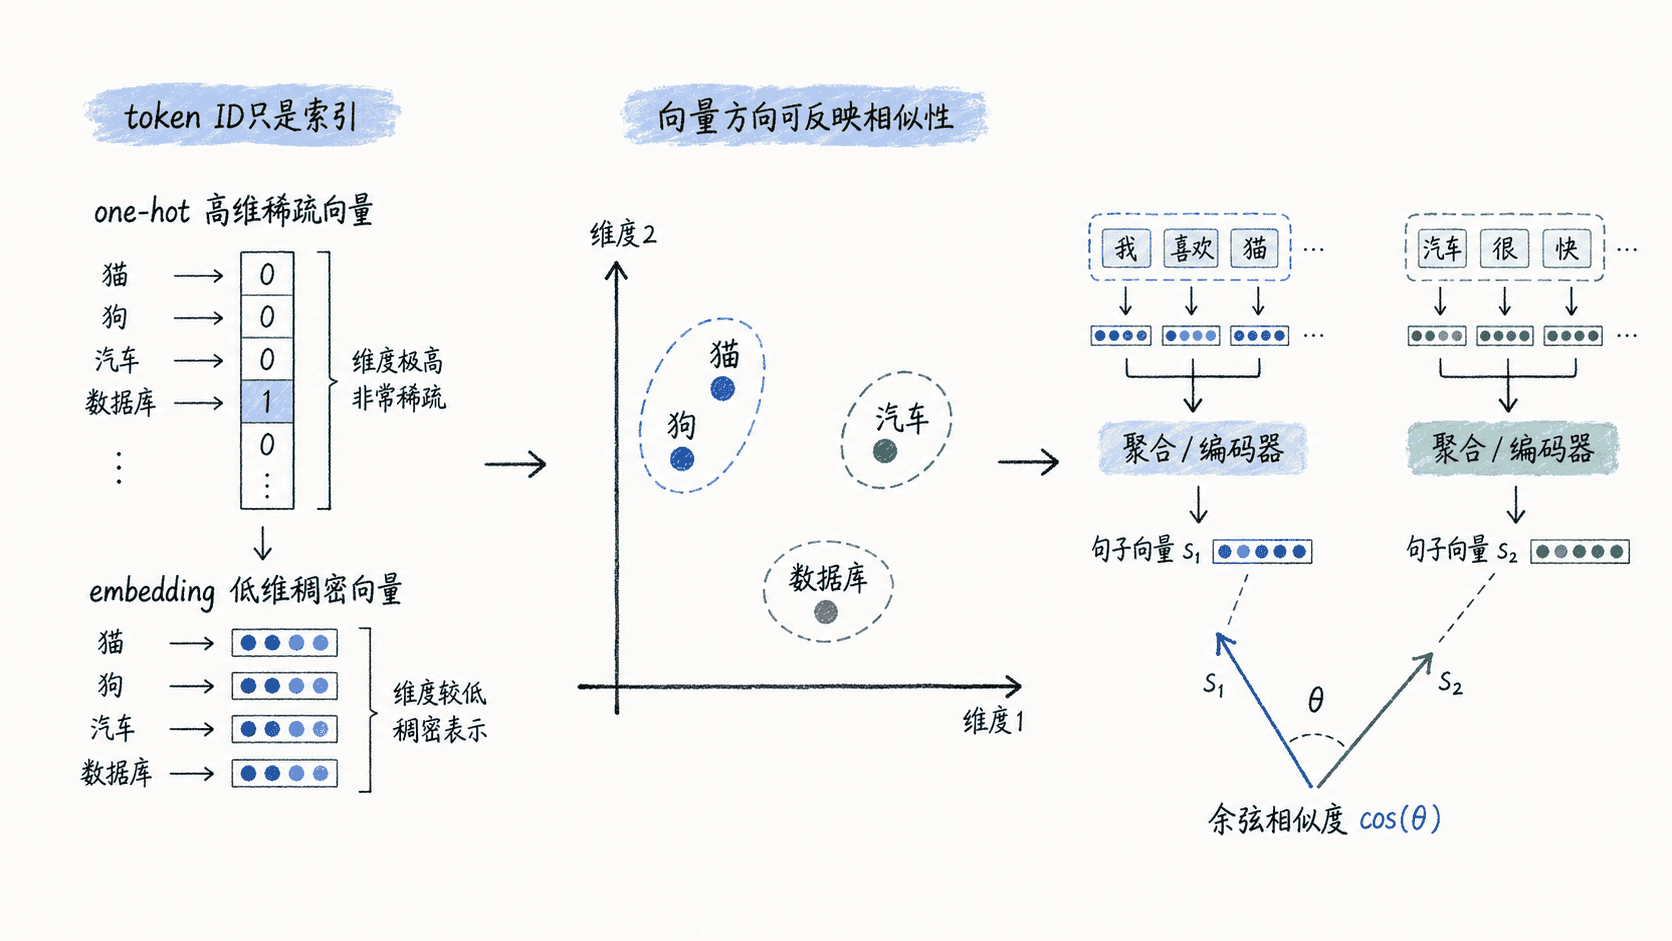
词表中的 token ID 只是索引,编号大小本身没有语义。若对词元使用 one-hot,维数等于词表大小,每个已知词元只激活自己的一个位置。不同词元的 one-hot 向量彼此正交。它能区分词,却无法直接表达“猫”和“狗”比“猫”和“数据库”更相近。
词向量(embedding)把每个词元映射到一个较低维的稠密向量。向量中的单个维度通常没有直接可解释的含义,但整体方向和距离可以承载统计与语义关系。相似上下文可能使两个词元在某些训练目标下学得相近向量,具体关系要靠任务样本验证。
句子向量如何得到
只有单词向量还不够,文本分类、语义检索和聚类往往需要一个固定长度的句子或文档向量。最简单的办法是对词向量求平均,对静态词向量这样池化会完全丢掉词序;更常见的方法是使用 Transformer 编码器,根据上下文为每个 token 生成表示,再通过特定位置、池化或专门的句向量模型得到整体向量。
静态查表会给相同词元同一个向量。经过上下文编码后,相同词元在不同句子中可以产生不同隐藏向量。例如“苹果发布新品”和“吃了一个苹果”中的“苹果”含义不同,上下文模型会利用周围词语调整其向量。
用余弦相似度比较方向
对于两个向量 和 ,余弦相似度关注夹角而不是绝对长度:
余弦范围为 [-1,1]。接近 1 表示同向,接近 0 表示近似正交,接近 -1 表示方向相反。零向量没有定义好的夹角,实际库可能提供约定值。下面用手工构造的向量复算,并用两句主客体互换的短句演示静态均值池化。
from math import fsum, hypot
from statistics import mean

def cosine(a, b):
    if not a or len(a) != len(b):
        raise ValueError("向量必须非空且等长")
    norm_a, norm_b = hypot(*a), hypot(*b)
    if norm_a == 0 or norm_b == 0:
        raise ValueError("零向量的方向未定义")
    return fsum((x / norm_a) * (y / norm_b) for x, y in zip(a, b))

def average_embedding(words, vectors):
    return tuple(mean(values) for values in zip(*(vectors[word] for word in words),
                                                strict=True))

vectors = {"猫": (1, 0), "追": (1, 1), "狗": (0, 1)}
left = average_embedding(["猫", "追", "狗"], vectors)
right = average_embedding(["狗", "追", "猫"], vectors)
print(f"方向接近: {cosine([1, 1, 0], [0.9, 1.1, 0.1]):.3f}")
print("词序互换后的平均向量相等:", left == right)
首行输出 0.993。第二行输出 True,静态平均只保留词元的计数,无法区分“猫追狗”和“狗追猫”。上下文编码后的向量再做池化时,每个词元向量已经受上下文影响,不能直接套用这个结论。
相似不等于完全同义
向量相似度来自模型训练数据和目标函数,因此“距离近”表示模型认为两个表示在某种统计意义上接近,并不保证它们逻辑上等价。反义词因为经常出现在相似上下文中,也可能获得较高相似度;通用 embedding 在专业术语上也可能失真。
词向量解决“把离散符号变成可学习的连续表示”,句子向量进一步把整段文本压缩到统一空间。后续的分类、聚类和语义检索,本质上都建立在这些数值表示之上。