
机器学习与深度学习 / 系统课时
检索增强生成
检索增强生成
检索增强生成(RAG)将问题相关的外部资料放到生成模型可见的上下文中。它可以减少依赖模型记忆的情况,也为答案提供可核对的证据。结果取决于检索到的内容、内容是否适用、上下文组织和模型是否正确使用了证据。 RAG 原论文
学习目标
- 描述从文档切分、索引、检索到答案和引用的流程。
- 用本地代码实现可拒答的简单检索,并限制引用范围。
- 分开诊断召回、时效、权限和答案支持性。
从文档到回答
| 环节 | 主要工作 |
|---|---|
| 摄取与建索引 | 保留文档、版本、章节、更新时间、片段 ID 和授权范围。切片需尽量保留适用条件和必要的标题上下文 |
| 检索与重排 | 按可信会话权限和有效版本限定候选,再用关键词、向量或组合方式找相关片段。重排改善候选顺序,无法补回完全没召回的片段 |
| 组装上下文 | 按相关性、版本和上下文预算选片段,保留来源。把资料作为数据传给模型,资料中的指令不能改变权限或调用规则 |
| 生成与检查 | 要求来源和证据不足时的行为,校验引用 ID 属于本次授权结果,再检查资料是否支持每项重要陈述 |
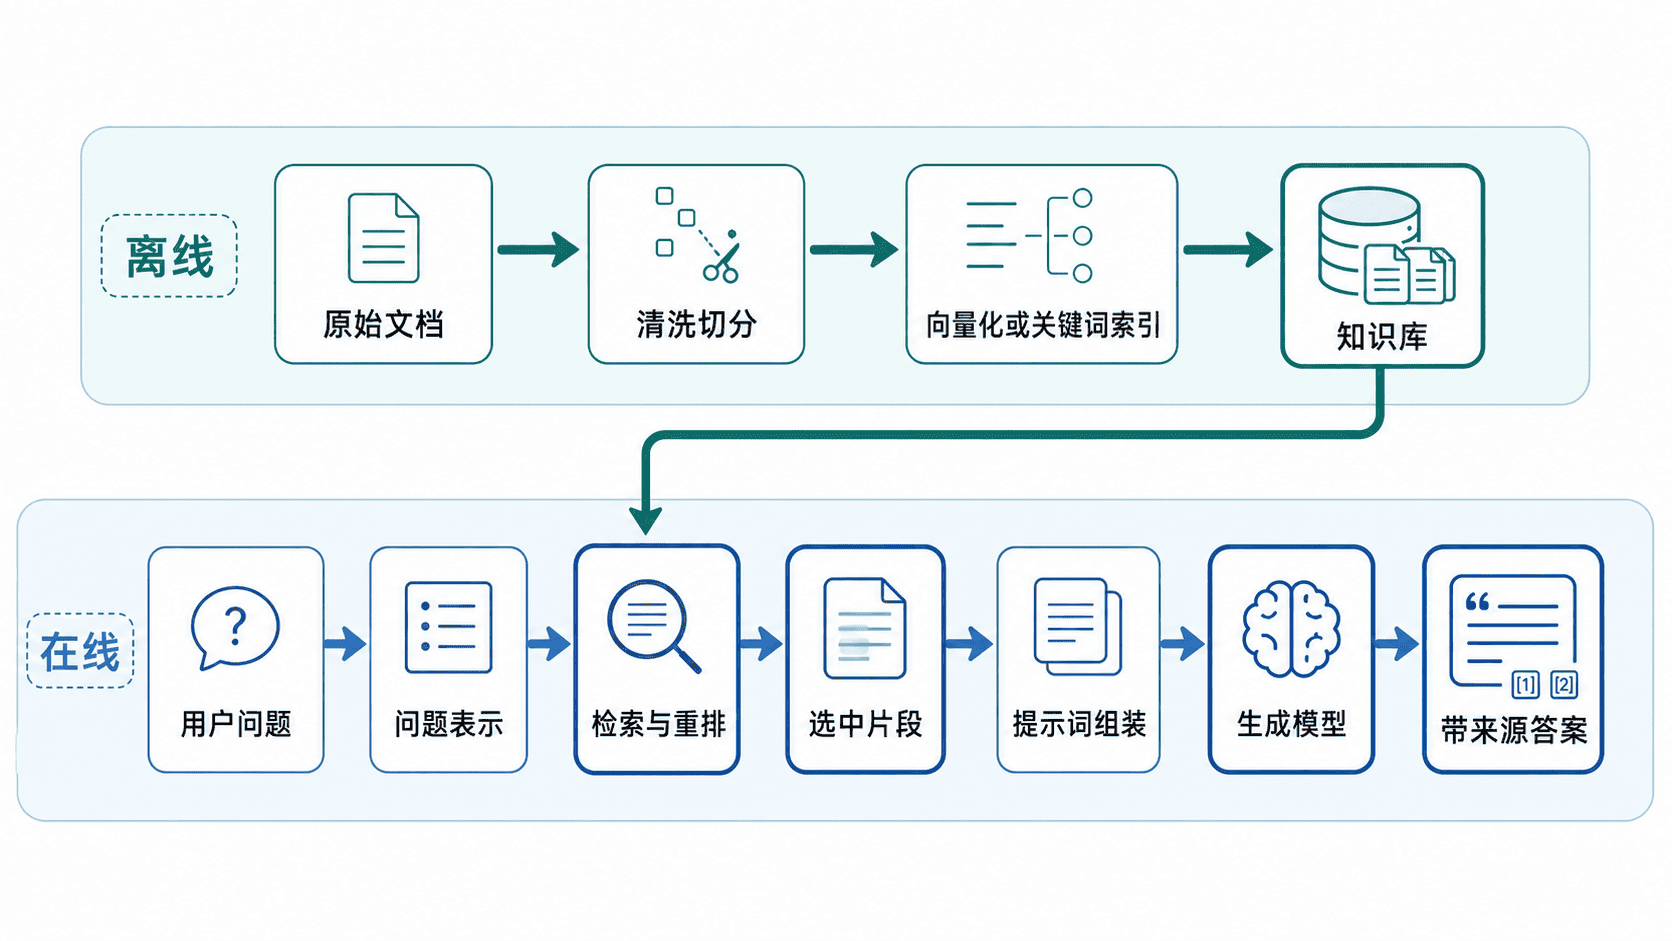
访问范围应由可信服务根据身份和资源授权决定。索引需要隔离或具备可实施的授权过滤,避免先在跨租户候选中排序再仅靠提示词隐藏片段。召回到可信来源也不表示片段文字是可信指令。文档、用户与模型输出应各自按其来源边界处理。 OWASP 向量与嵌入风险 OWASP 提示注入风险
最小可运行检索:过滤、排序与证据范围
下面是一个虚构客服库。用字符及英数字词的集合 Jaccard 相似度近似相关度,只在可访问且有效的片段里排序。阈值仅是合成数据中的演示值。代码不调用模型;有结果时列出可进入提示的片段,没结果时返回资料不足。示例的 audiences 模拟服务根据身份计算的权限集合。
import re
import unicodedata
from dataclasses import dataclass


@dataclass(frozen=True)
class Chunk:
    ref: str
    text: str
    audience: str
    current: bool = True


index = [
    Chunk("refund@v2#1", "订单退款到账通常需要 1 到 3 个工作日。", "public"),
    Chunk("refund@v1#1", "订单退款到账通常需要 7 个工作日。", "public", False),
    Chunk("refund@staff#1", "订单退款多久到账?员工特殊渠道另有规定。", "staff"),
    Chunk("invoice@v1#1", "电子发票在订单完成后下载。", "public"),
]


def terms(text):
    normalized = unicodedata.normalize("NFKC", text).casefold()
    return set(re.findall(r"[一-鿿]|[a-z0-9]+", normalized))


def similarity(left, right):
    union = left | right
    return len(left & right) / len(union) if union else 0.0


def retrieve(question, audiences, chunks=index, limit=2):
    query = terms(question)
    allowed = [chunk for chunk in chunks if chunk.current and chunk.audience in audiences]
    ranked = [(similarity(query, terms(chunk.text)), chunk) for chunk in allowed]
    ranked.sort(key=lambda entry: (-entry[0], entry[1].ref))
    return [chunk for score, chunk in ranked if score >= .15][:limit]


def citations_in_context(refs, context):
    return bool(refs) and set(refs) <= {chunk.ref for chunk in context}


context = retrieve("订单退款多久到账?", {"public"})
print("public sources:", [chunk.ref for chunk in context])
print("context:", context[0].text if context else "资料不足")
print("staff ref accepted:", citations_in_context(["refund@staff#1"], context))
unknown = retrieve("火星有几个太阳?", {"public"})
print("unmatched:", "资料不足" if not unknown else [chunk.ref for chunk in unknown])public sources: ['refund@v2#1']
context: 订单退款到账通常需要 1 到 3 个工作日。
staff ref accepted: False
unmatched: 资料不足字符集合丢失词序和否定关系,也没有涵盖所有文字字符。真实系统可采用分词与倒排索引、语义向量或混合检索,并用实际问题验证阈值和结果。检索分数较高也不能证明内容准确。示例的引用检查只确认 ID 属于本次上下文,还要判断原文是否真正支持回答。 RAG 原论文
出错时怎样定位
先查看该身份和时间点应该能访问的文档。若正确片段未召回,检查权限、版本、切片、查询与索引。若找到了资料但生成仍错,检查片段是否因长度被裁掉、来源是否冲突、模型是否引用正确段落或声称了资料之外的结论。用有已知证据的问答统计召回率和答案支持性,也用缺证据、过期、越权和注入样本测试拒答边界。文档失效时要同步更新索引和相关缓存,权限与版本变化应影响缓存复用。 OWASP 向量与嵌入风险 OWASP 提示注入风险
本课练习
将查询换成空字符串和标点,检查结果为空。再用可信服务派生的员工身份查询,对比可见的片段。尝试让回答引用过期编号,说明引用检查能够判定什么。下一课将说明模型何时可通过受控接口调用工具。