
机器学习与深度学习 / 系统课时
向量与矩阵
向量与矩阵
房屋表格的每行有一组固定输入。本课用三套房屋展示一条记录怎样成为向量、整批怎样成为矩阵,以及权重怎样把它们映射为一个或多个结果。示例沿用上一节三数值列与两区域列的顺序,为便于手算,数值列保留原单位,使用专门为本例选的权重。
学习目标
- 区分向量分量、样本轴、特征轴和批量输入形状。
- 推导单输出与多输出的矩阵乘法和偏置形状。
- 发现即使代码正常运行也可能发生的特征顺序错误和广播错误。
从一行到一批
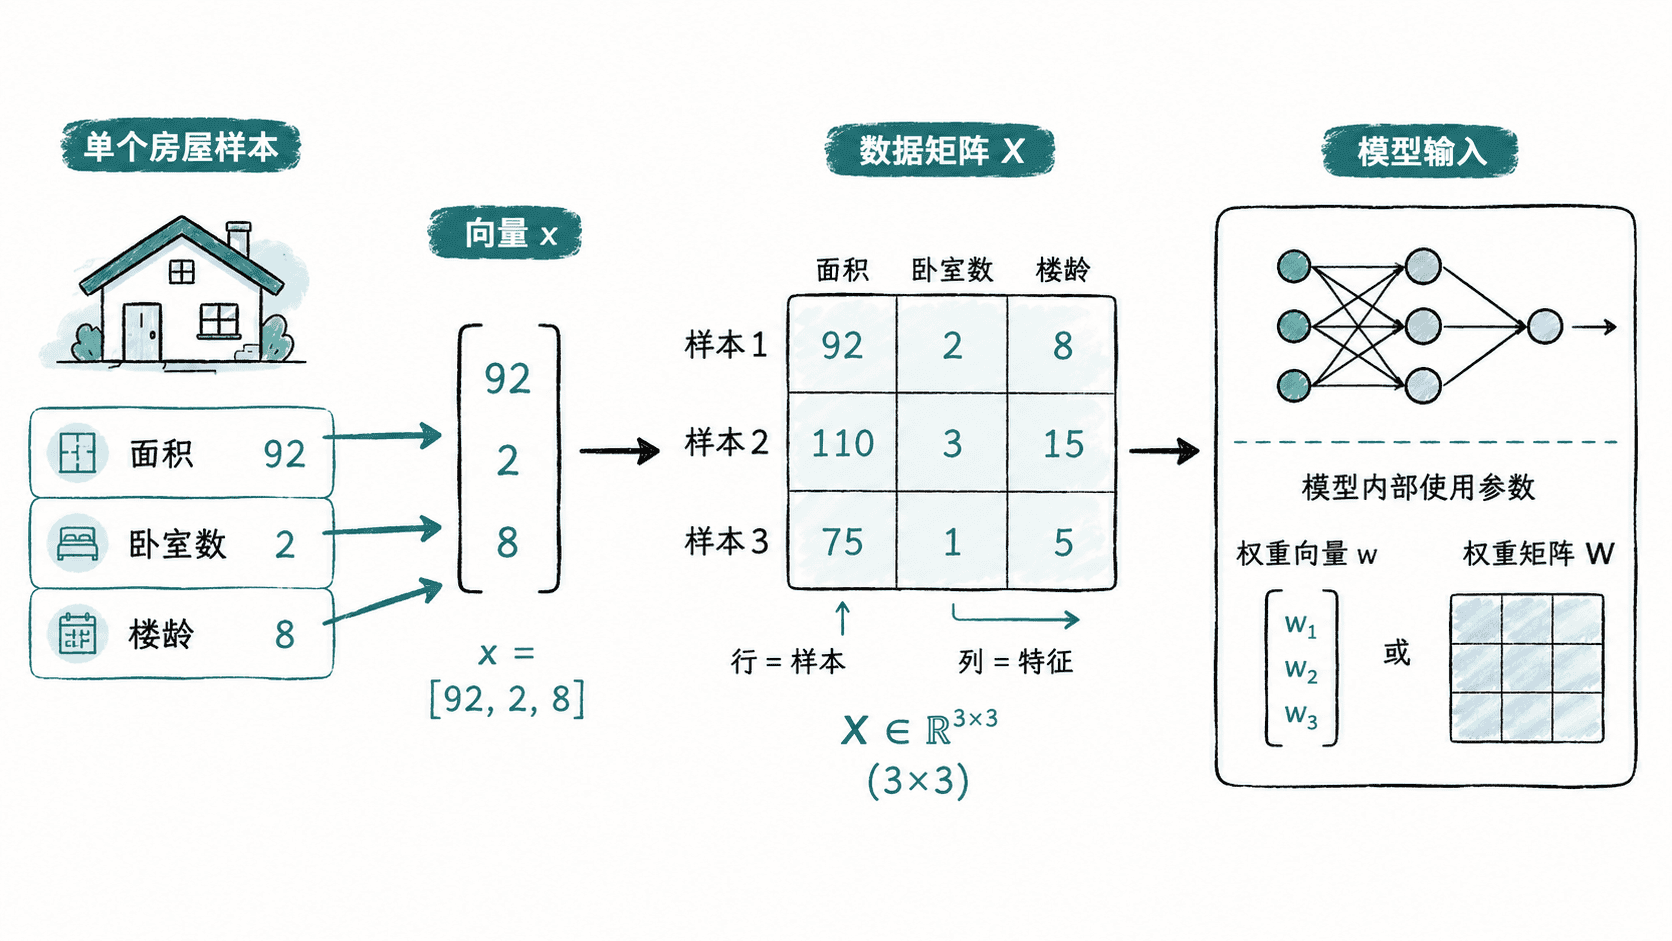
面积 92 ㎡、2 间卧室、楼龄 8 年的房屋属于 A区。把数值和区域独热列按顺序排列,得到向量 。它有五个分量。作为 NumPy 一维数组,形状是 (5,);如果接口要求保留单样本的批次轴,形状是 (1,5)。
把三条记录按行排列为 ,得到 3 行、5 列。按本课约定,一行是一套房屋的挂牌记录,一列是一种特征。一般情况下, 个样本、 个特征写成 。也有其他轴约定,因此读取输入时应同时看形状和接口规定。把本例转置成 (5,3) 会交换样本轴与特征轴。
用权重和偏置计算预测
对于单个输出,每个特征有对应权重 ,另有一个偏置 。一条样本的预测为 ,整批写成 。以 、 为例,第一条预测为 万元。权重是手选的演示值。训练中才会根据数据和损失函数更新参数;第一条算对无法据此评价预测质量。
如果每个样本需要 个输出,可用形状 (d,k) 的权重矩阵 ,每列给一个输出的权重, 的形状为 (m,k)。偏置向量形状可为 (k,),加法时沿样本轴共享。NumPy 中 @ 用于矩阵乘法,* 逐元素相乘。 NumPy 矩阵乘法形状规则
实跑形状与广播
import numpy as np


X = np.array([[92, 2, 8, 1, 0], [128, 3, 3, 0, 1], [75, 2, 15, 1, 0]])
w = np.array([3, 10, -2, 5, 0])
b = 30
y = np.array([315, 468, 252])

pred = X @ w + b
residual = pred - y
wrong_residual = pred - y[:, None]
W = np.column_stack((w, [1, 0, 0, 0, 0]))
two_outputs = X @ W + np.array([b, 0])

print("X, first row, first batch:", X.shape, X[0].shape, X[:1].shape)
print("pred:", pred.tolist())
print("residual:", residual.tolist(), residual.shape)
print("incorrect residual shape:", wrong_residual.shape)
print("two outputs:", two_outputs.shape, two_outputs[0].tolist())X, first row, first batch: (3, 5) (5,) (1, 5)
pred: [315, 438, 250]
residual: [0, -30, -2] (3,)
incorrect residual shape: (3, 3)
two outputs: (3, 2) [315, 92]示例的第二个输出直接读取面积,用来验证矩阵的列语义。当预测形状为 (3,)、标签形状为 (3,1) 时,减法会广播为 (3,3),变成各预测与各标签的两两比较。计算逐样本误差前先核对两者的形状,例如同时使用 (m,);若约定单输出仍保留输出轴,则同时使用 (m,1)。 NumPy 广播规则
形状与字段都要验证
把面积列和楼龄列互换,X.shape 仍为 (3,5),乘法也能执行,但权重会应用到错误的字段。上线要固定特征名称、顺序、单位与预处理版本。同样,计算两个向量的距离前也应确认逐列语义一致。
本课练习
- 分别预测
X[0]和X[:1],核对结果数值与形状。再尝试X.T @ w,解释为什么失败。 - 只交换面积与楼龄列,预测后比较结果。写出一个在运算之前按名称验证字段顺序的办法。
下一节会用概率描述随机事件,之后用均值、方差与距离衡量一批数据及样本之间的关系。