
机器学习与深度学习 / 系统课时
数据清洗与预处理
数据清洗与预处理
数据收集和标注完成后,先检查字段、时间和记录来源。可提前执行的是独立于数据分布的既定规则,例如按约定统一城市别名。凡要看一批样本才能学到的中位数、缩放参数、类别词表和阈值,先划分数据,再从训练子集拟合。
学习目标
- 区分格式修正、缺失、技术重复和业务上真实的极端值。
- 在划分后拟合预处理,并用同一参数处理验证、测试和生产记录。
- 检查变换后的样本覆盖率、缺失和极端值处理是否符合任务定义。
先识别问题再决定处理方式
| 现象 | 处理方式与边界 |
|---|---|
| 缺失 | 先查缺失原因并保留缺失信息。可用训练中位数填补输入字段。未得到的目标标签不能用同一套规则填成真值 |
| 重复 | 有稳定事件编号时核对是否为传输重发。同一用户的多笔订单可能都是有效记录。同事件内容冲突应调查来源,分组划分时避免重复版本跨集 |
| 极端值 | 高消费可能是真实记录,负金额可能是退款。由业务检查确认明显错误,可按固定规则标记或隔离。数据驱动的统计阈值仅在训练数据上拟合 |
| 格式不一 | 按固定规则转换城市、时区和单位,保留原值与可追溯的转换记录。根据整体频次合并稀有类别属于需要拟合的步骤 |
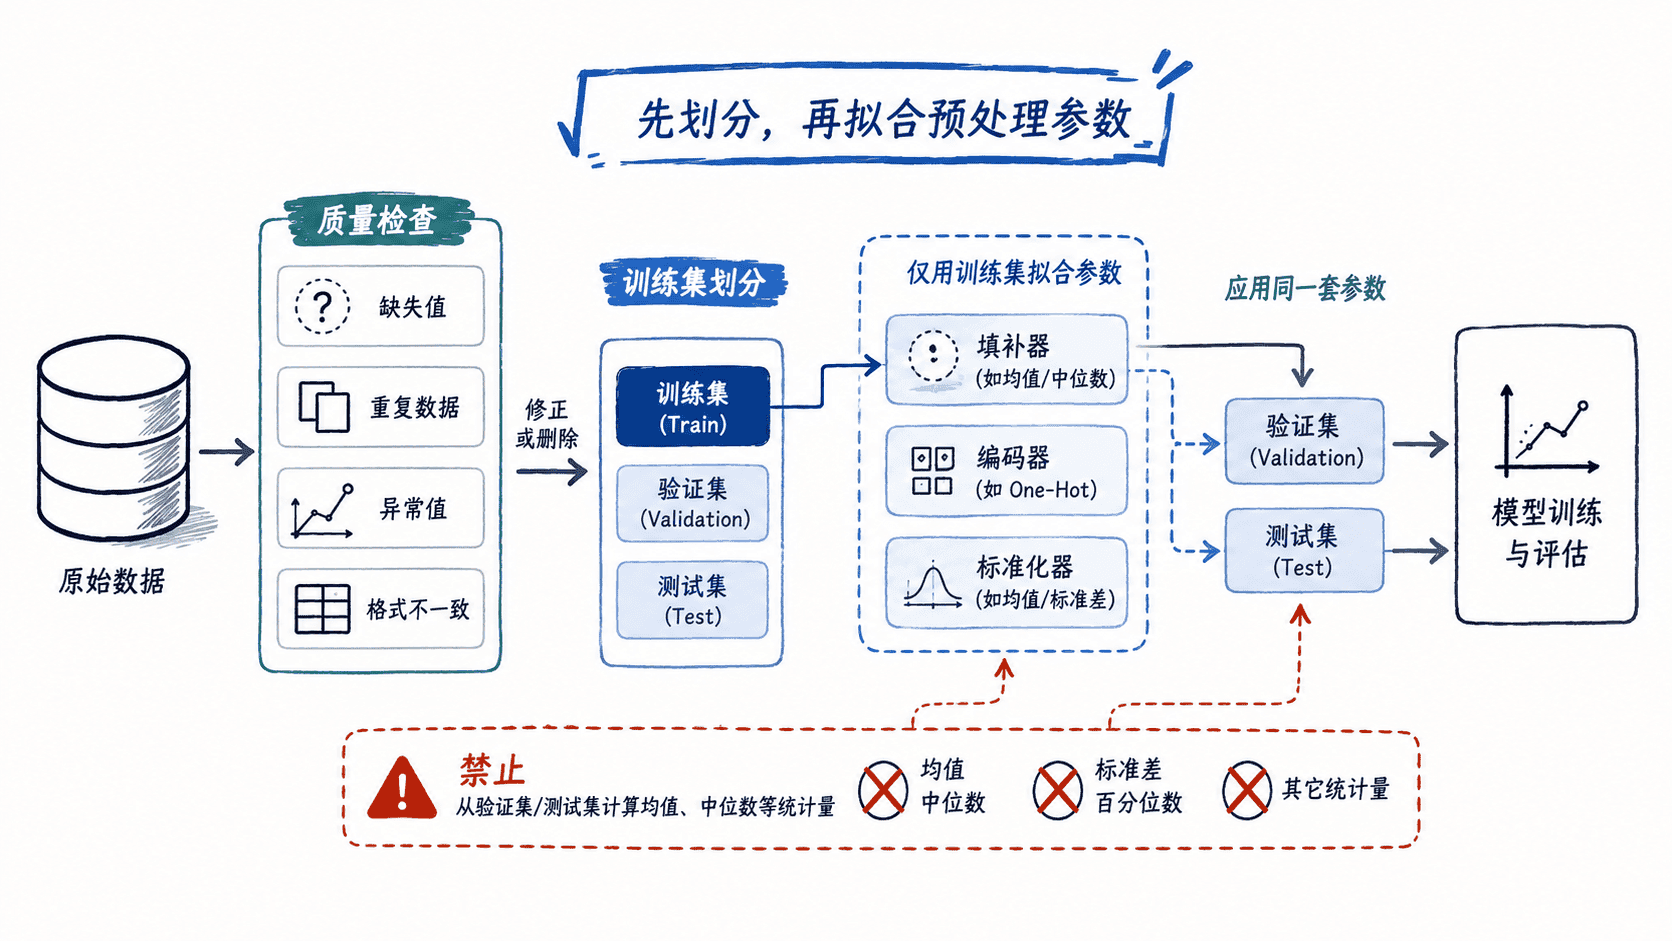
使用既定规则检查记录合法性及划分所需的组标识,可以在正式拟合之前完成。先冻结规则和数据版本,再按第 03-05 节的时间或实体约束切分。验证、测试阶段直接应用已确定的变换。交叉验证时,每一折只在该折的训练部分拟合变换和模型,Pipeline 可以把两者放进同一训练步骤。 scikit-learn 常见数据泄漏 scikit-learn 交叉验证说明
用独立数据演示拟合与应用
前几节的房价与流失案例用于定义任务,本节改用独立的合成消费数据观察清洗。下面的两组数据已经分开。用 Python 和 NumPy 在训练组估计年龄中位数、消费金额的 IQR 上界 。这里假定业务已批准将消费金额的模型输入封顶,并保留原始值及超阈标记。独立组里的高消费仍保留为一条记录。IQR 是标记极端值的启发式,少量数据不适合直接定生产阈值。
python
import numpy as np


train = [(20, " Beijing ", 100), (None, "Shanghai", 120),
         (35, "BEIJING", 130), (29, "Shanghai", 140)]
validation = [(None, " Shanghai ", 5000), (50, "Beijing", 125)]


def fit_preprocess(rows):
    known_age = [age for age, _, _ in rows if age is not None]
    if not known_age:
        raise ValueError("need known training ages")
    spend = [amount for _, _, amount in rows]
    q1, q3 = np.quantile(spend, [0.25, 0.75])
    return float(np.median(known_age)), float(q3 + 1.5 * (q3 - q1))


def transform(rows, params):
    median_age, upper = params
    return [
        (median_age if age is None else age, city.strip().casefold(),
         min(amount, upper), age is None, amount > upper)
        for age, city, amount in rows
    ]


params = fit_preprocess(train)
print("fit:", params)
print("validation first:", transform(validation, params)[0])
print("validation rows:", len(transform(validation, params)))
text
fit: (29.0, 158.75)
validation first: (29.0, 'shanghai', 158.75, True, True)
validation rows: 2
代码只处理示例中已通过输入校验的金额、年龄与城市。它返回用于建模的字段并保留原始行,方便复核。线上需保存拟合参数及其来源版本、缺失率、超阈比例和异常处理结果。如果实际系统有拒绝预测的规则,评估时把拒绝率与被拒样本的范围一起报出。单凭删除难例得到的分数无法表示原任务的效果。
本课练习
将验证集首行改成 9000 元并重跑,核对拟合参数和验证行数保持不变。再构造训练组年龄全缺的情况,决定是拦截、启用经批准的固定值还是删除该特征。下一课从数据来源出发确定划分方式。
按自己的节奏,确认真正理解。