
机器学习与深度学习 / 系统课时
反向传播
反向传播
前两课定义了激活与损失。本课用一个有两条分支的小计算图,说明损失如何通过链式法则影响同一个参数,以及怎样用梯度进行更新。
学习目标
- 分清前向计算、反向计算和优化器更新的职责。
- 沿单条路径乘局部导数,把同一参数的不同路径贡献相加。
- 在 PyTorch 中读取梯度,理解每次独立更新前为何通常清除旧梯度。
从预测到梯度
前向计算从输入得到隐藏量、预测和损失。反向计算从标量损失开始,按依赖关系逆向处理计算图。每一步把从后续节点收到的梯度与该运算的局部导数结合。若参数在多处使用,就把各条路径贡献相加。计算梯度所需的前向中间量由实现选择保存或重算。 PyTorch 自动微分机制
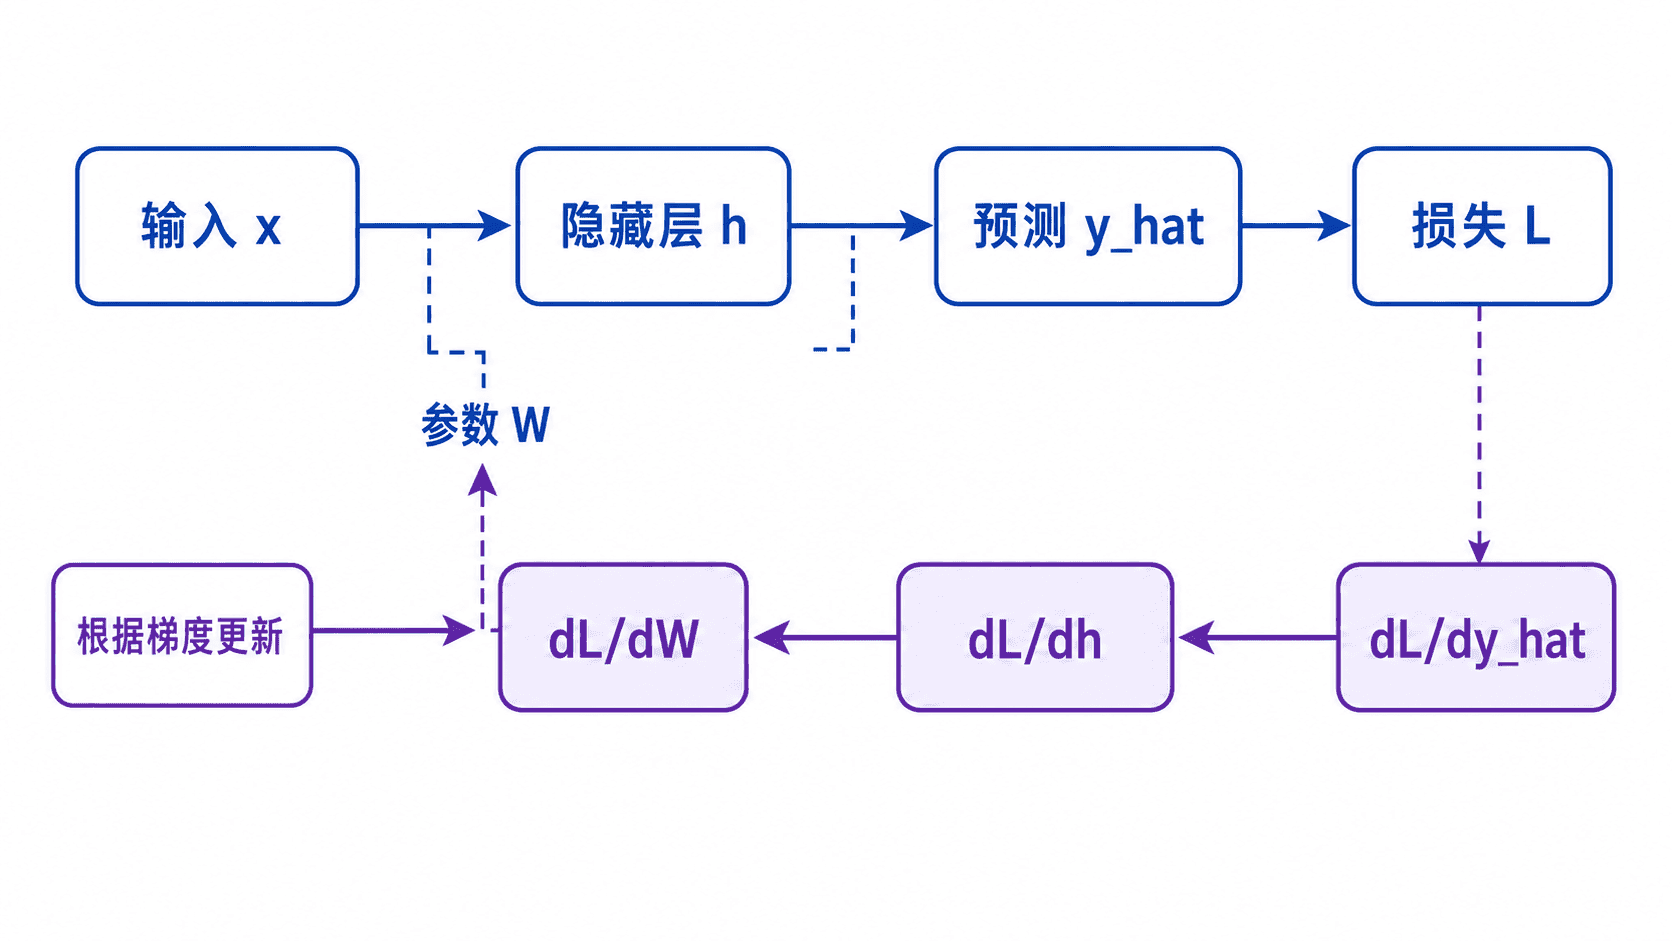
单条链 中,。若 , 同时经过 和 。对损失 ,得到 。取 、、 时,预测为 3,损失为 9。两条分支分别贡献 −12,总梯度为 −24。
用 PyTorch 实跑求导和更新
用 PyTorch 在 CPU 上运行。示例用一个标量参数,先清空旧梯度,前向计算后调用 backward(),再由 SGD 更新参数。梯度只说明当前位置的局部方向,步长过大时更新后损失可能上升。 PyTorch 自动微分机制 PyTorch 梯度清零
python
import torch


def loss(weight):
    predicted = 2 * weight + weight.square()
    return (predicted - 6).square()


w = torch.tensor(1.0, dtype=torch.float64, requires_grad=True)
optimizer = torch.optim.SGD([w], lr=0.02)
optimizer.zero_grad(set_to_none=True)
before = loss(w)
before.backward()
print(f"loss before={before.item():.4f}; gradient={w.grad.item():.4f}")
optimizer.step()
with torch.no_grad():
    print(f"updated w={w.item():.4f}; loss after={loss(w).item():.4f}")
text
loss before=9.0000; gradient=-24.0000
updated w=1.4800; loss after=0.7218
PyTorch 的叶子参数会把新的反向结果累加进 .grad。一次独立更新通常清除旧梯度。若有意跨几个小批累加,应明确总批量、损失缩放和更新时间。通常每次更新重新做前向构建计算图。no_grad() 适合这里读取更新后的损失,避免为监控再建立梯度图。 PyTorch 自动微分机制 PyTorch 梯度清零
深层计算中,一连串很小或很大的局部梯度可能使传回的梯度变小或变大。可先检查梯度范数、输入尺度和初始化。梯度裁剪可以限制大梯度,梯度过小则要从网络结构、初始化或激活等原因查起。
本课练习
把学习率改为 0.10,核对首次梯度仍是 −24,但更新后的损失大于 9。再写出只计算一条分支会得到的错误梯度,并用相邻两个权重的损失差近似检验解析结果。下一课会讨论训练下降与验证表现之间的差别。
按自己的节奏,确认真正理解。