
机器学习与深度学习 / 系统课时
异常检测
异常检测
异常检测把与参考行为不同的记录排在复核队列前面。先明确任务是从一批可能混有异常的历史记录中找离群点,还是用大体正常的历史参考识别以后出现的新情况。这两种任务的拟合和评估流程不同。 scikit-learn 离群检测与新颖性检测
学习目标
- 区分全局中心距离、近邻距离和按列标准化偏差。
- 分离参考、阈值校准和待检测数据,避免极端点改变自己的基准。
- 从分数、阈值和复核结果解释检测,并识别多簇、尺度和长尾限制。
三种观察方式
| 视角 | 可以怎样打分 | 容易误判的情形 |
|---|---|---|
| 全局距离 | 到参考中心的欧氏距离 | 正常数据有多个彼此相隔的簇,某个正常小簇远离全局中心 |
| 近邻距离 | 到参考中最近的 个点的平均距离 | 合法的稀疏群体也可能得高分。它是邻域疏密的代理;LOF 还会比较邻居本身的局部密度 |
| 统计偏差 | 用参考均值和标准差算每列的绝对 Z 分数,再取最大值 | 偏斜、长尾、离群点污染、常量列和相关特征都可能影响解释。这里的 Z 分数不直接给出异常概率 |
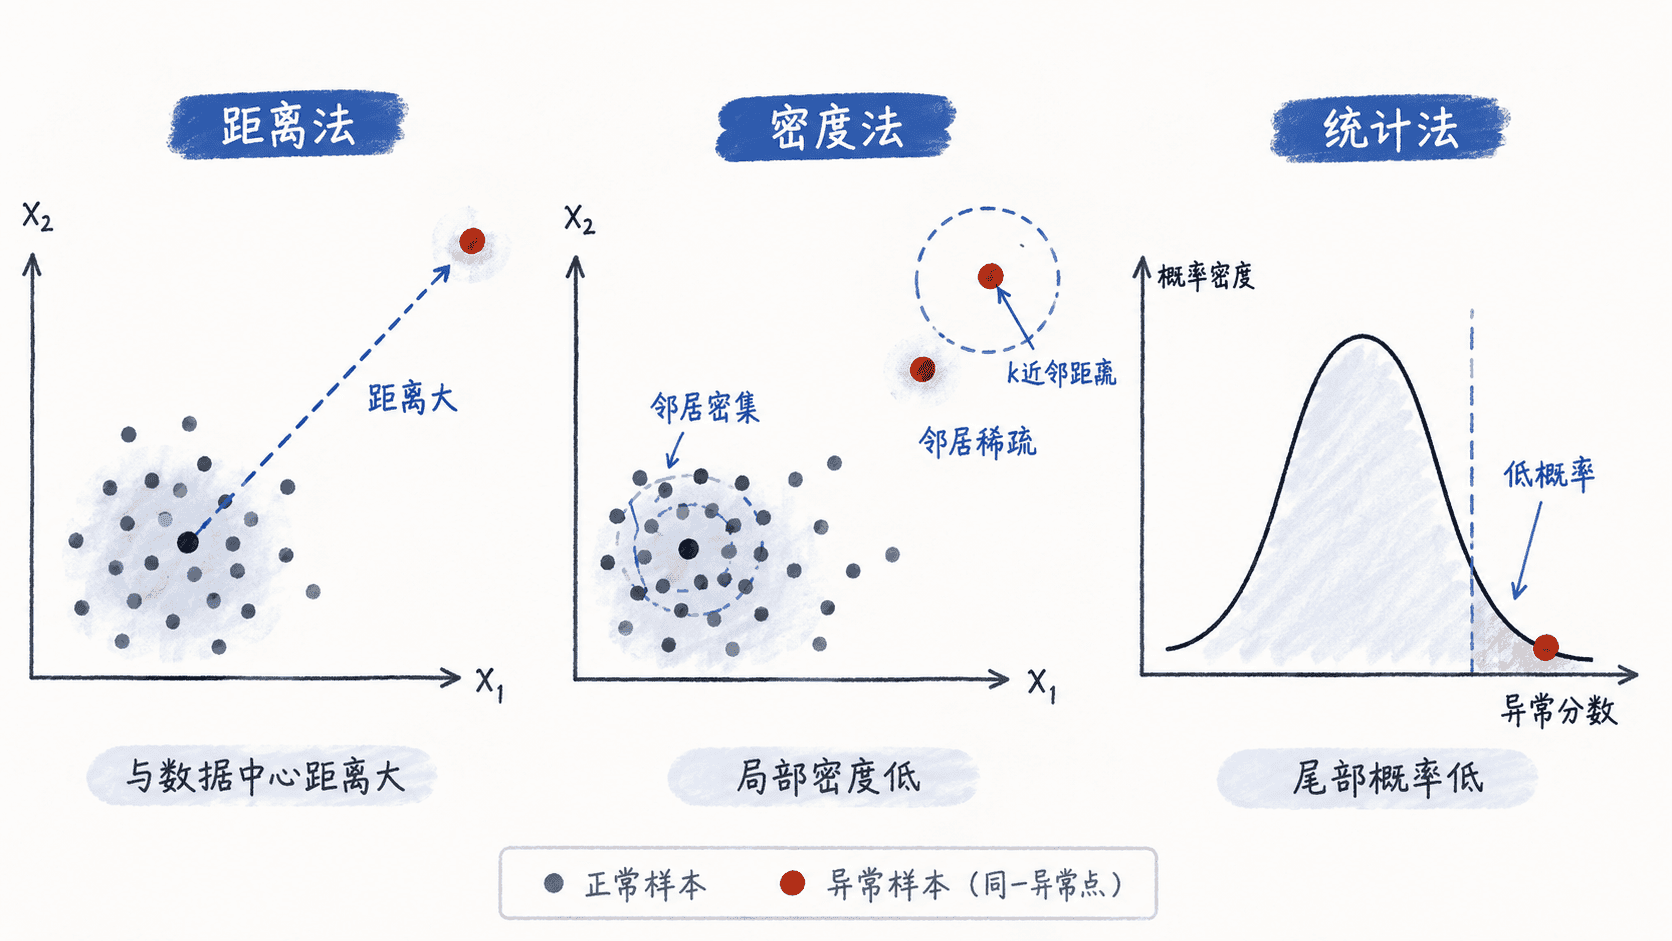
距离和统计量需要参考数据的尺度、单位与特征顺序。可考虑用稳健的中位数与 MAD 处理长尾,但 MAD 也可能为零。距离方法中,重复样本可能压低近邻距离,需按数据来源检查。不同算法的分数方向和尺度不同,应该按相应模型校准阈值。scikit-learn 的 LOF 默认用于训练批的离群检测;设 novelty=True 后,预测和打分方法应施用于新样本。 scikit-learn 异常检测接口 SciPy 中位数绝对偏差
实例:用独立参考找新异常
八个已假定正常的点是参考组。再拿四个独立的正常小样作校准,把它们最大的近邻分数当作示例阈值,最后检测两条新记录。四条校准数据只能演示流程,不足以估计真实误报率。这里在同量纲的二维空间计算,使用 NumPy 与 scikit-learn。
import numpy as np
from sklearn.neighbors import NearestNeighbors


reference = np.array([[0.0, 0.2], [0.2, -0.1], [-0.2, 0.0], [0.1, 0.1],
                      [-0.1, -0.2], [0.3, 0.0], [-0.3, 0.2], [0.0, -0.3]])
calibration = np.array([[0.0, 0.0], [0.15, -0.10], [0.2, 0.2], [-0.2, -0.1]])
incoming = np.array([[0.1, 0.05], [8.0, 8.0]])
center = reference.mean(axis=0)
std = reference.std(axis=0)
if np.any(std == 0):
    raise ValueError("review constant reference columns before using z-scores")
neighbors = NearestNeighbors(n_neighbors=3).fit(reference)


def scores(points):
    distances, _ = neighbors.kneighbors(points)
    return {
        "center": np.linalg.norm(points - center, axis=1),
        "neighbors": distances.mean(axis=1),
        "z": np.max(np.abs((points - center) / std), axis=1),
    }


threshold = scores(calibration)["neighbors"].max()
incoming_scores = scores(incoming)
print("largest-score row:", {name: int(np.argmax(s)) for name, s in incoming_scores.items()})
print(f"neighbor threshold: {threshold:.3f}")
print("neighbor scores:", np.round(incoming_scores["neighbors"], 3).tolist())
print("needs review:", (incoming_scores["neighbors"] > threshold).tolist())largest-score row: {'center': 1, 'neighbors': 1, 'z': 1}
neighbor threshold: 0.188
neighbor scores: [0.137, 11.15]
needs review: [False, True]近邻从参考组查找,校准和新记录都不加入参考索引。样本数必须至少达到 ;若改成给参考组自身评分,需要排除查询点与自身的匹配,并重新设计校准方案。示例遇到零标准差停止。实际项目要调查常量列,它未来突然偏离时也可能本身就是告警信号。 NearestNeighbors 查询接口
阈值、复核和更新
真实项目在有代表性的校准数据上选择阈值。若没有可靠标签,可先按复核容量或经核查的正常分位数设起点,抽查不同分数区间来估计误报和漏报,避免只复核最高分而看不到漏掉的异常。有可靠标签时,可用独立验证和测试分别选择阈值和验收,并记录群组、季节与设备变化。高分表示相对参考少见,仍需结合业务判断是设备故障、合法变化还是数据错误。更新参考前检查新数据来源,避免把持续异常直接并入正常基准。 scikit-learn 异常检测与评估示例
本课练习
在新记录中再加一个更远点,检查已有两条的分数与阈值是否变化。再往参考组加入一个小而合法的第二簇,比较全局中心距离和近邻距离会如何排序。