
机器学习与深度学习 / 系统课时
文本处理基础
文本处理基础
文本进入模型前,通常要先变成稳定、可比较的符号序列。本课用一条简短文本贯穿规范化、分词、词表与停用词处理,重点理解每一步改变了什么,以及哪些处理不能机械套用。
学习目标
- 说清文本规范化、分词、词表和停用词的作用
- 能把一段原始文本转换为可供后续建模使用的词元序列
- 知道何时应保留大小写、标点或常见功能词
从原始文本到词元
原始文本可能有大小写差异、全角半角字符、重复空白和特殊符号。哪些差异可折叠要由任务决定。规范化的目的不是“把文本变干净”,而是让同一种表达尽量采用一致形式,例如把连续空白压缩为一个空格,或统一 Unicode 字符形式。
分词则把连续文本切成模型可以处理的基本单位,即词元(token)。英文可以按单词或子词切分;中文没有天然空格边界,常见方法包括词语切分、单字切分和子词切分。现代大模型通常使用子词词元,而不是简单按“一个汉字一个词”处理。
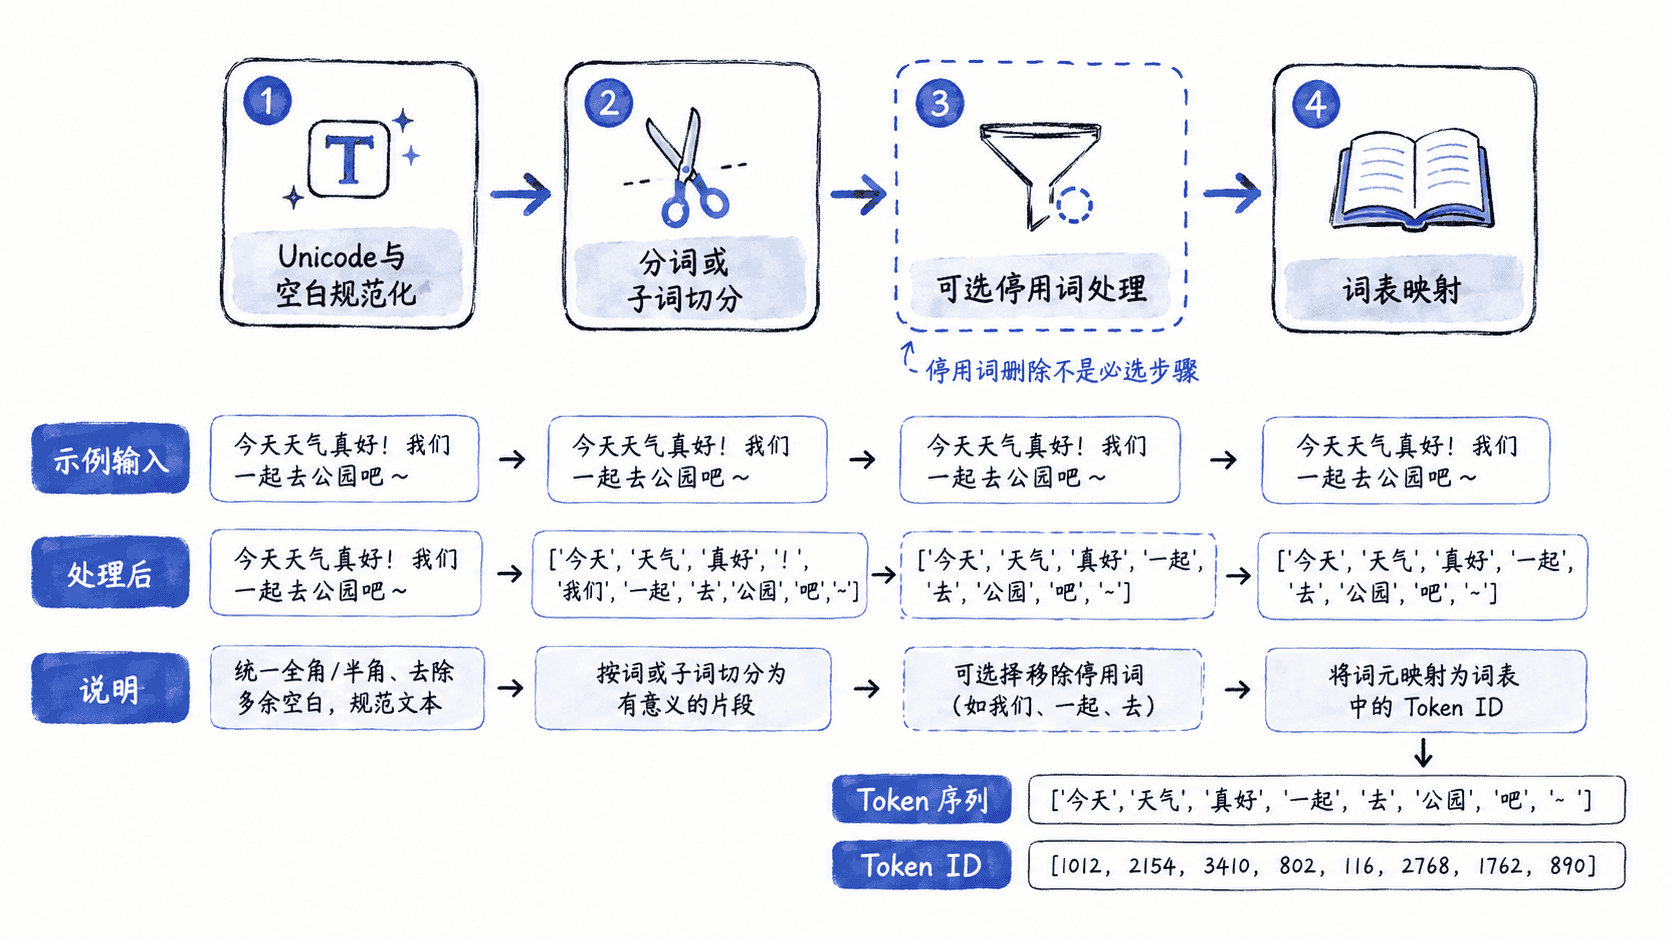
词表把符号变成编号
词表(vocabulary)维护“词元到整数 ID”的映射。例如“人工智能”在某个分词器中可能是一个词元,也可能分成多个子词或字节相关词元。编码所得序列的每个词元都有对应 ID,再由模型查找嵌入。传统词级词表遇到未登录词时容易失败,子词词表则可以把生僻词拆成更小片段,降低未知词问题。
用 Python 标准库演示三步。NFKC 将本例的全角形式转成常见形式,casefold 折叠大小写。正则把连续字母、数字或下划线视为同一段,保留非空白标点。本例恰好在“增长”后有空白;正则不会自动确定连续中文的词语边界。
import re
from unicodedata import normalize

vocab = {"[UNK]": 0, "ai": 1, "增长": 2, "20": 3, "%": 4}

def encode_text(text):
    normalized = " ".join(normalize("NFKC", text).casefold().split())
    tokens = re.findall(r"\w+|[^\w\s]", normalized)
    ids = [vocab.get(token, vocab["[UNK]"]) for token in tokens]
    return normalized, tokens, ids

for part in encode_text("  AI   增长 20%!  "):
    print(part)
规范化字符串为 ai 增长 20%!。词元依次是 ai、增长、20、%、!,ID 为 [1, 2, 3, 4, 0]。教学词表没有 !,因此保留该位置并输出未知词 ID 0。生产 tokenizer 的未知词、字节回退或特殊符号规则由具体模型确定。
停用词不是越删越好
停用词是高频但在某些任务中区分度较低的词,例如英文中的 the、is。在传统关键词检索或词袋模型中,删除一部分停用词可能减少噪声;但在情感分析、问答和大语言模型中,功能词、否定词与语序都可能影响含义,随意删除会损失信息。
规范化也有边界
大小写、数字、标点和特殊符号有时本身就是特征。例如实体识别可能需要保留大小写,代码模型必须保留标点,金融文本中的百分号和货币符号也不能随意删除。NFKC 还可能把 ① 合并为 1 等兼容形式,大小写折叠也会丢失区分。做实体抽取或回链原文时,保存原始字符串并使用有对齐能力的 tokenizer 跟踪字符偏移,避免把规范化后的索引当成原文位置。
在现代 NLP 流程中,真正需要固定下来的通常是规范化规则、分词器版本和词表版本。还应记录词表对应的模型版本、特殊词元、截断及填充规则。改动后,用一组涵盖中文、英文、符号、空输入和长文本的回归样本比对 ID 和偏移。