
机器学习与深度学习 / 系统课时
生成式 AI 是什么
生成式 AI 是什么
生成式 AI 根据输入条件产生文本、图像、音频或代码等候选内容。分类、检索和生成可在同一个系统里组合,一个文本生成模型也可被提示输出分类标签。本课建立统一的理解框架,并说明这种能力为什么强大,同时又为什么不能等同于事实数据库或确定性程序。
学习目标
- 理解生成式 AI 与分类、预测等传统任务的核心区别
- 认识文本、图像、音频和代码生成的共同工作思路
- 能判断生成式 AI 适合解决哪些问题以及需要验证哪些风险
生成式 AI 的核心任务
很多传统机器学习系统关注“判断”。例如垃圾邮件分类器从几个已知类别中选择一个标签,房价模型输出一个数值。生成式 AI 则关注“产生”:给定输入条件后,生成一个符合所学规律的新结果。
它学习的是大量数据中的模式和关系。文本模型学习词语与上下文之间的关系,图像模型学习视觉结构与描述之间的关系,音频模型学习声音随时间变化的模式。有些生成模型不需要文字条件。模型生成的是样本或序列,内容是否新颖仍需根据任务和来源判断。
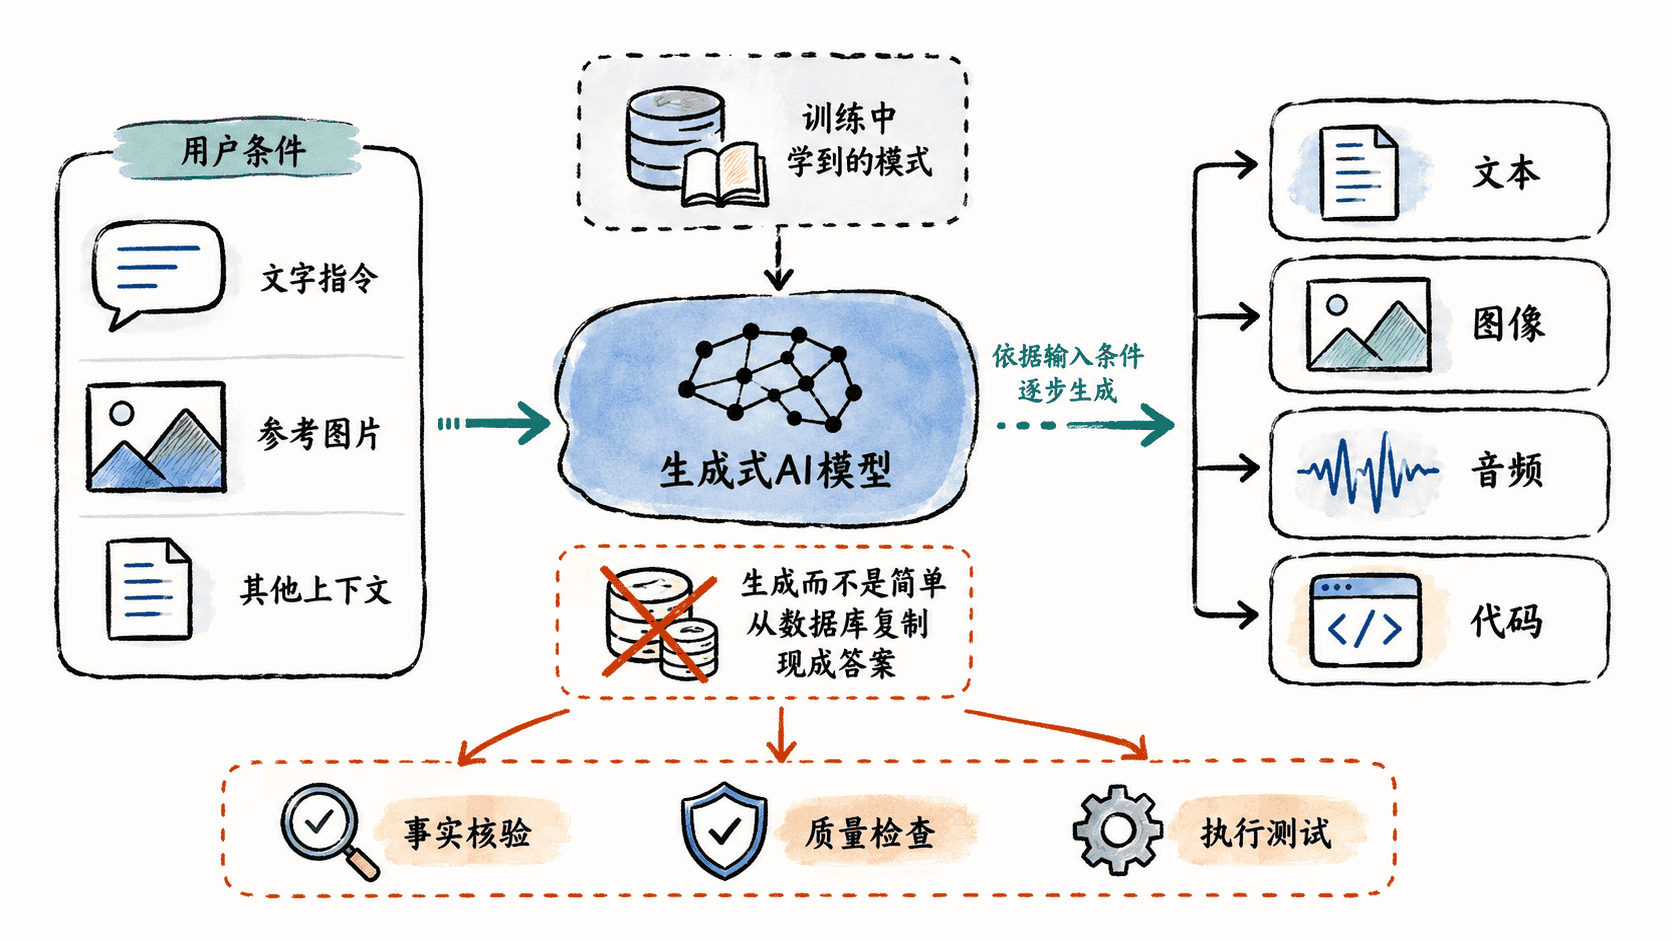
因此,“生成式”描述的是模型执行的任务类型,而不是某一种固定算法。大语言模型、图像扩散模型以及其他生成模型都可以属于这个范围。
不同模态如何生成
文本生成通常把文本表示成一系列离散单元,并根据已有上下文不断预测接下来更可能出现的内容。代码本质上也是结构化文本,因此代码模型可以采用相似方式生成语句、函数和文件内容。
图像和音频的表示方式不同。图像模型可能在压缩后的视觉表示中逐步构造画面,音频模型则需要处理声音随时间变化的信息。虽然底层机制不同,但用户看到的共同过程都是“输入条件 → 模型计算 → 生成新的内容”。
多模态系统可以让一种模态的信息影响另一种模态的结果。图像问答接收图像和文字并输出文字,文生图接收文字并输出图像。具体可用的输入与输出模态由系统设计决定。这里的关键不是把所有数据都变成同一种表面形式,而是让不同模态的信息能够参与同一次推理和生成过程。
为什么输出看起来像创作
生成模型根据训练中学到的模式和当前输入计算候选。在采用随机采样时,同一个输入可能得到不同结果。生成过程也可能复现训练片段,尤其是被记忆的内容。文字或图片看起来新颖时,仍需按实际用途核对来源与授权。
这种开放性带来了写作、设计和编程上的灵活性,也意味着输出不是天然确定的。一个语言流畅、结构完整的回答仍可能包含错误事实;一段看似合理的代码也可能无法运行。
能力与风险要一起看
| 生成内容 | 常见用途 | 需要重点检查 |
|---|---|---|
| 文本 | 摘要、改写、问答、草稿 | 事实、引用、遗漏条件 |
| 图像 | 概念图、创意草图、视觉方案 | 细节真实性、文字、版权边界 |
| 音频 | 语音生成、声音设计 | 内容准确性、身份与授权 |
| 代码 | 示例、重构、测试辅助 | 在隔离环境中运行指定版本,测试边界与失败分支 |
生成式 AI 最适合结果存在多个合理答案、需要快速形成初稿,并且结果能够被人或工具验证的任务。它可以显著降低从空白开始创作的成本,但不应因为输出自然流畅就跳过检查。
判断任务是否适合生成
面对一个新任务,可以先问三个问题:是否允许存在多个合理答案,模型是否拥有足够上下文,以及结果能否被可靠验证。写作提纲、界面文案、代码草稿通常很适合生成;精确财务数字、不可逆控制指令或高风险专业决策,则需要更严格的数据来源和人工审核。
例如生成一份发布说明,可要求事实字段来自已审核的变更清单,文案措辞由模型起草,再核对版本、发布日期、受影响平台和遗漏项。核对维度应对应错误后果。下一课用一个小分布展示候选如何被选中。