
机器学习与深度学习 / 系统课时
逻辑回归
逻辑回归
二分类逻辑回归为每条记录估计正类概率,再由业务阈值决定动作。下文以垃圾邮件为正类。多类别任务可采用多项逻辑回归等扩展,本课公式涉及二分类。
从线性分数到正类概率
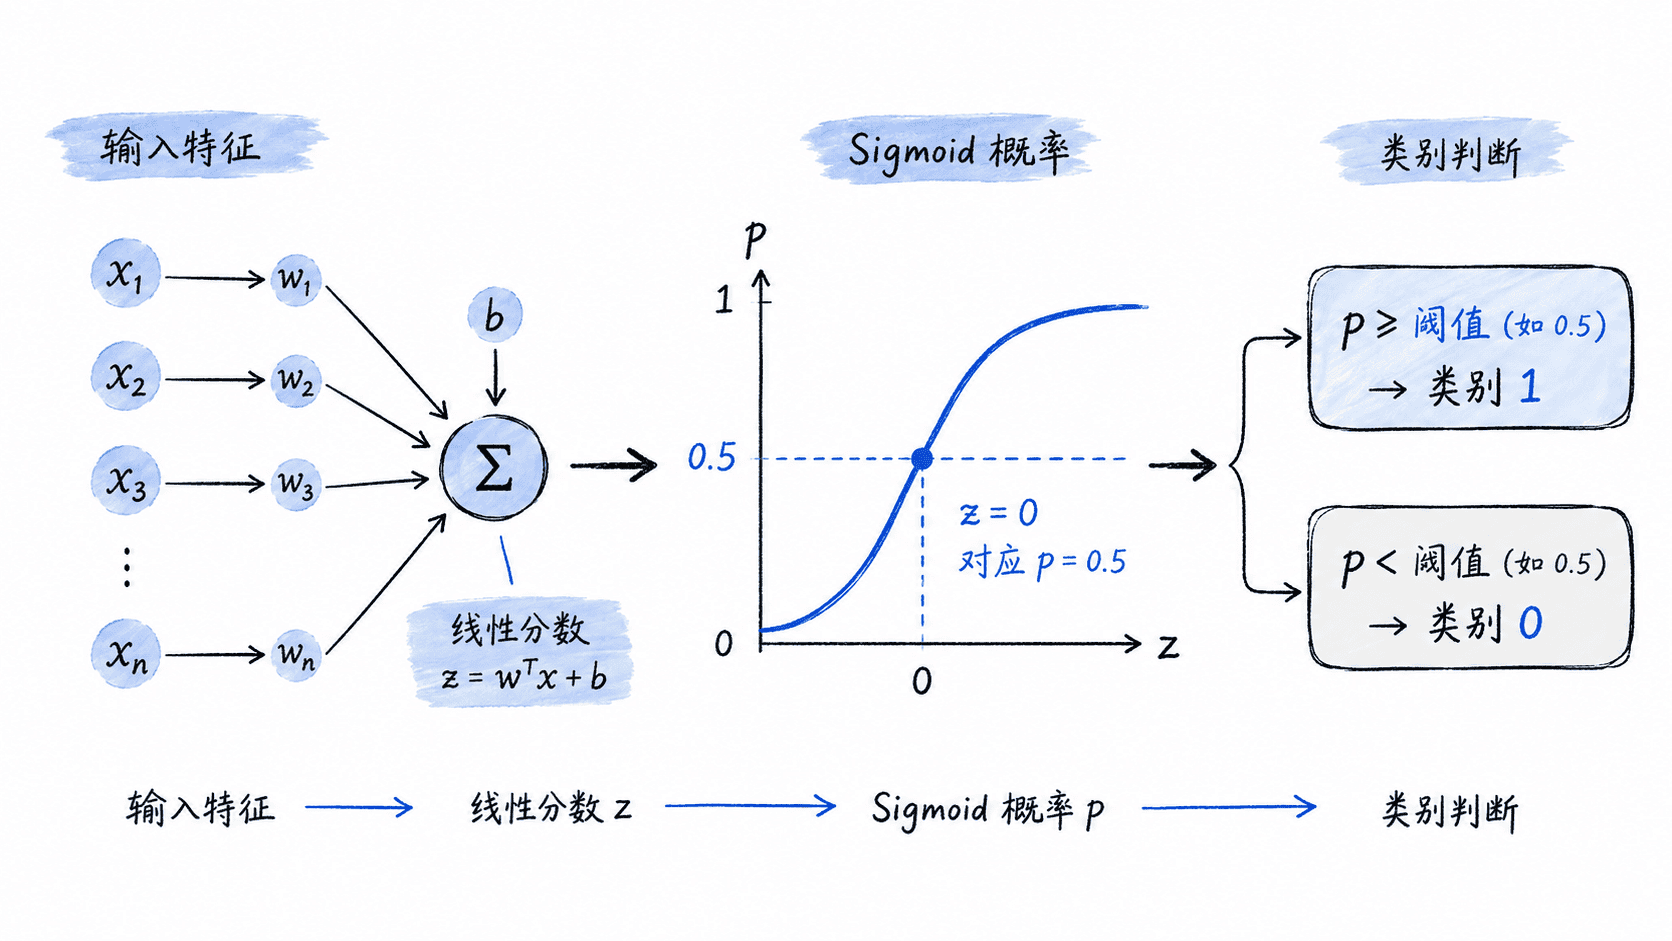
先算线性分数 ,再用 Sigmoid 映射:
有限实数 对应数学上严格介于 0 与 1 的 ,浮点计算的极端分数可以舍入成 0 或 1。 时 。每个特征系数表示其他特征固定时,该特征每增加一个单位所对应的对数几率变化。固定阈值时,决策边界对输入模型的特征是线性的。若输入含交叉项或多项式项,原始变量上的边界可弯曲。
训练损失与稳定计算
令 ,单条记录的二元交叉熵为:
正例的预测概率越接近 0,损失越大。负例的预测概率越接近 1,损失也越大。训练通常最小化平均损失,许多实现还加入正则项。若把浮点概率算到 0 或 1 再取对数,可能触发定义域错误。下例用等价的分数形式 计算损失。
python
from math import exp, isfinite, log1p

def sigmoid(z):
    if z >= 0:
        return 1 / (1 + exp(-z))
    exp_z = exp(z)
    return exp_z / (1 + exp_z)

def binary_loss(z, y):
    if y not in (0, 1) or not isfinite(z):
        raise ValueError("需要有限分数和 0 或 1 标签")
    return max(z, 0) - y * z + log1p(exp(-abs(z)))

p = sigmoid(1.4)
print(f"p={p:.3f}, 阈值0.5={int(p >= 0.5)}, 阈值0.9={int(p >= 0.9)}")
print("极端错误的损失:", binary_loss(-1000, 1), binary_loss(1000, 0))
同一个样本的 约为 0.802。阈值 0.5 会判为垃圾邮件,阈值 0.9 会判为非垃圾邮件。两个极端且方向错误的预测各得到 1000 的损失。
阈值用验证数据选
模型权重决定分数和概率估计。提高阈值会缩小正类判定集合,误报数和检出正例数都不会增加。可在验证集按误报成本、召回率下限和人工复核容量选阈值,并在独立测试集报告结果。类别严重失衡时,同时看正例比例、精确率与召回率。若要把概率用于风险定价等数值决策,还需检查校准,尤其是使用类别权重、重采样或线上分布发生变化时。下一课用可分叉的规则表达非线性关系。
按自己的节奏,确认真正理解。