
机器学习与深度学习 / 系统课时
分类评估指标
分类评估指标
第 03-07 节用两个阈值比较了同一批验证预测。本课从混淆矩阵推导准确率、精确率、召回率和 F1,并说明单个正类与多个类别的汇总口径。
学习目标
- 确定混淆矩阵的真实轴、预测轴和标签顺序。
- 用四格计数推导二分类指标,检查分母及阈值。
- 区分 micro、macro 与 weighted 平均,保留每类样本数。
从混淆矩阵开始
约定正类是设备故障(标签 1),负类是正常(标签 0)。在 scikit-learn 的混淆矩阵里,行是真实标签,列是预测标签。按 labels=[0,1] 排序后,第一行是 TN、FP,第二行是 FN、TP。使用其他工具时先读轴和标签,防止把两类错误交换。 scikit-learn 混淆矩阵定义
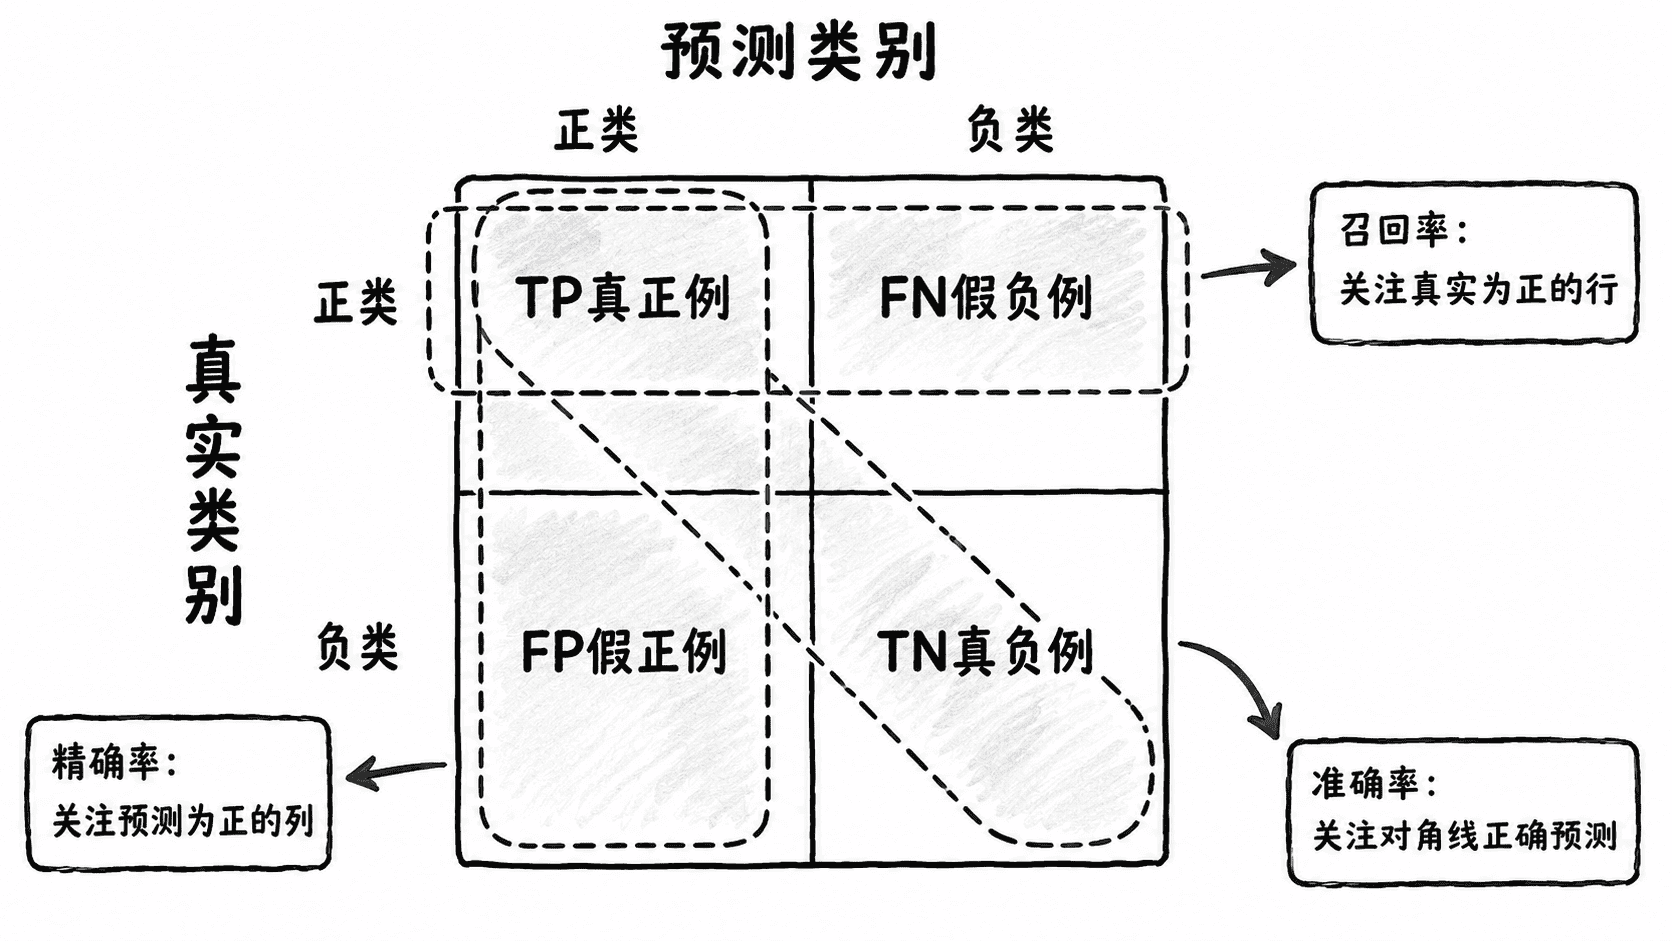
合成测试共 100 条,实际故障 20 条。正确告警 15 条,漏报 5 条,误报 10 条,正确判断正常 70 条。
| 指标 | 分母与解释 | 结果 |
|---|---|---|
| 准确率 | 正确预测数 ÷ 全部样本 | 85/100 = 0.85 |
| 精确率 | TP ÷ 预测正例数 | 15/25 = 0.60 |
| 召回率 | TP ÷ 真实正例数 | 15/20 = 0.75 |
| 假阳性率 | FP ÷ 真实负例数 | 10/80 = 0.125 |
| F1 | 2TP ÷ (2TP + FP + FN) | 30/45 ≈ 0.67 |
假阳性率表示正常记录中有多少被误报。若问告警里误报占多少,分母则是预测正例数,等于 (精确率有定义时)。F1 在精确率、召回率有定义且和非零时等于二者的调和平均,计算本身不使用 TN。预测或真实正例缺失时,分别看每个指标的分母。只有 TP、FP、FN 都为 0 时,计数公式的 F1 分母才为 0。工具可配置返回值,报告中应注明未定义和所用策略。 scikit-learn 分类评估 F1 与 zero_division 参数
阈值与类别不平衡
若分数越高越倾向正类,提高固定分数上的判定阈值会让预测正例集合缩小,TP 和 FP 都不会增加。若先排除的恰好是真阳性,精确率也可能下降。以告警复核量、漏报约束或误报成本选阈值,在验证数据上比较并冻结。仅有 10 条故障的 1000 条记录,全预测正常已有 99% 准确率,但召回率为 0。 scikit-learn 阈值调节
从单类指标到多类汇总
- macro 对选定类别分别计算指标后等权平均,少数类和多数类权重相同。
- weighted 按每类的真实样本数加权平均。多数类可能主导汇总,仍需逐类报告。
- micro 先合并各类 TP、FP、FN 再计算。单标签多分类且纳入所有类别时,micro 精确率、召回率和 F1 都等于准确率;若排除类别或使用多标签任务,不能直接套用。
报告时写明纳入哪些类别、样本数和如何处理未定义指标。zero_division=np.nan 会使未定义的项在相关平均中被排除。 scikit-learn 平均方式 F1 API
用 Python 核对计数和口径
示例用 NumPy 和 scikit-learn 1.3 或以上。二分类指定正类 1,计算不同汇总时纳入两个类别。
import numpy as np
from sklearn.metrics import accuracy_score, confusion_matrix, f1_score
from sklearn.metrics import precision_score, recall_score


y_true = [0] * 80 + [1] * 20
y_pred = [0] * 70 + [1] * 10 + [0] * 5 + [1] * 15
options = {"pos_label": 1, "zero_division": np.nan}
print("matrix:", confusion_matrix(y_true, y_pred, labels=[0, 1]).tolist())
print(f"accuracy={accuracy_score(y_true, y_pred):.3f}")
print(f"precision={precision_score(y_true, y_pred, **options):.3f}")
print(f"recall={recall_score(y_true, y_pred, **options):.3f}")
print(f"positive F1={f1_score(y_true, y_pred, **options):.3f}")
for average in ("macro", "weighted", "micro"):
    score = f1_score(y_true, y_pred, labels=[0, 1], average=average, zero_division=np.nan)
print(f"{average} F1={score:.3f}")matrix: [[70, 10], [5, 15]]
accuracy=0.850
precision=0.600
recall=0.750
positive F1=0.667
macro F1=0.785
weighted F1=0.856
micro F1=0.850本课练习
将全部预测改为正常,比较准确率、精确率、召回率和 F1。再用 5 个负例和 1 个正例构造一次精确率高但误报代价仍不可接受的评估讨论,写清复核资源与分母。下一课用同一批数值预测计算回归指标。