
机器学习与深度学习 / 系统课时
语言模型
语言模型
第 08-01、08-02 节介绍了词元和向量表示。本课聚焦因果自回归语言模型,它根据已有词元估计下一个词元的分布。还有用两侧上下文预测被遮盖词元的语言模型,例如 BERT 的掩码语言建模。两种训练目标的可见上下文不同。 Transformers 因果语言建模 BERT 原论文
学习目标
- 用条件概率分解一串词元的概率。
- 区分训练时的真实前缀、错开一位的监督标签和生成时的已有输出。
- 读懂贪心、采样、结束词元和上下文窗口的边界。
从词元到条件概率
词元可能对应子词、标点或其他片段。同一段文本在不同分词器中可有不同的词元序列。对于词元 ,概率链式法则写作 。因果语言模型估计其中的每一项。实现可用起始符或已有提示作为前缀;若要描述恰好在某处结束的完整输出,还需要包含产生结束符的概率。
在神经语言模型中,网络将词元映射为隐藏表示,输出头为词表中的各项给出 logits。沿词表轴做 Softmax 后得到模型的条件分布。分数高说明词元在当前条件下被模型赋予较大概率,无法据此确认句子为真。 Transformers 因果语言建模
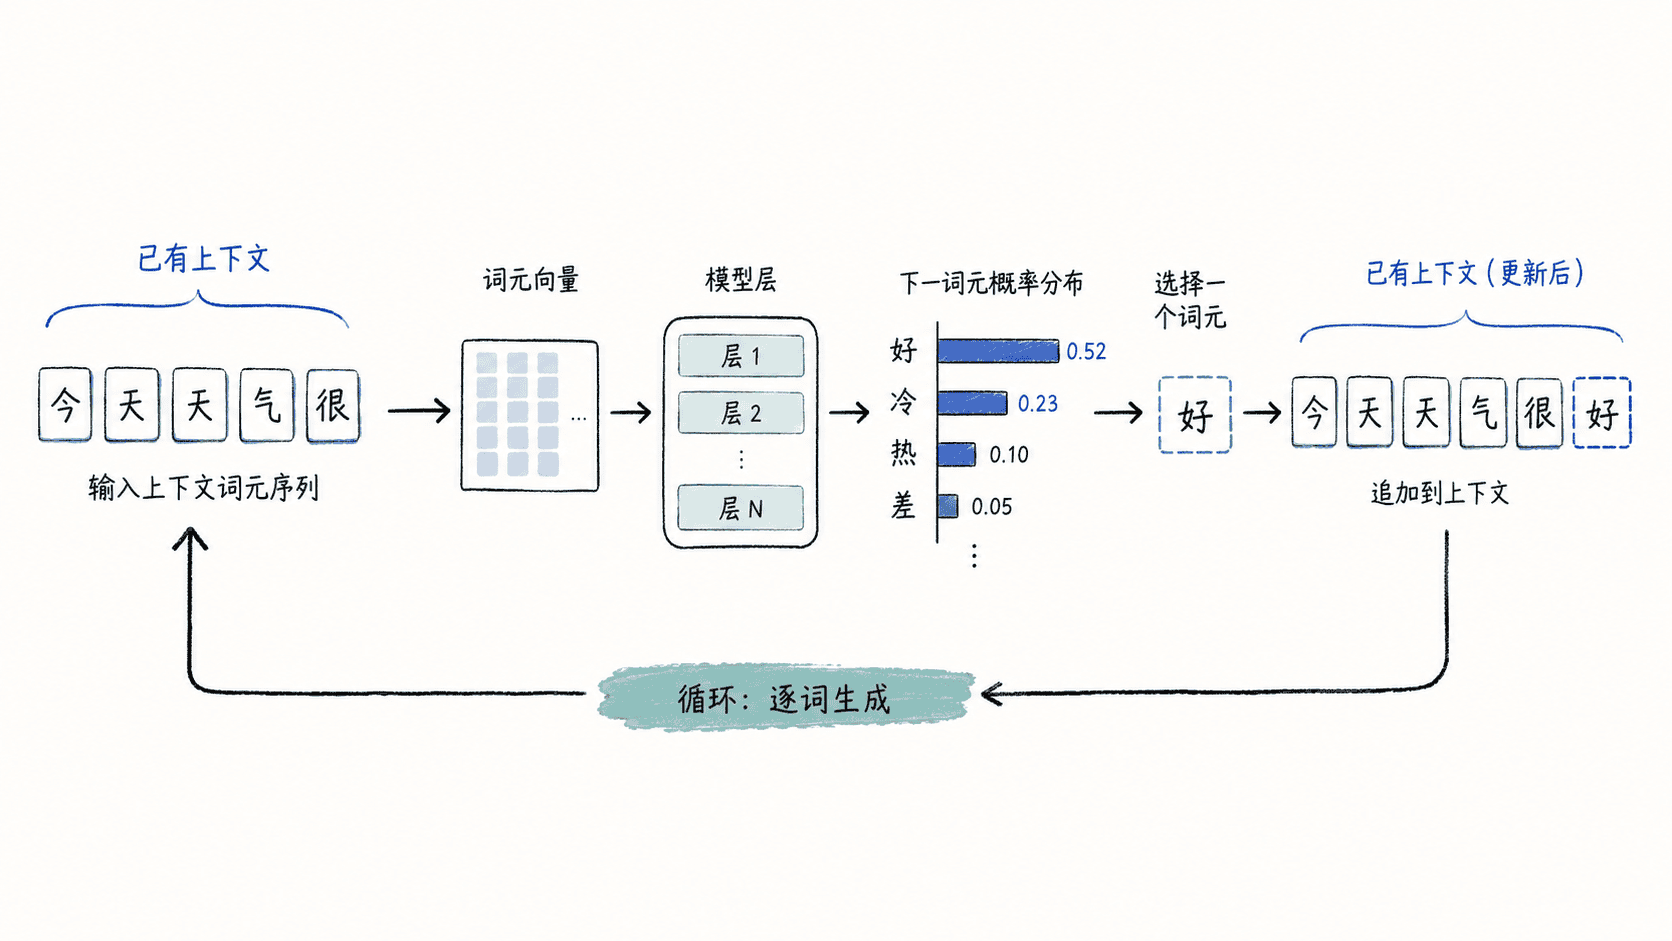
训练和生成看到的前缀
以 [起始, 雨, 停, 结束] 为例,训练输入可写成 [起始, 雨, 停],对应目标为 [雨, 停, 结束]。每个位置以真实词元为上下文,预测下一位置。部分框架让调用者传入相同的输入和标签,并在模型内部移位。使用接口时先确认由哪一层负责偏移、哪些填充位置要忽略。训练可以并行计算多个位置的损失,因为因果遮罩阻止每个位置看到未来标签。 Transformers 因果训练示例
生成时从已有提示开始,选出一个词元,将其追加到前缀,再继续预测。贪心逐步取最高分,不保证找到总概率最大的完整序列;采样则按策略从候选分布抽取。温度改变 logits 的相对尖锐程度,Top-K 和 Top-P 限制参与采样的候选范围。达到结束词元、其他停止条件或长度限制时结束。上下文超出服务或模型窗口时要按具体接口处理。 Transformers 生成参数
用 Python 计算下一词元与序列概率
下面是一阶词元转移表,只看最近一个词元,用频数估计条件概率。它无需神经网络,目的是直接观察概率、负对数损失和循环生成。真实训练常会对大量词元计算类似的损失目标;本例未平滑,没见过的转移概率为零。
from collections import Counter, defaultdict
from math import log, prod


training = [
    ("<bos>", "雨", "停", "<eos>"),
    ("<bos>", "雨", "停", "<eos>"),
    ("<bos>", "雨", "下", "<eos>"),
]
counts = defaultdict(Counter)
for sequence in training:
    for prev, next_token in zip(sequence, sequence[1:]):
        counts[prev][next_token] += 1


def distribution(prev):
    row = counts.get(prev, {})
    total = sum(row.values())
    return {token: count / total for token, count in row.items()}


def sequence_probability(sequence):
    return prod(distribution(prev).get(token, 0.0)
                for prev, token in zip(sequence, sequence[1:]))


def greedy(max_steps):
    prev = "<bos>"
    output = []
    for _ in range(max_steps):
        choices = distribution(prev)
        if not choices:
            break
        prev = max(choices, key=choices.get)
        if prev == "<eos>":
            break
        output.append(prev)
    return output


print("next after 雨:", {token: round(p, 3) for token, p in distribution("雨").items()})
print(f"complete sequence probability: {sequence_probability(training[0]):.3f}")
print(f"loss for 停: {-log(distribution('雨')['停']):.3f}")
print("greedy:", greedy(8))next after 雨: {'停': 0.667, '下': 0.333}
complete sequence probability: 0.667
loss for 停: 0.405
greedy: ['雨', '停']本课练习
再增加两条以“雨下”结束的训练序列,重算“雨”之后的分布和贪心结果。下一课将看神经网络如何按位置选择更长的上下文。