
机器学习与深度学习 / 系统课时
安全伦理与课程总结
安全伦理与课程总结
真正学会使用人工智能,不只是让模型“给出答案”,还要判断答案能不能用、该由谁负责以及出了问题怎样追溯。本节把隐私、偏见、版权、幻觉和人类监督放到同一套风险框架中,帮助你形成可执行的使用边界,并规划后续学习方向。
学习目标
- 能识别人工智能应用中常见的隐私、偏见、版权与幻觉风险。
- 能根据任务风险和可验证性决定人类监督强度。
- 能为后续学习建立“能力提升与责任边界并重”的路线。
风险不是同一种问题
人工智能风险常被笼统称为“模型不可靠”,但不同问题的来源和处理方式并不一样。隐私关注数据是否被不当收集、暴露或用于超出授权范围的目的;偏见关注训练数据、特征和评价标准是否让某些群体系统性吃亏;版权关注输入材料和生成内容的使用是否拥有合法依据;幻觉则是模型生成了看似可信但事实错误或没有证据支撑的内容。
因此,不能只问“模型准不准”。更完整的问题是:数据从哪里来、输出能否验证、错误会伤害谁、结果是否可逆,以及最终责任由谁承担。
五类风险分别怎么处理
隐私问题首先从最小化数据开始。不要因为模型“可能有用”就把完整客户资料、身份证件、密钥或内部文档全部输入;只提供完成任务真正需要的字段,并对敏感信息做脱敏、权限控制和留存限制。
偏见问题需要看分组表现,而不是只看总体准确率。例如一个分类模型总体准确率很高,但如果对某个群体的漏判率明显更高且有足够样本支持,就仍然可能造成不公平结果。高影响场景还应保留申诉、人工复核和异常监测机制。
版权问题不能简单等同于“模型生成的就是自由可用的”。使用受保护材料时,应确认授权、许可和使用范围;生成结果若高度依赖特定作品、品牌素材或受限数据库,也应在发布前进行来源和权利检查。
幻觉问题的核心是不要把流畅当成事实。凡是涉及日期、数字、引用、政策、技术参数或现实事件的内容,都应通过可靠来源、运行测试或交叉验证来确认。无法核验时,应把输出标为候选信息,而不是确定事实。
人类监督不是在模型后面机械加一道审批,而是把监督放在真正不可逆或高影响的决策点上。对高影响任务,由负责团队明确适用的业务和合规要求。设计审批时要给具备权限的复核人原始证据、复核时间和否决能力,并事先约定停用与回退条件。
用风险与可验证性决定监督强度
同一个模型,在不同任务中的使用边界可能完全不同。低风险且容易核验的任务,可以让模型直接辅助;事实性较强或中等风险的任务,应先验证再采用;高风险、不可逆或涉及价值判断的任务,应由具备责任权限的人类做最终决定。
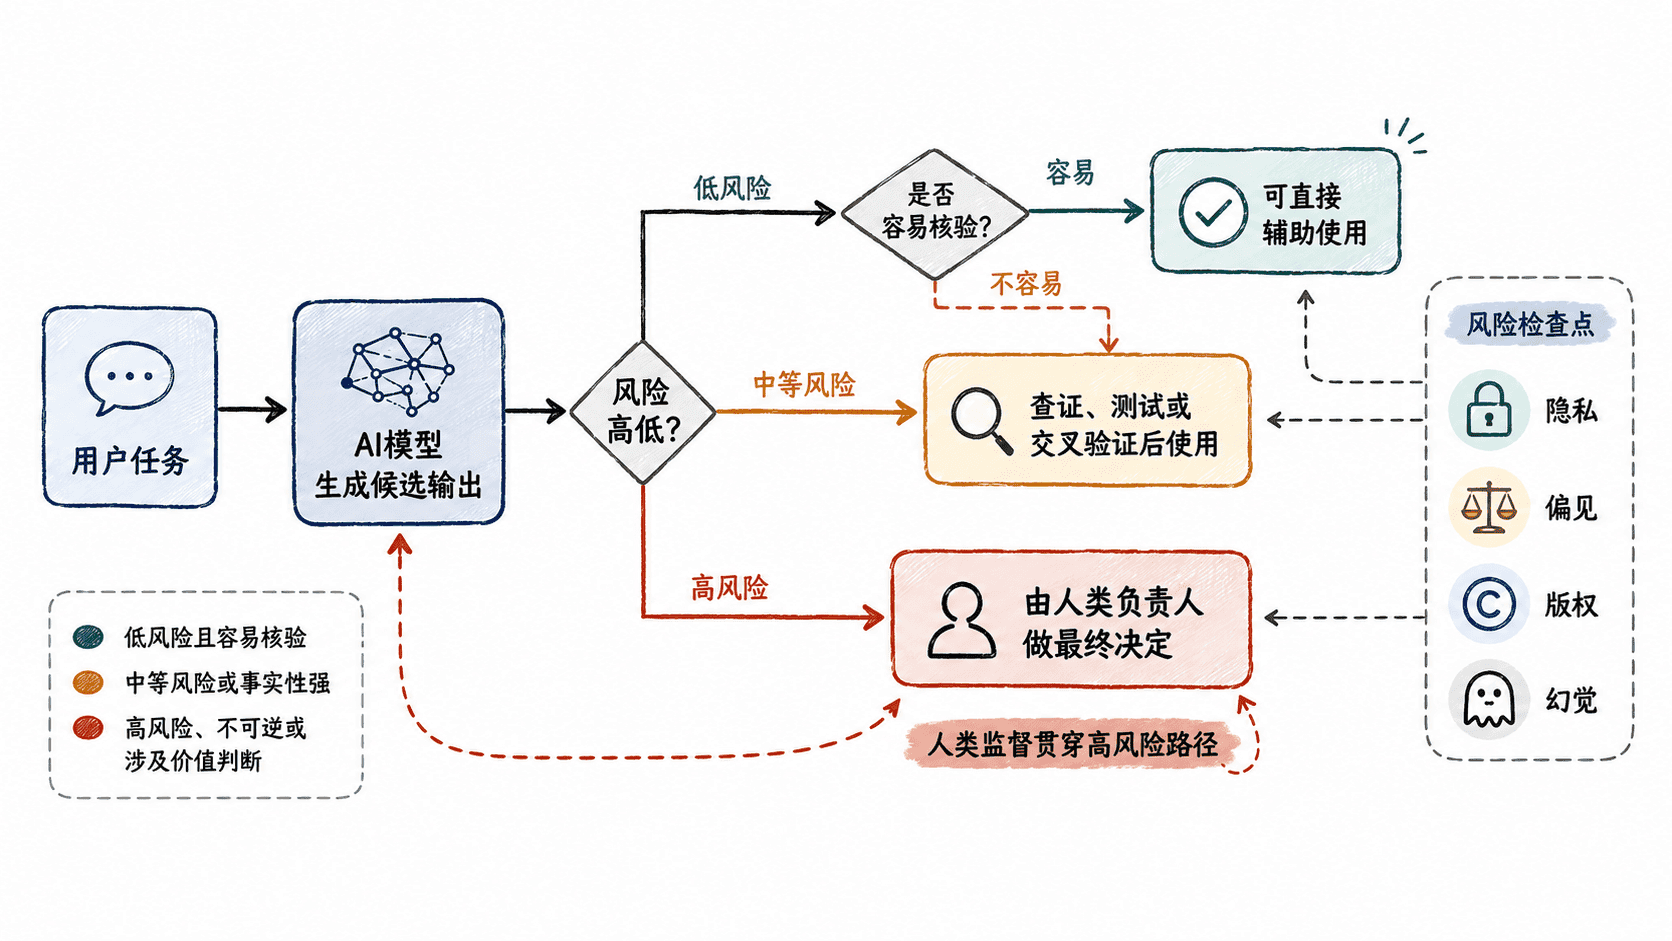
这个判断可以浓缩成三个问题:错了会造成多大后果?是否容易发现?发现后能否撤销? 后果越大、越难验证、越不可逆,就越不能把责任交给模型。
把安全要求变成任务检查清单
在真正使用模型前,可以先检查输入边界:是否含有敏感数据、是否有授权、是否超出原始用途。得到输出后,再检查事实、来源、分组影响和可能的权利问题。准备采取行动时,则确认这个动作是否可回滚、是否需要审批、日志是否足够支持事后追踪。
对于低风险任务,检查可以很轻量;对于高风险任务,应把验证步骤写进正式流程,而不是依赖个人记忆。安全不是“最后再审一次”,而是从数据、模型、验证到决策全过程的工程约束。
用分组证据复核工单项目
沿用前几课的工单项目。这里的召回率是实际关键工单中被正确转人工的比例。假定每张工单只属于桌面端或移动端之一,按人工复核结果统计。阈值 90% 和最低 50 条仅用于演示,不代表通用安全标准。
from fractions import Fraction

def audit_segments(counts, required=("桌面端", "移动端"), minimum=50):
    if not required:
        raise ValueError("至少定义一个必要切片")
    missing, low = [], []
    for name in required:
        recovered, total = counts.get(name, (0, 0))
        if not 0 <= recovered <= total:
            raise ValueError("计数不一致")
        if total < minimum:
            missing.append(name)
        elif Fraction(recovered, total) < Fraction(9, 10):
            low.append(name)
    return {"pass": not missing and not low,
            "insufficient": missing, "below_threshold": low}

large = {"桌面端": (920, 1000), "移动端": (64, 80)}
pooled = sum(n for n, _ in large.values()) / sum(d for _, d in large.values())
print(f"合并关键工单召回率: {pooled:.1%}")
print(audit_segments(large))
print(audit_segments({"桌面端": (920, 1000), "移动端": (9, 10)}))
合并结果约 91.1%,但移动端 64/80 只有 80%,因此该门槛未过。第二组移动端虽有 9/10,样本少于 50,仍须补充证据。真实验收要预先定义切片和允许用途,考虑估计不确定性、标签缺失和样本相关性。收集敏感属性须单独论证用途与授权,按政策保存最少的评估结果。
把门槛和动作写在同一份验收记录中。部署负责人保存版本、数据指纹和评估证据。若关键切片不达标,保持人工分拣或缩小范围;若上线后发现遗漏,先回退,再按预测发生时间核对受影响工单,记录复核和纠正结果。
把课程能力继续向前推进
完成基础阶段后,后续学习可以沿三条主线展开。第一条是模型与数据:继续学习特征工程、深度学习、生成式模型和评估方法;第二条是系统与工程:学习检索增强生成、Agent、部署、监控、成本与性能优化;第三条是安全与治理:学习数据合规、红队测试、内容安全、偏差评估和审计机制。
无论选择哪条路线,都建议保留同一个工作习惯:先明确任务目标和责任边界,再选择模型和数据,最后通过可重复的验证证明结果值得信任。人工智能能力越强,越需要把“能做什么”和“应该怎么做”同时纳入设计。