
机器学习与深度学习 / 系统课时
监控与故障排查
监控与故障排查
模型上线后,问题往往不是“程序直接报错”,而是输入悄悄变化、指标下降、延迟升高或输出开始异常。本篇建立一条从监控信号到根因验证的排查路径,帮助你避免靠猜测修改模型。
学习目标
- 区分数据漂移、质量下降、延迟升高和异常输出四类常见故障。
- 用基线与阈值把模糊异常转换成可检查的监控信号。
- 按输入、模型、依赖和输出证据链定位根因并验证修复。
先把异常分成不同层次
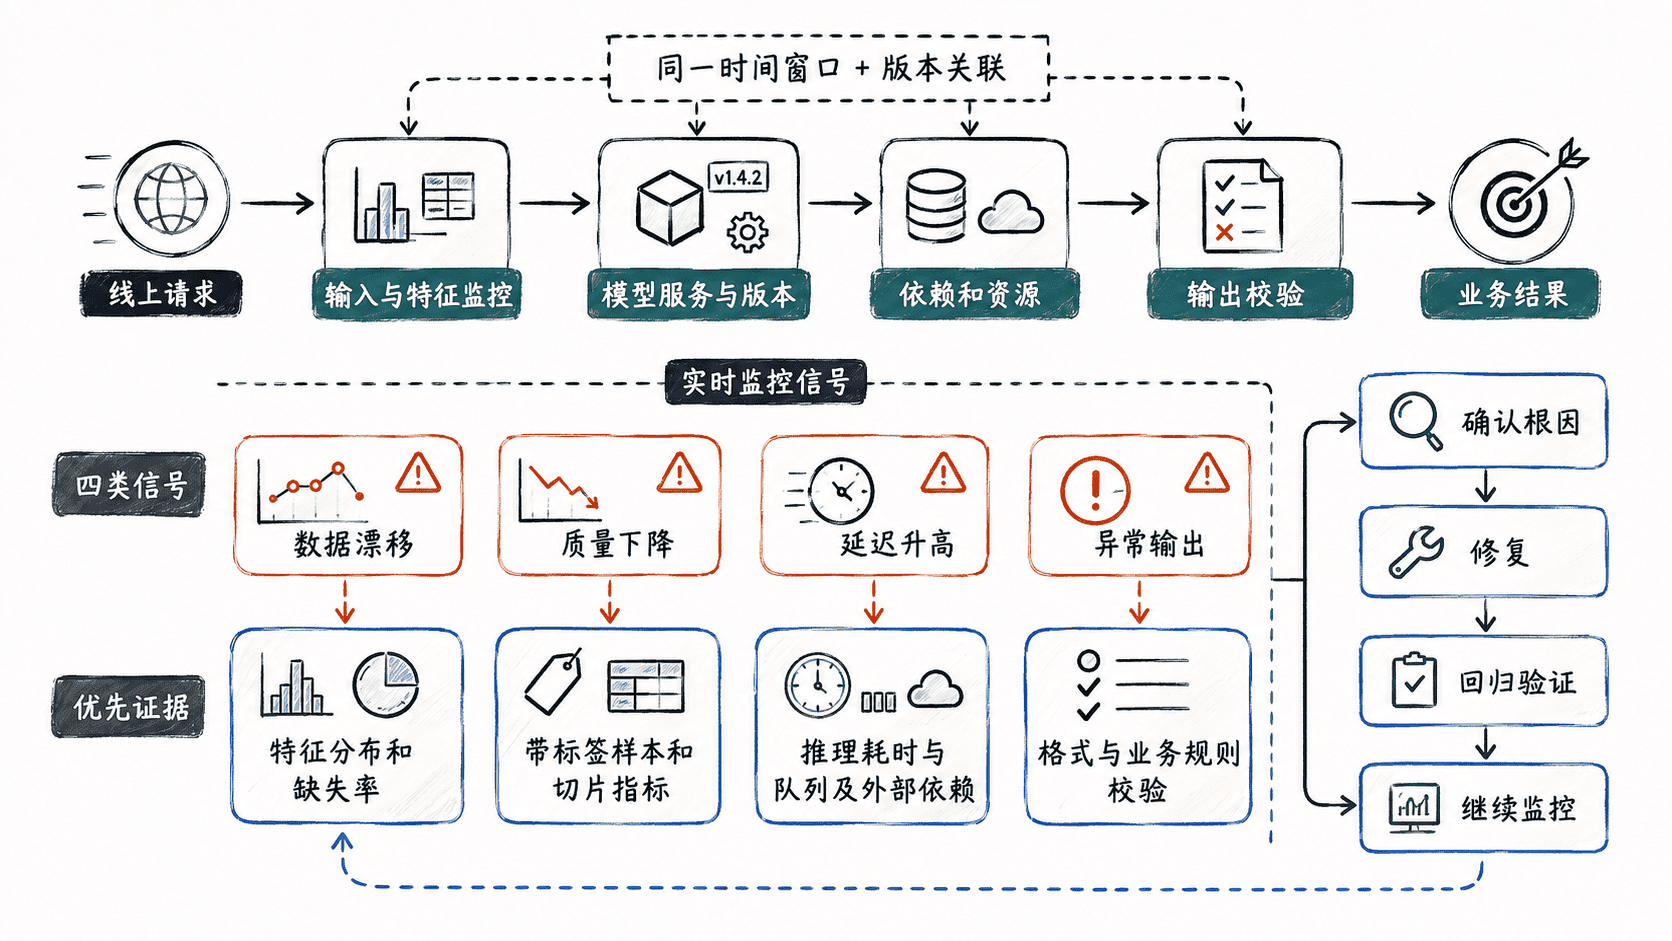
排障的第一步不是重训模型,而是先判断异常发生在哪一层。数据漂移描述线上输入分布与基线发生变化;性能下降指有真实标签可核对时,准确率、召回率等质量指标恶化;延迟问题通常与推理耗时、排队、资源或外部依赖有关;异常输出则可能表现为格式错误、越界值、空结果或违反业务约束。
| 现象 | 优先检查 |
|---|---|
| 输入分布明显变化 | 特征统计、缺失率、类别占比、上游数据版本 |
| 质量指标下降 | 标签样本、业务切片、模型版本、特征处理 |
| P95/P99 延迟上升 | 推理耗时、队列、CPU/GPU、数据库或外部服务 |
| 非法或异常输出增加 | 输出校验、阈值、后处理、输入格式 |
用基线把异常变成可判断的信号
沿用工单分类场景。下面把基线与当前样本放在相同口径下,分别检查转人工占比、质量、延迟和无效输出。转人工变化是流程信号,可能来自输入、模型、阈值或策略。示例仅比较带标签数量至少 50 的两个窗口,且假定已复核样本采用可比较的抽样口径。阈值用于演示。
from fractions import Fraction

def rate(hit, total):
    if not 0 <= hit <= total:
        raise ValueError("计数不一致")
    return Fraction(hit, total) if total else None

def signal(value, limit):
    if value is None:
        return "PENDING"
    return "ALERT" if value > limit else "OK"

def compare(baseline, current):
    old_manual = rate(baseline["manual"], baseline["requests"])
    new_manual = rate(current["manual"], current["requests"])
    manual_delta = None if old_manual is None or new_manual is None else abs(new_manual - old_manual)
    quality_drop = None
    if min(baseline["reviewed"], current["reviewed"]) >= 50:
        quality_drop = (rate(baseline["correct"], baseline["reviewed"])
                        - rate(current["correct"], current["reviewed"]))
    return {
        "manual_route_change": signal(manual_delta, Fraction(10, 100)),
        "quality_drop": signal(quality_drop, Fraction(5, 100)),
        "latency": signal(current["p95_ms"], 270),
        "invalid_output": signal(rate(current["invalid"], current["requests"]), Fraction(3, 100)),
    }

baseline = {"manual": 10, "requests": 100, "reviewed": 100, "correct": 92}
current = {"manual": 30, "requests": 100, "reviewed": 20, "correct": 16,
           "p95_ms": 320, "invalid": 6}
print(compare(baseline, current))
print("标签成熟后:", compare(baseline, {**current, "reviewed": 100, "correct": 80})["quality_drop"])
当前转人工率变化 20 个百分点,P95 为 320 ms,无效输出 6%,三个信号触发告警。只有 20 条已复核时,准确率先记 PENDING。标签成熟后,92% 到 80% 的下降触发质量告警。无流量或没有分母时先标为待定。
真实系统不应只监控单个均值。连续特征还可观察分位数、直方图或 PSI 等分布差异,类别特征可比较类别占比,输入质量可监控缺失率和非法值比例。质量指标往往要等待真实标签。记录标签覆盖率和抽样方式,按预测发生时间对齐对应标签。多个实例的 P95 不能直接平均,应用可先聚合兼容直方图桶,再估算整体分位数,并注明时间窗。
按证据链定位根因
先固定告警发生的时间窗口、影响范围和模型版本,再沿请求链向前追。这样可以避免同时修改多个变量,最后无法确认是哪一个改动解决了问题。
- 检查输入 schema、缺失率、范围和特征分布,确认上游是否改字段、单位、编码或采样方式。
- 对比当前模型、预处理器和配置版本,确认是否刚发生发布、回滚或阈值调整。
- 若质量下降,使用带真实标签的样本计算总体指标和关键业务切片,确认问题是局部还是全局。
- 若延迟升高,把端到端延迟拆成排队、预处理、推理、后处理和外部依赖耗时,先找增长最大的部分。
- 若异常输出增加,检查格式校验失败原因、极端输入以及后处理规则,不要只在最终输出处静默兜底。
如果数据漂移和质量下降同时发生,应先验证漂移是否集中在错误率升高的同一切片;如果延迟暴涨但模型质量稳定,更可能是资源或依赖问题,而不是训练问题。把多条信号、版本和业务变更放在同一时间轴上可以缩小排查范围。再用样本重放、分层比较或受控回退确认原因。
修复后做回归验证
修复必须针对已确认的根因。上游单位改变就修正数据契约或转换逻辑;模型版本回归就回滚或重新发布;资源不足则处理容量和并发;异常输出则补充明确的输入、输出约束。不要用“直接重训一次”覆盖所有未知问题。
修复完成后,应重新检查触发告警的指标,并同时观察没有直接修改的关键指标,防止出现新的副作用。保留可重放的旧异常样本,在相同口径的后续窗口确认触发指标恢复,并检查关键指标有没有回归。记录根因、修复动作、版本和验证窗口。
稳定的模型系统不是没有异常,而是异常出现时能迅速回答三个问题:哪一层出了问题、证据是什么、修复后如何证明已经恢复。