
机器学习与深度学习 / 系统课时
数据收集与标注
数据收集与标注
模型只能从实际提供的数据中学习,因此数据收集与标注决定了训练结果能否代表真实问题。本节关注从“样本是什么”开始,建立可追溯的数据来源、明确的标注规则和质量检查方法,避免把偏差、泄漏和错误标签带入训练集。
学习目标
- 选择与任务目标一致、可追溯且具有代表性的数据来源
- 设计可执行的标注规范,并处理歧义样本与标注冲突
- 在进入训练前检查数据泄漏、重复样本和数据划分问题
先确定样本单位和时间边界
收集数据前先定义“一条样本”代表什么。预测用户流失时,样本单位可能是一个用户;识别商品缺陷时,样本单位可能是一张图片。样本单位不明确,会导致特征、标签和后续训练切分互相错位。
时间相关任务还要明确观察窗口与预测窗口。例如用过去 14 天行为预测未来 30 天是否流失,输入特征的事件时间应在窗口内,且数据在预测时点已可用。迟到、补写或后来修正的记录要用当时可见版本。若把“取消订阅后的客服记录”放进特征,就等于提前看到了答案,形成数据泄漏。
选择数据来源并记录来路
可用数据通常来自业务日志、交易记录、传感器、问卷、人工采集、公开数据集或经过授权的第三方数据。选择来源时,不只看数量,还要检查覆盖范围、采集规则、时间跨度和与真实使用环境的一致性。
| 检查项 | 需要确认的问题 |
|---|---|
| 代表性 | 样本是否覆盖模型实际面对的人群、设备、地区和时间段 |
| 合法与授权 | 数据是否有权收集、保存和用于当前目的 |
| 一致性 | 不同来源中的字段定义、单位和时间含义是否一致 |
| 可追溯性 | 能否知道数据来自哪里、何时采集、经过哪些处理 |
同一字段在不同系统里可能含义不同。例如“创建时间”可能分别指用户点击时间、服务端接收时间或数据库写入时间。进入训练集前要统一字段、时区和边界,区分事件发生、记录入库、特征可用和标签成熟时间。
把采集变成可复现的数据链路
一个稳健的数据集不是临时导出的文件,而是一条能够重复执行和追踪版本的链路:从原始来源开始,经过筛选、去重、冻结样本、标注、质量检查,最后形成可训练的数据版本。
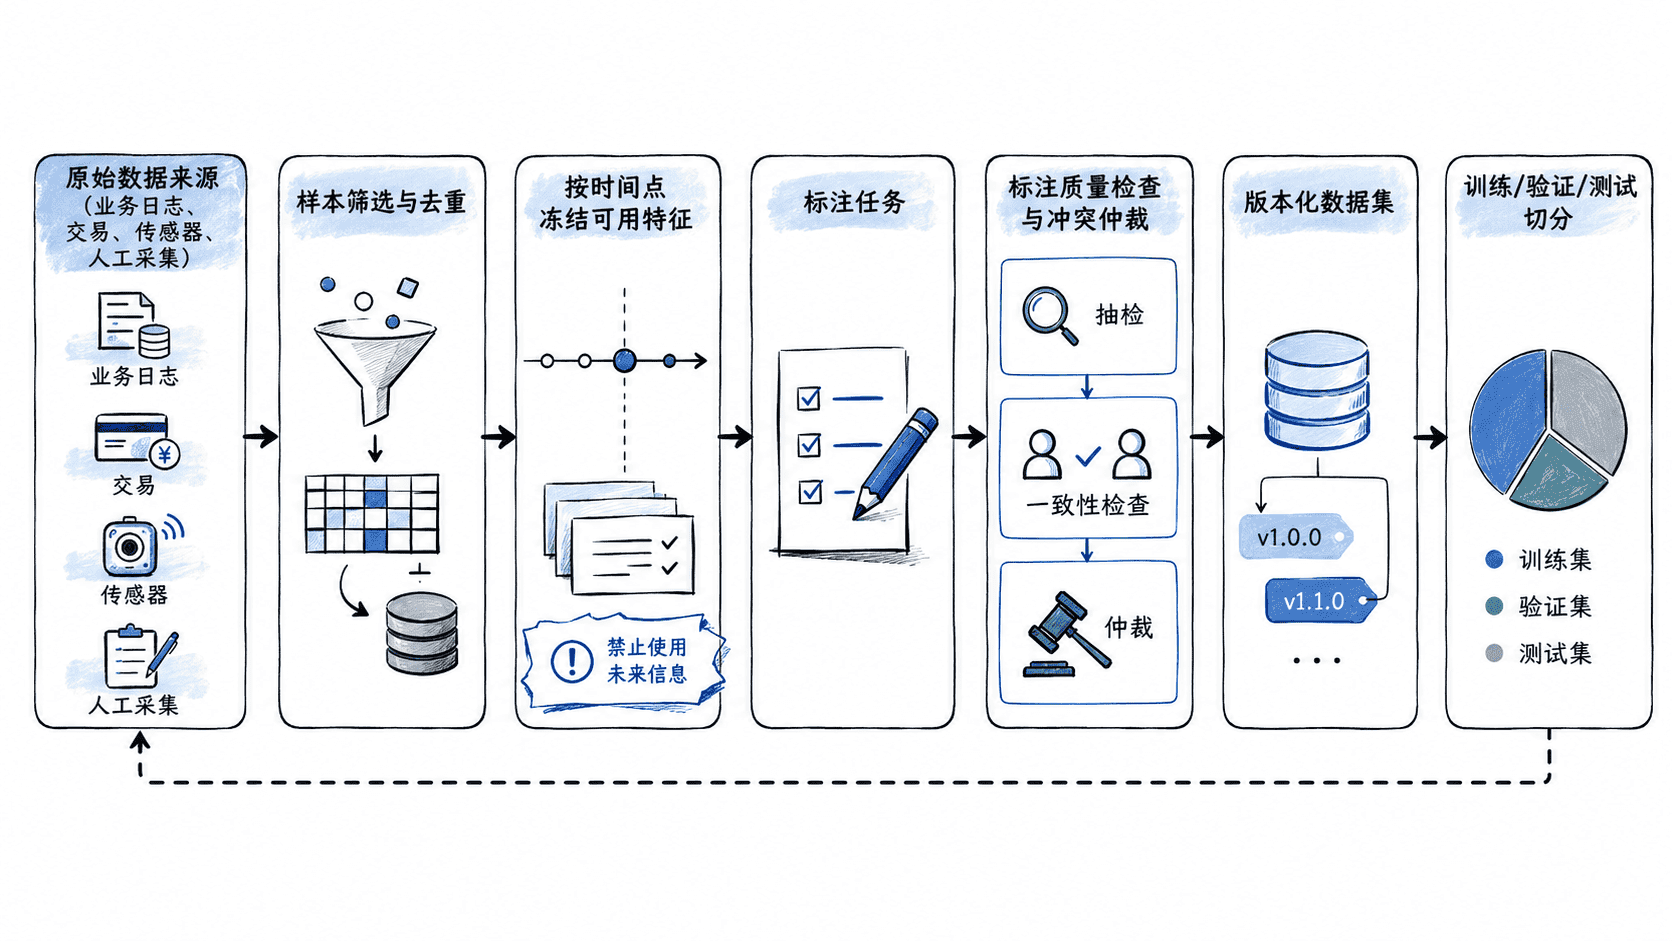
为了能复现某次训练,至少要保留数据来源、采集时间范围、筛选条件、处理规则和数据集版本。模型效果出现异常时,这些信息能帮助判断问题来自模型,还是来自数据发生了变化。
标注规则要让不同人做出相近判断
监督学习中的标签就是模型要学习的目标。好的标注规范不能只写“按经验判断”,而要给出正例、反例、边界样本和无法判断时的处理方式。
假设任务是判断客服工单“是否需要人工升级”。规范应说明哪些情形一定标为“需要升级”,哪些可以直接处理,信息不足时是标为“未知”还是进入复核。若任务主观性较强,可让一部分样本由两名标注者独立处理,再对冲突样本仲裁。
标注过程最好同时记录标注结果、标注规范版本和必要的复核状态。这样修改规则后,可以识别哪些旧标签需要重新检查,而不是把不同口径的数据混在一起训练。
用预测时点重建训练行
下面的例子使用日粒度。活动窗口左闭右开,标签窗口从预测日开始并排除第 30 天边界。complete_through 表示已经覆盖到该日期之前的业务事件。真实训练还要区分日志迟到、撤销、失联或观察终止。
from datetime import date, timedelta

def activity_count(events, user, anchor):
    start = anchor - timedelta(days=14)
    return len({event_id for event_id, owner, occurred, available in events
                if owner == user and start <= occurred < anchor and available <= anchor})

def churn_label(cancelled, anchor, complete_through):
    end = anchor + timedelta(days=30)
    if complete_through < end:
        return None  # 还不能标为负例
    return int(cancelled is not None and anchor <= cancelled < end)

anchor = date(2026, 4, 15)
events = [
    ("e1", "u1", date(2026, 4, 1), date(2026, 4, 1)),
    ("e1", "u1", date(2026, 4, 1), date(2026, 4, 1)),
    ("e2", "u1", date(2026, 4, 13), date(2026, 4, 16)),
    ("e3", "u2", date(2026, 4, 14), date(2026, 4, 14)),
]
print("可用活动数:", activity_count(events, "u1", anchor))
print("标签已成熟:", churn_label(date(2026, 4, 20), anchor, date(2026, 5, 15)))
print("窗口未结束:", churn_label(None, anchor, date(2026, 5, 1)))
结果依次为 1、1、None。第一条活动的重复上报被合并,迟到记录和其他用户被排除。窗口未完整时先保留未知状态。标注时抽取不同班次、设备或地区的样本做双人复核,记录冲突原因与仲裁版本。
训练前检查质量与数据划分
数据量大并不等于数据质量高。进入训练前,应先检查明显错误、缺失值、类别分布、重复样本以及标签冲突。对高价值或高风险任务,还应抽样人工复核,确认标签含义与业务定义一致。
训练集、验证集和测试集的划分必须防止信息串线。同一事件的副本应去重或留在同一分区。若目标是泛化到新用户,按用户分组切分;若预测已有用户未来行为,可以保留同一用户的历史,但只能向过去取特征,并避免训练标签窗口侵入评估时间。时间序列任务通常按时间先后划分,比随机切分更能模拟真实上线环境。
当数据来源可追溯、样本边界清晰、标签规则可复现,并且训练与评估数据之间没有泄漏时,数据集才真正具备训练价值。之后即使更换模型,也能在同一数据基线上公平比较效果。