
机器学习与深度学习 / 系统课时
训练与评估模型
训练与评估模型
上节的关键词规则能解释自己的匹配结果,也会遇到没写进词表的新表述。本课用另一组独立合成工单训练轻量分类器,再让它和冻结规则在同一组工单上比较。任务仍只有账号、退款两个自动类别,其他工单转人工。
学习目标
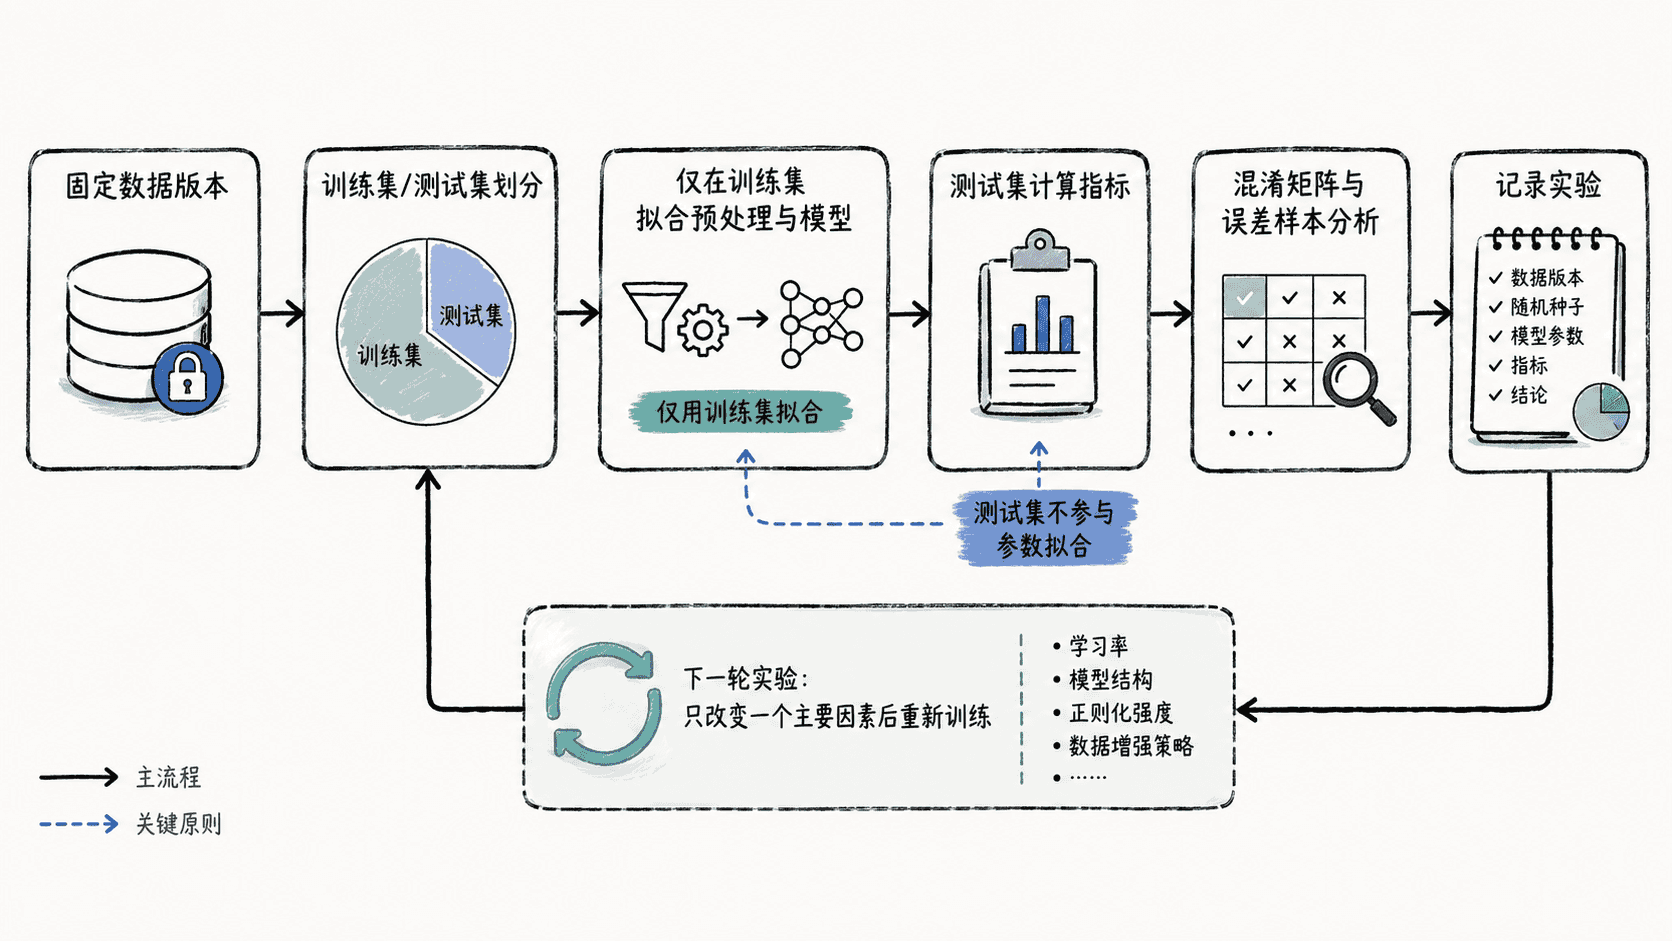
- 按时间划分并检查用户实体隔离,只在训练集拟合文本预处理与模型。
- 用验证集选择自动路由阈值,记录覆盖率、错分和人工量。
- 在独立测试集复验冻结的模型与规则,并根据证据分析错误。
先划分再拟合
工单示例用三个月份分别训练、验证和测试,并检查用户编号没有跨集合。日期和实体编号只用于划分。若同一用户跨过真实项目的时间边界,应先决定要评估新用户、未来来信还是两者兼顾,再据此定义保留与排除策略。只用提交时可见的内容,结单后的人工标签、解决方案和沟通记录不能回填为输入。切分后才拟合词表、IDF 和逻辑回归。 scikit-learn 交叉验证与时间、实体边界 scikit-learn Pipeline 和数据泄漏
可运行示例:从字符片段到人工回退
用 scikit-learn 运行。字符二元组 TF-IDF 表示相邻字符片段,逻辑回归从训练工单拟合两类。in_scope 模拟接单时可见且由上游提供的范围字段,不由真实标签推导。范围外或完全没有已见特征时直接转人工;范围内有可用特征,再按验证选出的分数阈值决定是否自动。模型分数不是已经校准的正确率,也无法单独识别所有范围外工单。 scikit-learn TfidfVectorizer 分类阈值与独立验证
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline


MANUAL = "人工"
KEYWORDS = {"账号": ("登录", "密码", "邮箱", "账号"),
            "退款": ("退款", "退钱", "扣款", "退回")}
# 每条记录:日期、用户 ID、入口是否在范围内、提交文本、事后标注。
train_examples = [
    ("无法登录账号", "账号"), ("忘记账号密码", "账号"),
    ("登录提示异常", "账号"), ("账号修改邮箱", "账号"),
    ("手机账号被锁定", "账号"), ("修改登录密码", "账号"),
    ("申请订单退款", "退款"), ("退款多久到账", "退款"),
    ("订单重复扣款", "退款"), ("取消订单并退款", "退款"),
    ("扣款后申请退回", "退款"), ("查看退款进度", "退款"),
]
records = [("2026-07-15", f"train-{i}", True, text, label)
           for i, (text, label) in enumerate(train_examples)] + [
    ("2026-08-10", "val-1", True, "无法登录", "账号"),
    ("2026-08-10", "val-2", True, "重复扣款", "退款"),
    ("2026-08-10", "val-3", True, "账号退款", MANUAL),
    ("2026-08-10", "val-4", False, "发票改抬头", MANUAL),
    ("2026-09-10", "test-1", True, "登录账号", "账号"),
    ("2026-09-10", "test-2", True, "申请退款", "退款"),
    ("2026-09-10", "test-3", True, "资料重新启用", "账号"),
    ("2026-09-10", "test-4", False, "退款发票如何开", MANUAL),
]
train = [row for row in records if row[0] < "2026-08-01"]
validation = [row for row in records if "2026-08-01" <= row[0] < "2026-09-01"]
test = [row for row in records if row[0] >= "2026-09-01"]
groups = [{row[1] for row in split} for split in (train, validation, test)]
if sum(map(len, groups)) != len(set.union(*groups)):
    raise ValueError("users overlap across splits")

model = make_pipeline(TfidfVectorizer(analyzer="char", ngram_range=(2, 2)),
                      LogisticRegression(C=8, max_iter=500, solver="liblinear", random_state=0))
model.fit([row[3] for row in train], [row[4] for row in train])
vectorizer, classifier = model.steps[0][1], model.steps[1][1]


def model_route(row, cutoff):
    if not row[2]:
        return MANUAL
    features = vectorizer.transform([row[3]])
    if features.nnz == 0:
        return MANUAL
    scores = classifier.predict_proba(features)[0]
    best = int(scores.argmax())
    return classifier.classes_[best] if scores[best] >= cutoff else MANUAL


def rule_route(row):
    if not row[2]:
        return MANUAL
    matches = [label for label, words in KEYWORDS.items()
               if any(word in row[3] for word in words)]
    return matches[0] if len(matches) == 1 else MANUAL


def counts(rows, route):
    pairs = [(row[4], route(row)) for row in rows]
    auto = [(actual, pred) for actual, pred in pairs if pred != MANUAL]
    return len(auto), sum(actual != pred for actual, pred in auto), len(pairs)


choices = []
for cutoff in (0.50, 0.65, 0.80):
    auto, wrong, total = counts(validation, lambda row: model_route(row, cutoff))
    if auto > 0 and wrong == 0:
        choices.append((auto, cutoff))
if not choices:
    raise RuntimeError("no cutoff met the validation requirement")
_, selected = max(choices)

print("train / validation / test:", len(train), len(validation), len(test))
print("validation cutoff:", selected)
print("rule test (auto, wrong, total):", counts(test, rule_route))
print("model test (auto, wrong, total):", counts(test, lambda row: model_route(row, selected)))train / validation / test: 12 4 4
validation cutoff: 0.65
rule test (auto, wrong, total): (2, 0, 4)
model test (auto, wrong, total): (2, 0, 4)把分数变成验收证据
脚本先用验证数据选在本例中无自动错分且覆盖最多的阈值,覆盖相同时取更保守的高阈值,再对测试集计算两种方案。测试里的两条人工一条在范围外,一条缺少训练中已见的字符片段。这个四条样本的测试用于演示流程,不能证明模型优于规则。正式评估应报告三种路由结果的混淆矩阵、每类样本数、自动错分、覆盖率、人工量和范围外误收,必要时按来源和时段分组。 scikit-learn 模型评估
查看验证错例,先判断是词表覆盖、标签边界还是范围元数据问题,再设计下一轮。记录数据版本、划分时点、模型、预处理、阈值和证据。若用测试结果修改阈值、规则或模型,需要准备新的独立测试。部署时还要使用冻结的预处理、模型、阈值与回退契约。 scikit-learn 常见泄漏问题