
机器学习与深度学习 / 系统课时
主成分分析
主成分分析
聚类寻找样本之间的分组,主成分分析(PCA)寻找数据在哪些方向变化最大。将每个样本投影到少数方向上后,样本数不变,每条记录的坐标数减少。
学习目标
- 区分主成分方向和样本在方向上的得分。
- 推导中心化、协方差、线性投影和重构的形状。
- 用训练均值和方向转换新样本,解释方差比例的适用边界。
主成分怎样表示变化
第一主成分是投影方差最大的单位方向。后续方向与已选方向正交,依次最大化剩余方差。方向由原始特征的线性组合给出,每个样本的投影值叫主成分得分。高方差说明沿该方向样本变化较大,不能直接解释为某个任务里预测信息最多。 scikit-learn PCA
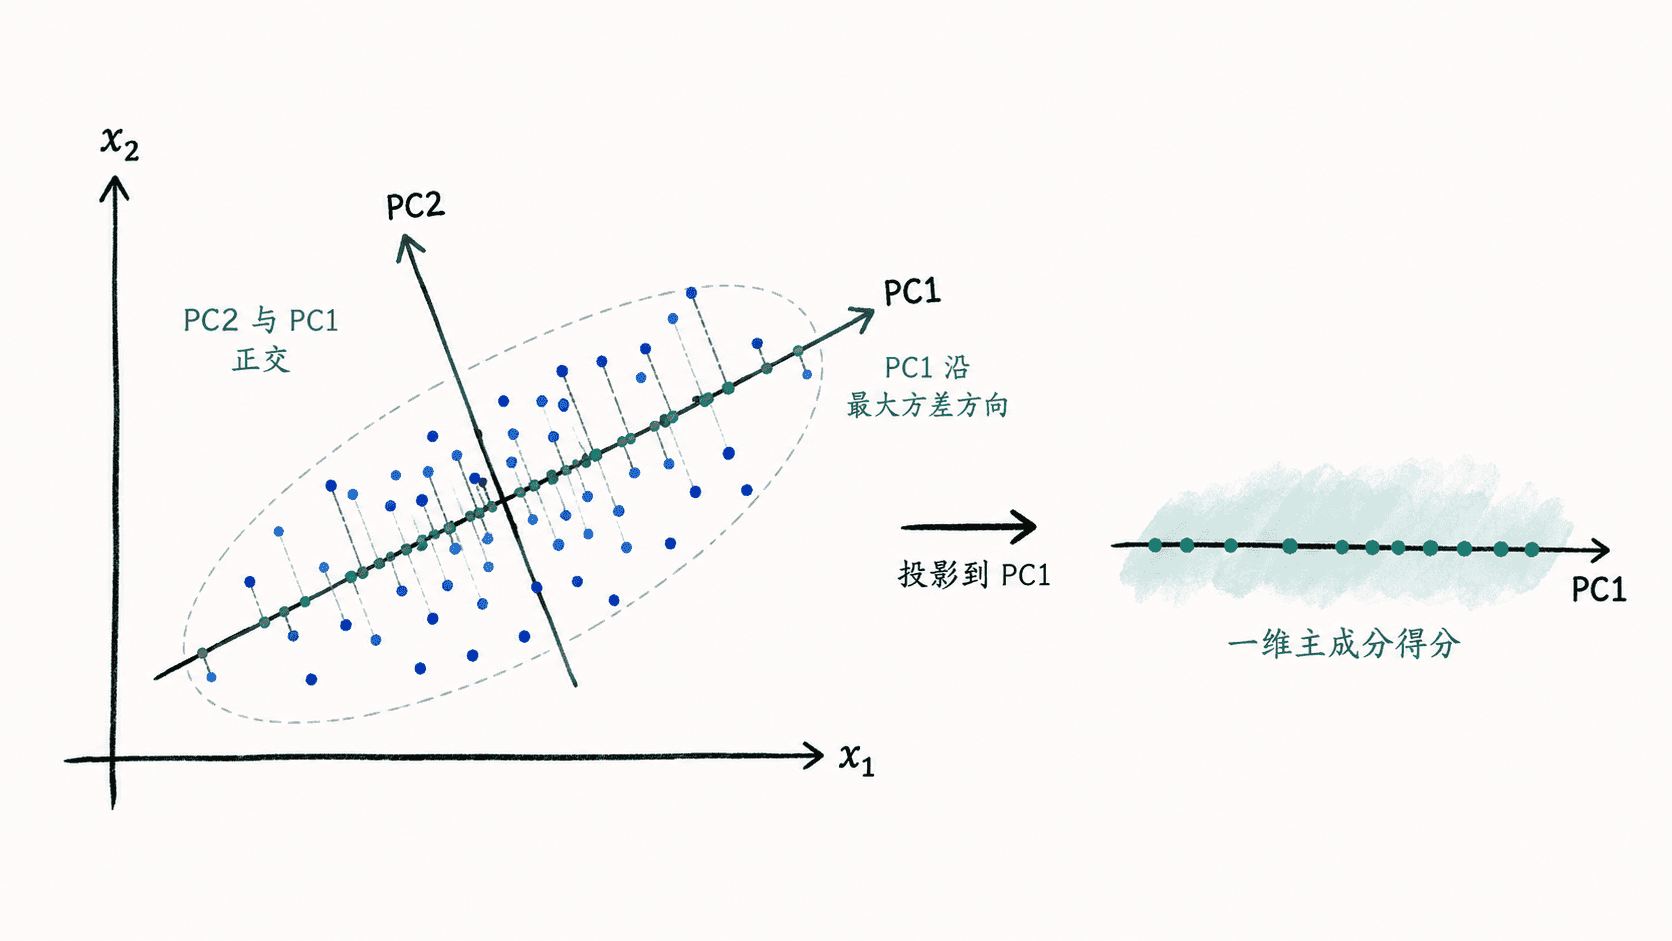
从训练数据拟合投影
设训练矩阵 有 行样本、 列特征,。减去训练列均值得到同形状的 。样本协方差 形状是 (d,d)。对实对称的 分解,按特征值从大到小排列方向。取前 个单位特征向量作为 的列, 形状是 (d,k),得分 形状是 (n,k)。scikit-learn 的 components_ 则以行为主方向。常见实现也可用中心化矩阵的奇异值分解求得这些方向。 NumPy 对称矩阵特征值分解 scikit-learn PCA 分解与属性
第 个方向的解释方差比是 。分母包括原空间的总方差。将投影乘 再加训练均值,可得到原空间的低维重构。若所有特征都恒定,总方差为零,此时无法解释成有意义的保留比例。 scikit-learn PCA 方差属性
用 NumPy 实跑并对照 scikit-learn
下面把四条二维记录压成一维,再用同一均值、同一方向处理一个新样本。特征向量整体翻转仍代表同一轴。为使输出容易比对,这组示例令第一主方向的第二分量为正。若两个特征值相同,其共同子空间内可以选择不同正交基,单个主成分也可能不唯一。
import numpy as np
from sklearn.decomposition import PCA


X = np.array([[2.0, 0.0], [0.0, 2.0], [3.0, 1.0], [1.0, 3.0]])
mean = X.mean(axis=0)
centered = X - mean
covariance = centered.T @ centered / (len(X) - 1)
values, vectors = np.linalg.eigh(covariance)
pc1 = vectors[:, -1]
if pc1[1] < 0:
    pc1 = -pc1

Z = centered @ pc1[:, None]
restored = Z @ pc1[None, :] + mean
new = np.array([[4.0, 2.0]])
new_score = (new - mean) @ pc1[:, None]

pca = PCA(n_components=1, svd_solver="full").fit(X)
np.testing.assert_allclose(pca.inverse_transform(pca.transform(X)), restored)
np.testing.assert_allclose(pca.explained_variance_ratio_[0], values[-1] / values.sum())

print("mean:", mean.tolist())
print("direction:", np.round(pc1, 3).tolist())
print("training scores:", np.round(Z[:, 0], 3).tolist())
print("new score:", np.round(new_score, 3).tolist())
print("variance ratio:", round(float(values[-1] / values.sum()), 2))mean: [1.5, 1.5]
direction: [-0.707, 0.707]
training scores: [-1.414, 1.414, -1.414, 1.414]
new score: [[-1.414]]
variance ratio: 0.8怎样选择维数和尺度
保留 80% 方差表示训练数据在这个方向上的投影方差占总方差的八成。可用累计解释方差选择候选维数,若 PCA 接在预测模型之前,还要比较验证指标。scikit-learn 的 PCA 自动中心化,但不会把每列缩放成相同方差。量纲不同或尺度没有可比性时,可根据任务在 PCA 之前加缩放;若原单位的变化大小有明确含义,则要验证缩放是否改变了期望权重。 scikit-learn PCA 预处理行为
用于下游评估时,只在训练数据上拟合缩放和 PCA,在验证、测试、新数据上复用参数。交叉验证也要在每折内执行这一过程。离群点会影响均值和协方差,弯曲的数据结构也未必能用少数线性方向表达。 scikit-learn 预处理泄漏说明
本课练习
把 pc1 整体乘以 −1,观察得分变号而重构不变。再把第二列都乘 100,比较原尺度 PCA 与标准化后 PCA 的方向,解释应以什么尺度理解方差。下一课会用距离和统计量识别可疑样本。