
机器学习与深度学习 / 系统课时
智能体工作循环
智能体工作循环
智能体在应用给定的目标和约束下,可以依据上一步观察决定下一步行动。下面用一套最小的“规划、执行、观察、更新状态”循环讲解,多轮运行可选用短期状态或长期存储。本课将拆解这个闭环,并用一个最小程序展示智能体如何根据新观察调整下一步行动。
学习目标
- 说明智能体循环中各阶段的职责
- 区分工具调用与持续任务循环
- 能设置停止条件、记忆范围和失败保护
五个环节如何形成闭环
感知负责读取用户目标、环境状态和工具结果;规划把目标拆成当前可执行的一步;行动调用工具或产生输出;观察读取行动结果;记忆保存后续步骤需要的信息。
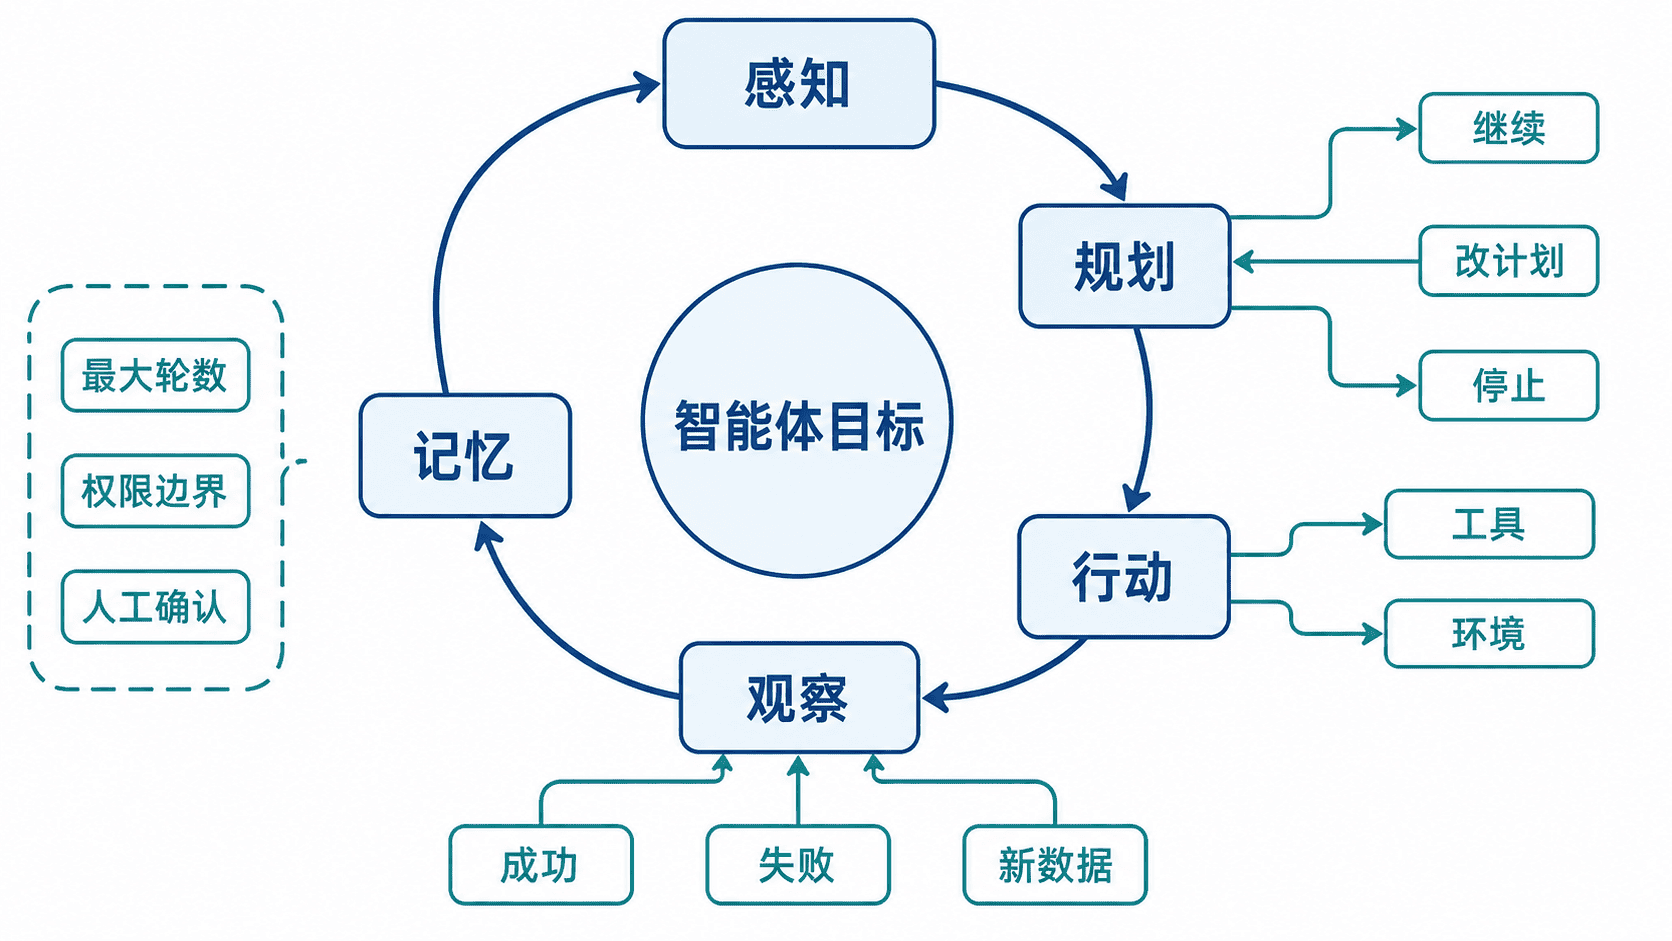
一次函数调用只解决一个明确动作,而智能体会根据动作结果继续决策。例如查询航班后发现无票,智能体可能调整日期再次查询;如果没有循环和状态更新,它只能把无票结果返回给用户。
最小可运行循环
用规则代替模型规划,处理固定任务“按优先级整理待办”。读取结果必须是 Task 列表,空列表和已排序各有明确完成状态。优先级数字越小越紧急。预算耗尽返回独立状态,便于调用方区分结果是否完成。
from dataclasses import dataclass

@dataclass(frozen=True)
class Task:
    name: str
    priority: int

def plan(tasks):
    if tasks is None:
        return "read"
    if not tasks:
        return "finish_empty"
    return "sort"

def run(load, max_steps=2, cancelled=lambda: False):
    tasks = None
    trace = []
    for _ in range(max_steps):
        if cancelled():
            return "cancelled", [], trace
        action = plan(tasks)
        trace.append(action)
        if action == "read":
            try:
                tasks = load()
            except TimeoutError:
                return "tool_timeout", [], trace
            if not isinstance(tasks, list) or not all(isinstance(t, Task) for t in tasks):
                return "invalid_observation", [], trace
        elif action == "finish_empty":
            return "done", [], trace
        elif action == "sort":
            ordered = sorted(tasks, key=lambda t: t.priority)
            return "done", [task.name for task in ordered], trace
        else:
            return "unknown_action", [], trace
    return "budget_exhausted", [], trace

print(run(lambda: [Task("更新文档", 2), Task("修复故障", 1)]))
print(run(lambda: []))
print(run(lambda: [Task("修复故障", 1)], max_steps=1))
三次输出分别是完成并得到两项排序、空列表完成、预算耗尽。若读取动作超时,直接返回可识别的停止原因。若换成模型规划,动作仍要经过枚举、参数与权限校验。短期状态、长期知识和审计事件可独立保存。
停止条件与失败保护
智能体必须有明确停止条件,例如目标完成、用户取消、达到最大轮数、预算耗尽或连续失败。没有停止条件的循环可能重复调用工具,持续消耗资源,甚至反复执行有副作用的操作。
每次行动前都应检查权限和风险。读取公开网页可以自动执行,发送消息、修改数据和支付操作则应提高确认级别。连续失败时应保留错误信息并交还人工,而不是不断改写参数尝试。
记忆应该保存什么
记忆应保存后续决策真正需要的事实,例如已完成步骤、工具返回的标识、用户确认和失败原因。重复对话、无关网页内容和敏感信息不应默认长期保存。
长期记忆还需要过期、纠错和删除机制。错误信息一旦被持久化,智能体可能在后续任务中反复引用,因此“记住更多”不等于“表现更好”。
评估一个智能体
不能只看最终答案,还要检查完成率、工具调用次数、总耗时、费用、错误恢复和越权次数。相同任务如果能用两次调用完成,就不应让智能体绕行十轮。
评估可记录工具名、请求 ID、脱敏参数摘要、返回状态、耗时和停止原因,复盘目标、实际执行与终态是否一致。超时、拒绝和预算耗尽分别统计。保存范围、保留时间和可访问人员应由应用定义。