
机器学习与深度学习 / 系统课时
模型训练与参数
模型训练与参数
划分数据之后,训练用训练样本确定模型中的数值。这里用一个只有权重和偏置的回归模型,观察首次更新及后续损失,再区分训练误差、选择超参数和评估泛化的职责。
学习目标
- 区分模型参数与控制训练过程的超参数。
- 用同一组旧参数计算梯度,再一起更新权重与偏置。
- 读懂训练损失曲线,并解释为什么需要验证集。
参数、超参数和更新次数
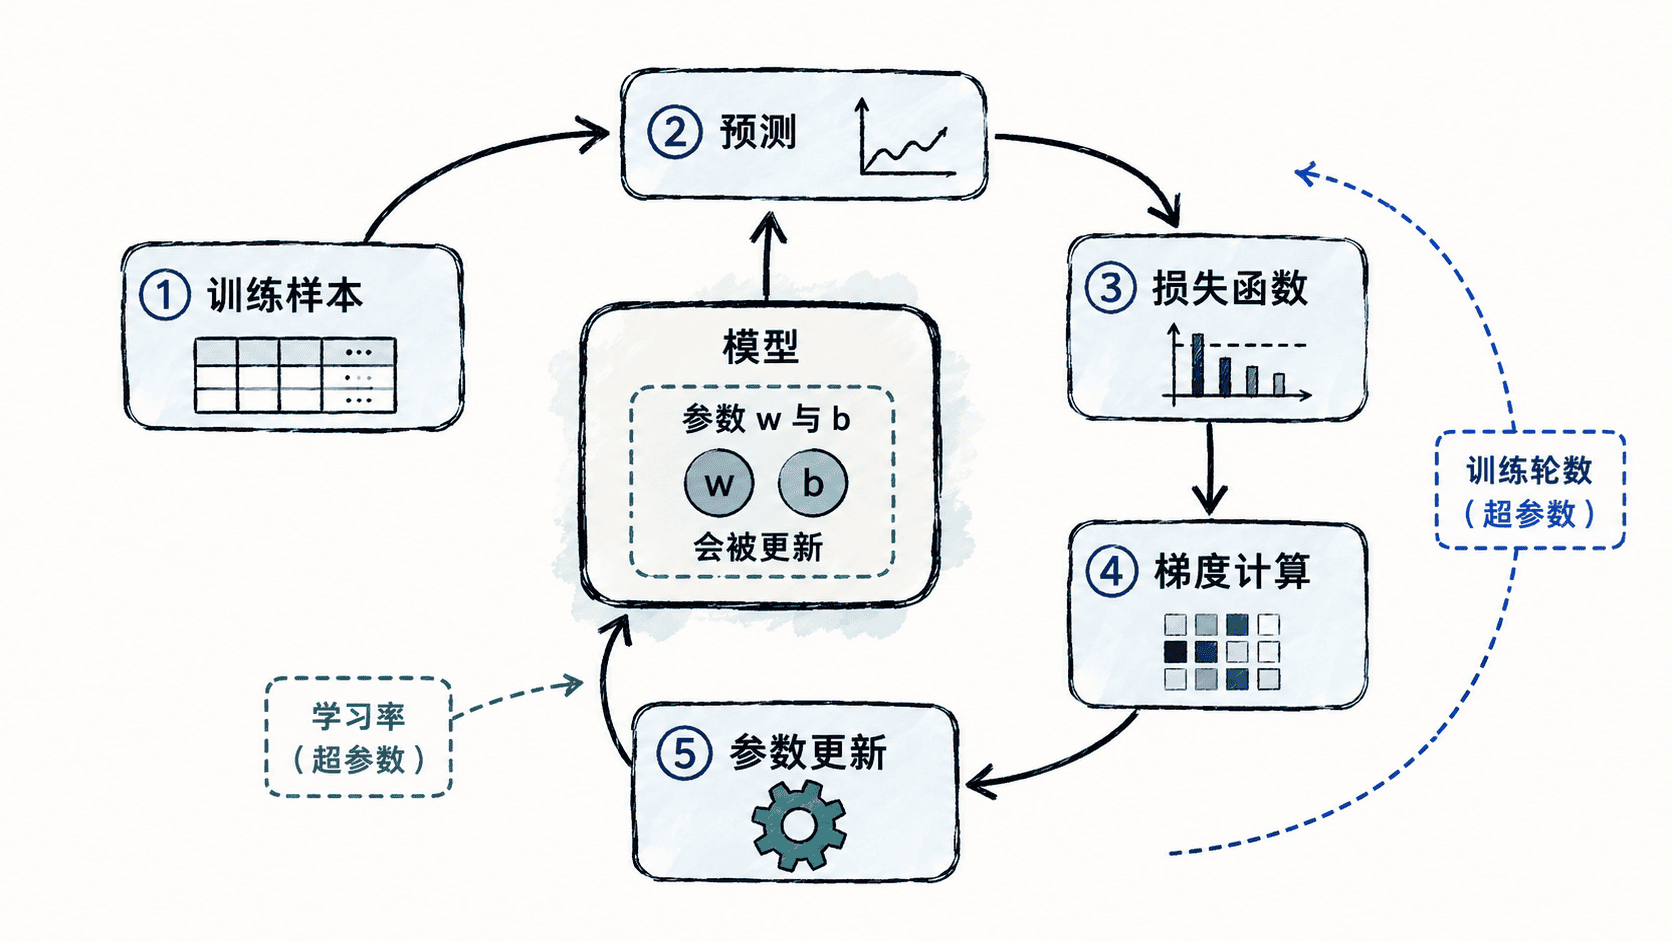
对于预测式 ,权重 和偏置 属于参数。学习率、批大小、总轮数以及模型结构常作为超参数。参数从训练数据中拟合,候选超参数可通过验证数据或开发集内交叉验证来比较。有些模型可用闭式求解或别的优化器,此处演示全批量梯度下降。 Google 线性回归与超参数
一次更新处理一个批次,一轮通常表示遍历训练集一次。示例每轮使用四条训练样本,所以一轮只有一次更新。小批量训练一轮可以更新多次,损失也可能波动。
推导一轮更新
令第 个残差为 。均方误差 。对每个平方项用链式法则,权重梯度为 ,偏置梯度为 。两者都从同一组旧参数得到,再分别减去学习率乘以梯度。 Google 线性回归梯度推导
取 、,初值 。第一轮开始时残差是 ,训练 MSE 为 41,梯度分别是 −35 和 −12。学习率 0.05 时,首步后 、。
用 Python 跟踪损失
python
x = [1.0, 2.0, 3.0, 4.0]
y = [3.0, 5.0, 7.0, 9.0]


def gradients(w, b):
    errors = [w * xi + b - yi for xi, yi in zip(x, y)]
    dw = 2 * sum(e * xi for e, xi in zip(errors, x)) / len(x)
    db = 2 * sum(errors) / len(x)
    return dw, db


def mse(w, b):
    return sum((w * xi + b - yi) ** 2 for xi, yi in zip(x, y)) / len(x)


def fit(learning_rate, epochs):
    w = b = 0.0
    for _ in range(epochs):
        dw, db = gradients(w, b)
        w -= learning_rate * dw
        b -= learning_rate * db
    return w, b


print(f"initial mse={mse(0, 0):.2f}")
w, b = fit(0.05, 1)
print(f"first: w={w:.3f}, b={b:.3f}")
w, b = fit(0.05, 200)
print(f"final: w={w:.3f}, b={b:.3f}, mse={mse(w, b):.6f}")
text
initial mse=41.00
first: w=1.750, b=0.600
final: w=2.005, b=0.986, mse=0.000033
判断训练是否有效
这四个点是从直线 生成的,模型形式和数据生成规则一致。训练损失降下来说明这个示例在拟合已有点,泛化还要用未参与拟合的验证样本判断。学习率过大可能使本例损失上升;当训练损失下降而验证损失持续上升时,可检查过拟合或数据分布变化。早停根据预先选好的验证指标决策,之后按测试规程验收。 Google 线性回归梯度下降 Google 学习率与训练轮数
本课练习
把学习率改成 0.2,对比前两次更新的损失。再将一个训练目标改成 12,观察这组新数据的最优直线会怎样变化。下一课用分类阈值理解模型训练与决策之间的区别。
按自己的节奏,确认真正理解。