
机器学习与深度学习 / 系统课时
文本生成模型
文本生成模型
文本生成模型的核心任务,是根据已有上下文预测下一个词元,并把预测结果不断追加到上下文中。本课将说明自回归生成的运行方式,以及温度、Top-p 等采样参数如何影响答案的稳定性、创造性和可重复性。
学习目标
- 解释自回归模型逐个生成词元的基本过程
- 理解温度、Top-k、Top-p 与输出差异的关系
- 能根据任务类型选择更稳妥的生成参数
自回归生成的本质
普通自回归解码先把输入转为词元,再用可见前缀计算下一个词元的分数。优化实现可在一次调用里验证多步候选,词元之间仍遵循前缀条件关系。选中一个词元后,它会被追加到上下文,模型再进行下一轮预测,直到生成结束标记或达到长度上限。
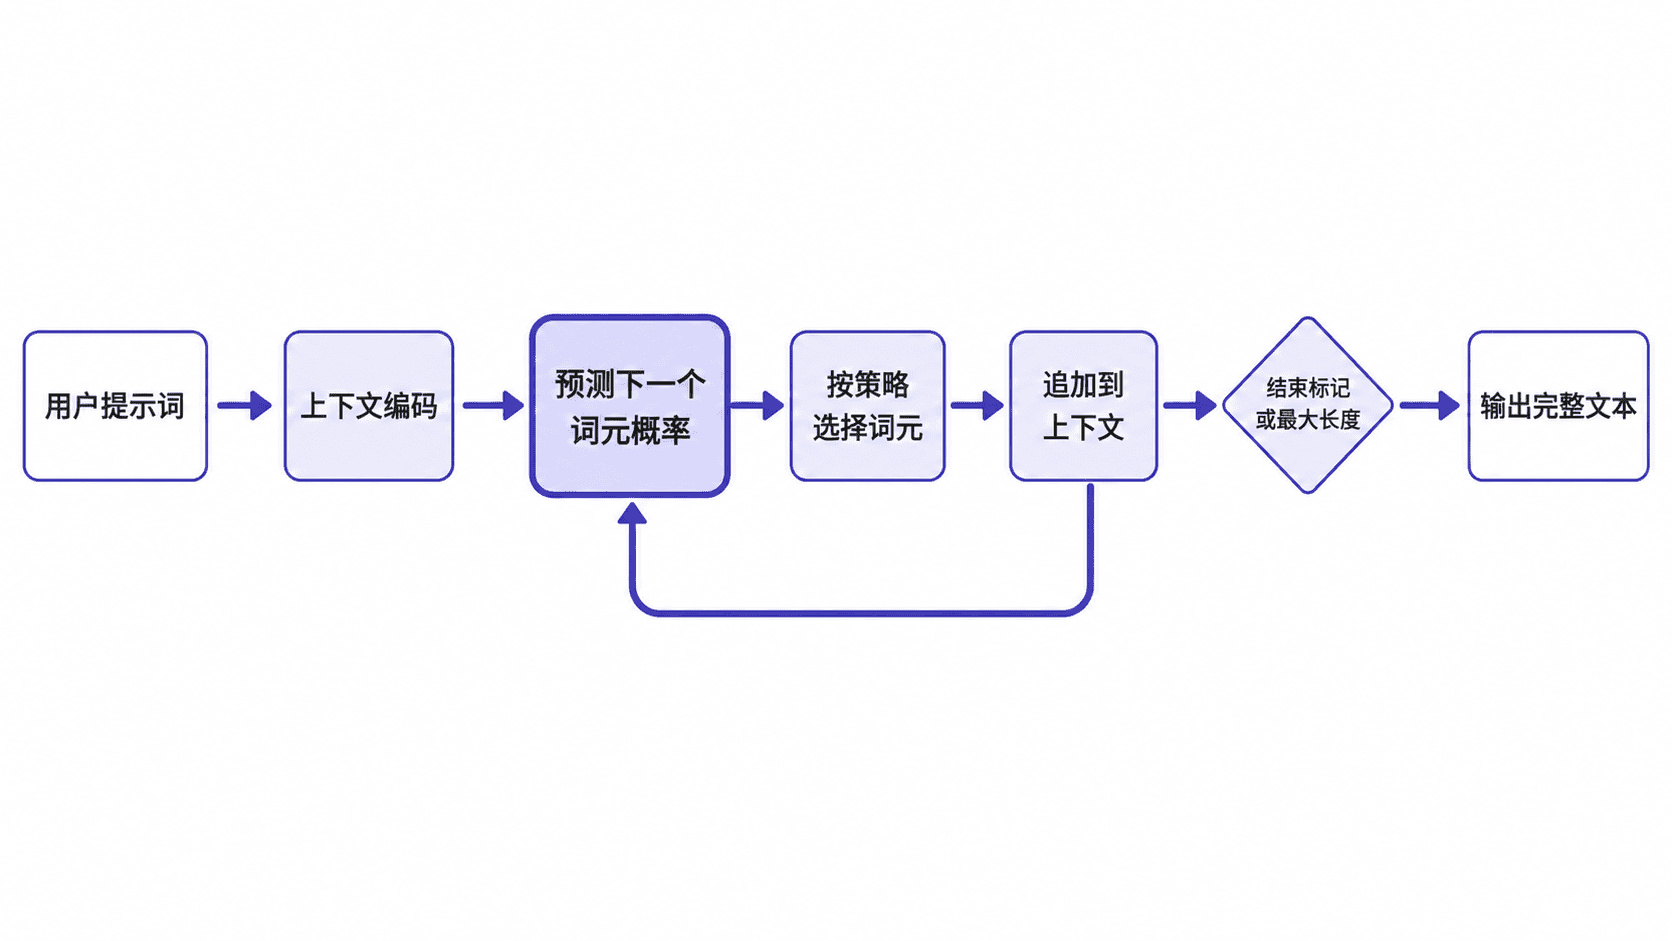
这种机制决定了生成具有路径依赖:前面选中的一个词元,会改变后续全部概率。因此,即使提示词完全相同,只要中途采样不同,最终答案也可能明显不同。
采样参数如何改变输出
常见参数控制的是“从概率分布中怎样选下一个词元”,而不是直接改变模型掌握的知识。
| 参数 | 作用 | 常见影响 |
|---|---|---|
温度 temperature |
采样前按正温度 将 logit 除以 | 较低时概率更集中,较高时更平坦 |
| Top-k | 只保留概率最高的 k 个候选 | 限制候选范围,减少极低概率词元 |
| Top-p | 按概率从高到低保留达到 p 的最短前缀,再对保留项归一化 | 候选数量会随当前分布改变 |
| 最大输出长度 | 限制最多生成多少词元 | 防止回答过长,但过小可能截断 |
| 随机种子 | 固定部分随机过程 | 只能提高可复现性,不能保证跨模型和跨版本完全一致 |
低温度不等于绝对正确,高温度也不等于一定有创意。参数只改变选择方式,不能补充模型缺失的事实,也不能消除幻觉。
用三项分布比较温度与 Top-p
以下只算一步。用三个已知概率的对数作为分数,固定 Top-p 为 0.7,仅把温度从 1 改为 0.5。这里按照分数降序处理,平分时保留原顺序。实际接口在并用 Top-k 和 Top-p 时还要查实现的先后顺序。
from math import exp, fsum, isfinite, log
from random import Random

def nucleus(logits, temperature, p):
    if not logits or not all(isfinite(z) for z in logits):
        raise ValueError("需要非空有限分数")
    if not isfinite(temperature) or temperature <= 0 or not 0 < p <= 1:
        raise ValueError("需要正温度与 0 < p <= 1")
    pivot = max(logits)
    weights = [exp((z - pivot) / temperature) for z in logits]
    total = fsum(weights)
    order = sorted(range(len(logits)), key=lambda i: -logits[i])
    kept = []
    cumulative = 0.0
    for i in order:
        kept.append(i)
        cumulative += weights[i] / total
        if p < 1 and cumulative >= p:
            break
    kept_total = fsum(weights[i] for i in kept)
    return kept, [weights[i] / kept_total for i in kept]

tokens = ["A", "B", "C"]
logits = [log(p) for p in (0.6, 0.3, 0.1)]
rng = Random(7)
for temperature in (1.0, 0.5):
    kept, weights = nucleus(logits, temperature, 0.7)
    candidates = [tokens[i] for i in kept]
    print(temperature, candidates, [round(p, 3) for p in weights])
    print("采样:", rng.choices(candidates, weights=weights, k=4))
温度为 1 时,A 的概率为 0.6,加入 B 才达到 0.7,因此保留 A 和 B,重新归一化后约为 0.667 和 0.333。温度为 0.5 时,A 在截断前就约为 0.783,因此只保留 A。固定种子用于本地重复这个小实验。
要禁用采样,优先用接口明确支持的贪心开关。例如 Transformers 中可设置 do_sample=False、num_beams=1,温度采样公式需要正温度,不能直接除以 0。抽取或总结应在同一模型、提示、输出上限和样例上比较,再核对事实和格式。
稳定输出的关键边界
要提高稳定性,首先应把任务约束写进提示词,例如规定输出字段、篇幅、语气和禁止内容。对必须机器解析的结果,还应使用结构化输出、字段校验和失败重试,而不是只依赖低温度。
同样的参数也可能得到不同答案,因为服务端实现、模型版本、并行计算和随机采样都会产生影响。对金融、医疗、法律或生产操作等高风险任务,生成结果还需要外部事实校验和人工确认。