
机器学习与深度学习 / 系统课时
图像预处理
图像预处理
原始图像的尺寸、数值范围和构图往往不一致,不能直接稳定送入模型。本课将把缩放、裁剪、归一化和数据增强串成一条可验证的处理链,并说明训练与推理阶段应保持哪些一致性。
学习目标
- 说明常见预处理步骤的目的
- 按固定顺序处理图像数组
- 区分确定性预处理与随机数据增强
一条典型处理链
缩放用于统一尺寸,裁剪用于保留目标区域,归一化用于统一数值尺度。训练阶段还可加入随机翻转、旋转或颜色扰动,扩展样本变化;推理阶段通常关闭随机增强,保证同一输入得到稳定结果。
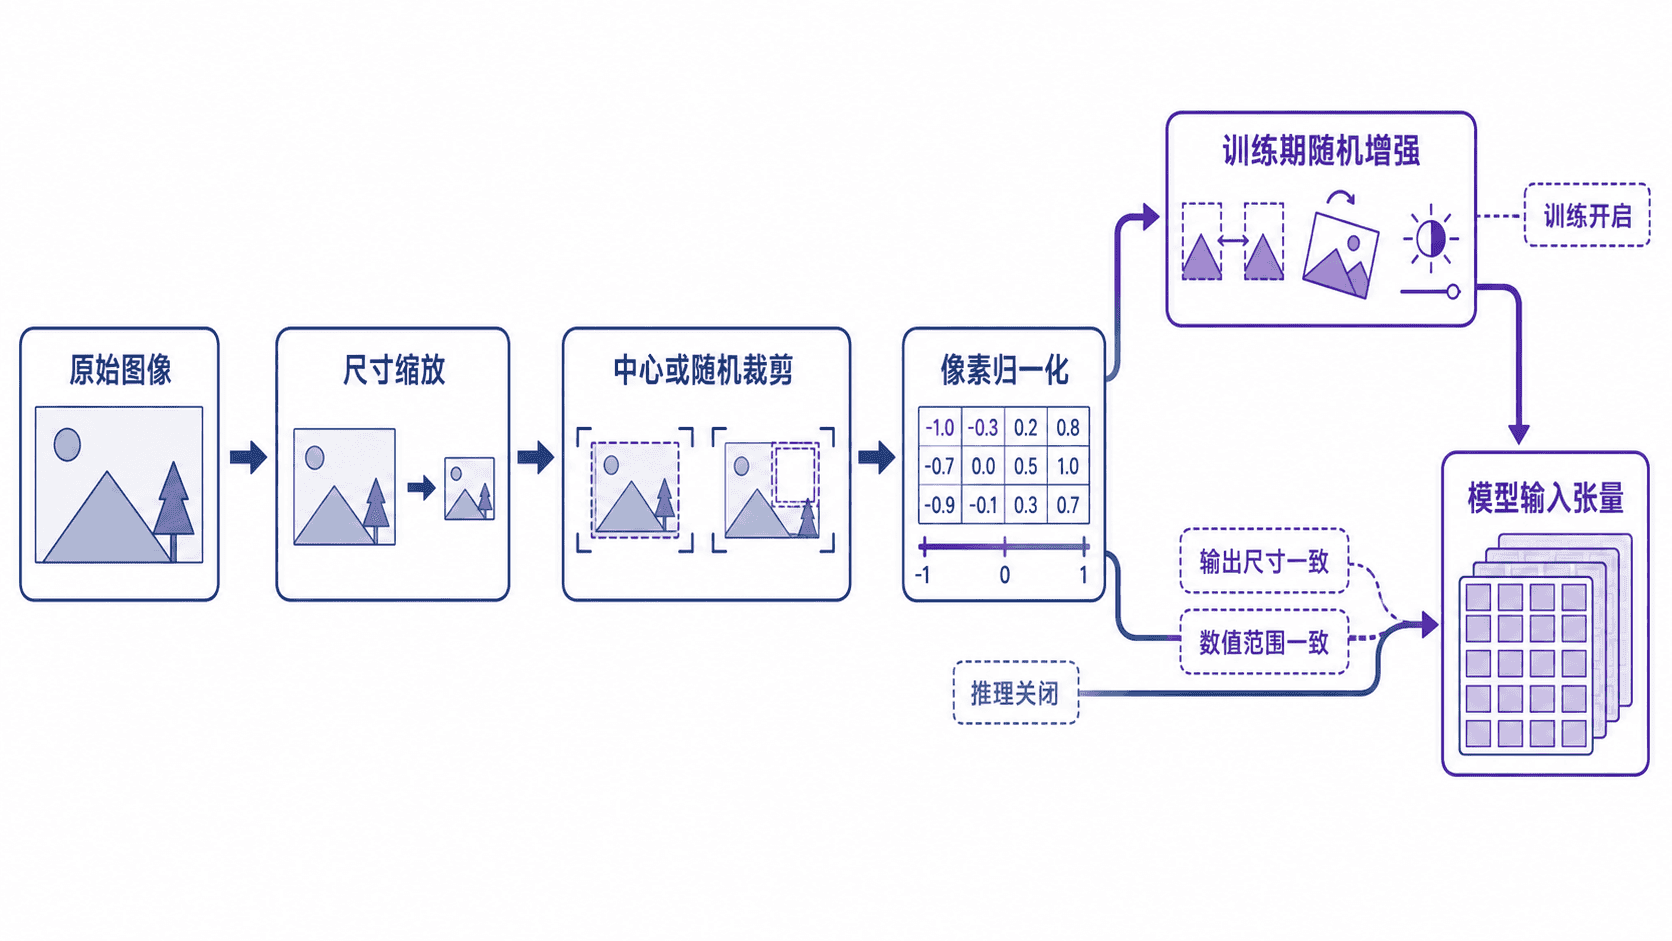
处理顺序应由模型训练约定决定。若模型训练时使用 RGB、固定尺寸和特定均值方差,推理时要复用确定性的训练输入约定,避免无意改变分布。若评估方案明确采用测试时增强,应记录变换与结果合并规则。
完成一个数组预处理示例
下面使用 NumPy 对一张 4×4 灰度图执行最近邻缩放、左上裁剪、归一化和水平翻转。本例使用端点对齐的坐标,恰好位于两个像素之间时取较大索引,单像素目标对齐起点。不同库的最近邻坐标与平局约定可能不同,替换时应比对样本结果。示例使用 uint8,除数固定为 255。
import numpy as np

def nearest_indices(source_size, target_size):
    if source_size <= 0 or target_size <= 0:
        raise ValueError("尺寸必须为正")
    coordinates = np.linspace(0, source_size - 1, target_size)
    return np.floor(coordinates + 0.5).astype(np.intp)

def resize_nearest(image, new_height, new_width):
    rows = nearest_indices(image.shape[0], new_height)
    cols = nearest_indices(image.shape[1], new_width)
    return image[np.ix_(rows, cols)]

image = np.arange(16, dtype=np.uint8).reshape(4, 4)
resized = resize_nearest(image, 3, 3)
cropped = resized[:2, :2]
normalized = cropped.astype(np.float32) / 255
augmented = np.fliplr(normalized)
print("缩放索引:", nearest_indices(4, 3).tolist())
print("裁剪像素:", cropped.tolist())
print("翻转后:", np.round(augmented, 3))
4→3 对应索引 [0, 2, 3]。左上裁剪得到 [[0, 2], [8, 10]]。水平翻转后的第一行为 [0.008, 0.000],第二行为 [0.039, 0.031](约值)。
水平翻转只改变空间位置,不改变数值范围。对于数字识别等方向敏感任务,翻转可能改变语义,不能机械套用。
一致性与常见错误
随机增强只在训练阶段生成变化样本;缩放尺寸、颜色通道、归一化均值和标准差则必须在训练与推理阶段一致。最好把这些规则保存为模型配置,而不是散落在不同代码路径中。
验证增强是否合理时,应查看处理后的样本,并确认标签仍然成立。例如,轻微裁剪可能保留物体类别,过度裁剪会删除关键区域。检测框和分割掩码要同步做几何变换,离散类别掩码的插值需保留类别值。
上线前用同一小样本做逐阶段核对,记录解码方向、宽高、通道顺序、插值及抗锯齿、裁剪位置、数据类型和数值变换。即使几何目标一样,算子次序和整数舍入也可能改变像素结果。另一个常见错误是把高度和宽度写反,导致图像被拉伸或张量形状不匹配。