
机器学习与深度学习 / 系统课时
K 均值聚类
K 均值聚类
给定 ,K 均值寻找一组中心,使样本到最近中心的平方欧氏距离之和尽量小。这一目标也叫簇内平方和或 inertia。每一簇的中心是其成员坐标的均值,可以落在原数据点之外。
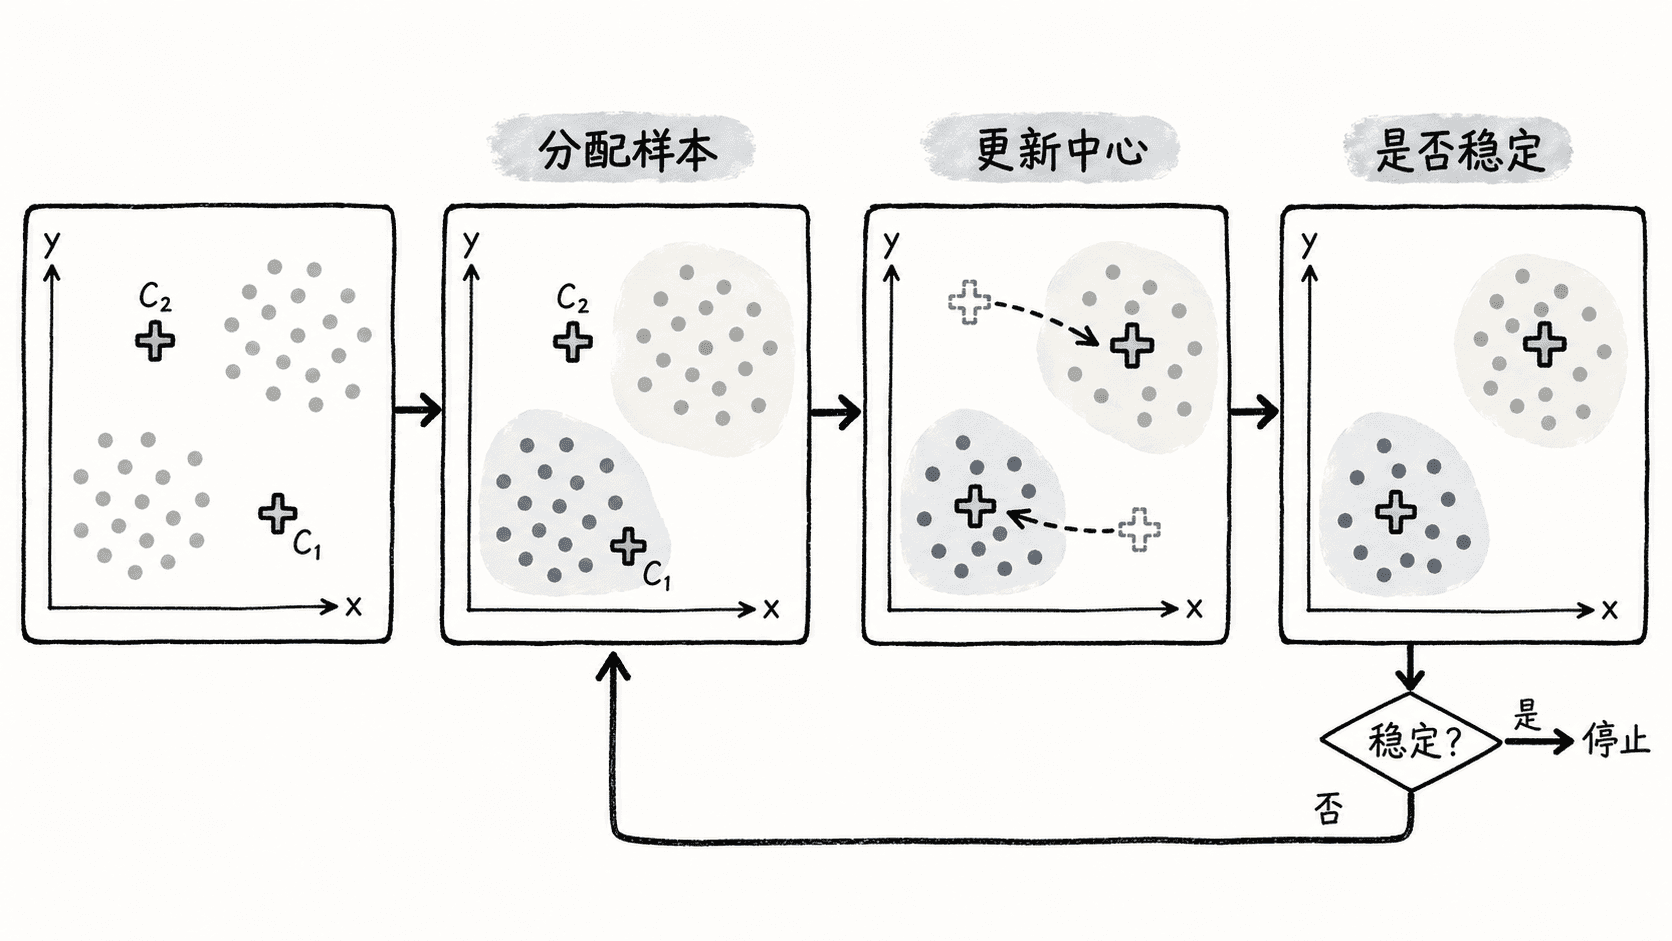
两步迭代
- 把每条样本分给最近的中心,距离相同则按确定的顺序取一个。
- 对每个非空簇重新计算中心。分配稳定时结束,也可以设置迭代上限。
平方距离和欧氏距离给出相同的最近中心,因此分配阶段省略开平方。这两步交替优化一个目标,可能停在与初始中心有关的局部解。固定中心可以复现实验,实际可用 K-means++ 初始化并比较多次运行的 inertia。
用 Python 拟合二维样本
下面仅用标准库处理二维有限数值。初始中心固定。当遇到空簇或到达上限尚未确认稳定时,示例主动报错,防止返回互相不一致的中心和标签。不同库对这两种情形可采取不同的收尾策略。
python
from statistics import mean

def distance2(a, b):
    return (a[0] - b[0]) ** 2 + (a[1] - b[1]) ** 2

def k_means(points, centers, max_iter=30):
    if not points or not 1 <= len(centers) <= len(points) or max_iter < 1:
        raise ValueError("需要非空数据、有效的中心数量和迭代上限")

    previous = None
    for _ in range(max_iter):
        labels = [min(range(len(centers)), key=lambda i: distance2(p, centers[i]))
                  for p in points]
        if labels == previous:
            inertia = sum(distance2(p, centers[i]) for p, i in zip(points, labels))
            return centers, labels, inertia

        groups = [[] for _ in centers]
        for point, label in zip(points, labels):
            groups[label].append(point)
        if any(not group for group in groups):
            raise ValueError("出现空簇,请换一组初始中心或减小 K")
        centers = [(mean(x for x, _ in group), mean(y for _, y in group))
                   for group in groups]
        previous = labels

    raise RuntimeError("达到迭代上限,分组尚未确认稳定")

points = [(1.0, 1.0), (1.5, 2.0), (3.0, 4.0),
          (5.0, 7.0), (3.5, 5.0), (4.5, 5.0)]
centers, labels, inertia = k_means(points, [(1.0, 1.0), (5.0, 7.0)])
print("中心:", [tuple(round(v, 2) for v in center) for center in centers])
print("分组:", labels)
print(f"簇内平方和: {inertia:.2f}")
中心约为 (1.83, 2.33) 和 (4.33, 5.67),分组为 [0, 0, 0, 1, 1, 1],簇内平方和约为 10.67。点 (3, 4) 在第一轮与两个初始中心等距,示例选索引较小者。交换中心的编号不会改变目标函数,但在恰好等距时,绑定到索引的取舍可能改变迭代路径。
怎么选 K 和解释结果
在同一批样本、同一套缩放与距离定义下比较多个 。最优的簇内平方和通常随 增大而不升,但有限次初始化的实跑值可能偏离。肘部图可以提示收益何时变缓,轮廓系数可补看簇内紧密程度和簇间分离程度,它要求实际标签数介于 2 与样本数减 1 之间。再检查不同种子下的稳定性、簇大小和业务可解释性。
若消费金额和购买频率的量纲不同,先决定哪个差异应在距离里占多大权重。对线上分群,在训练数据上拟合缩放并复用同一变换。K 均值对离群点敏感,也容易把细长、环形或不同密度的簇切开。下一课将比较可用不同连接方式构造的层次聚类。
按自己的节奏,确认真正理解。