
机器学习与深度学习 / 系统课时
大语言模型训练过程
大语言模型训练过程
从基础语言模型训练对话助手时,常见流程包括预训练、指令微调和偏好优化。公开项目可能跳过某个阶段,也可能多轮交错使用任务示范、强化学习和专项训练。
学习目标
- 说清预训练、指令微调和偏好对齐各自解决的问题
- 理解不同阶段的数据形式和优化目标为何不同
- 认识“知识能力”和“行为对齐”不是同一件事
预训练先学会预测语言
预训练阶段会使用规模很大的文本语料。对于自回归语言模型,最常见目标是“根据前文预测下一个 Token”。模型不断比较预测分布与真实下一个 Token,计算损失并更新参数。
例如训练片段是“机器学习可以从数据中发现”,预测的具体下一项由分词器决定。“发现”可能是一个词元,也可能拆成多个。预测每个位置时只能利用该位置之前的词元,目标通常取原序列向后移动一位。重复海量次后,模型逐渐学习词法、语法、事实关联、文本结构以及一定程度的推理模式。
在大规模从头训练中,这一阶段通常消耗大量语料和算力,目标主要是获得通用能力,而不是让模型天然懂得“请按三点回答”“拒绝危险请求”或“不要编造来源”等交互规则。
指令微调学习按要求完成任务
预训练后的模型会续写文本,但未必稳定遵守用户指令。指令微调会使用“指令—理想回答”形式的数据,让模型学习把自然语言要求映射到期望输出。
例如同一个知识点,预训练数据可能只是普通文章;指令数据则会明确写成“请用一句话解释过拟合”,并提供符合要求的答案。训练目标仍可以是预测目标回答中的下一个 Token,但训练样本的组织方式已经从“自然文本”变成“任务示范”。
指令微调可以改善任务格式、工具调用和部分领域任务,但效果取决于样本与基础模型。用与训练数据隔离的任务集分别测格式遵循、事实准确率和泛化。
核对哪些目标参与损失
以下用手工词元序列演示下一项的目标位置。每对的左侧只显示目标之前的最后一个词元,实际因果语言模型可使用可见前缀。仅计算回答损失时,问题和回答标记仍作为上下文,目标从“示例”开始计分。本例还约定把结束词元计入回答损失。
tokens = ["<bos>", "问题", "<答>", "示例", "<eos>"]
first_answer = 3

def next_token_pairs(tokens, first_target=1):
    if not 1 <= first_target < len(tokens):
        raise ValueError("目标位置需要有前文且在序列范围内")
    return [(tokens[pos - 1], tokens[pos])
            for pos in range(first_target, len(tokens))]

print("所有目标:", next_token_pairs(tokens))
print("仅回答目标:", next_token_pairs(tokens, first_answer))
全序列有四个可计分目标。回答掩码只保留 (<答>, 示例) 和 (示例, <eos>) 两对。实际掩码由训练器和聊天模板确定,尤其要核对角色标记、结束符及 padding 是否计分。
偏好对齐调整回答行为
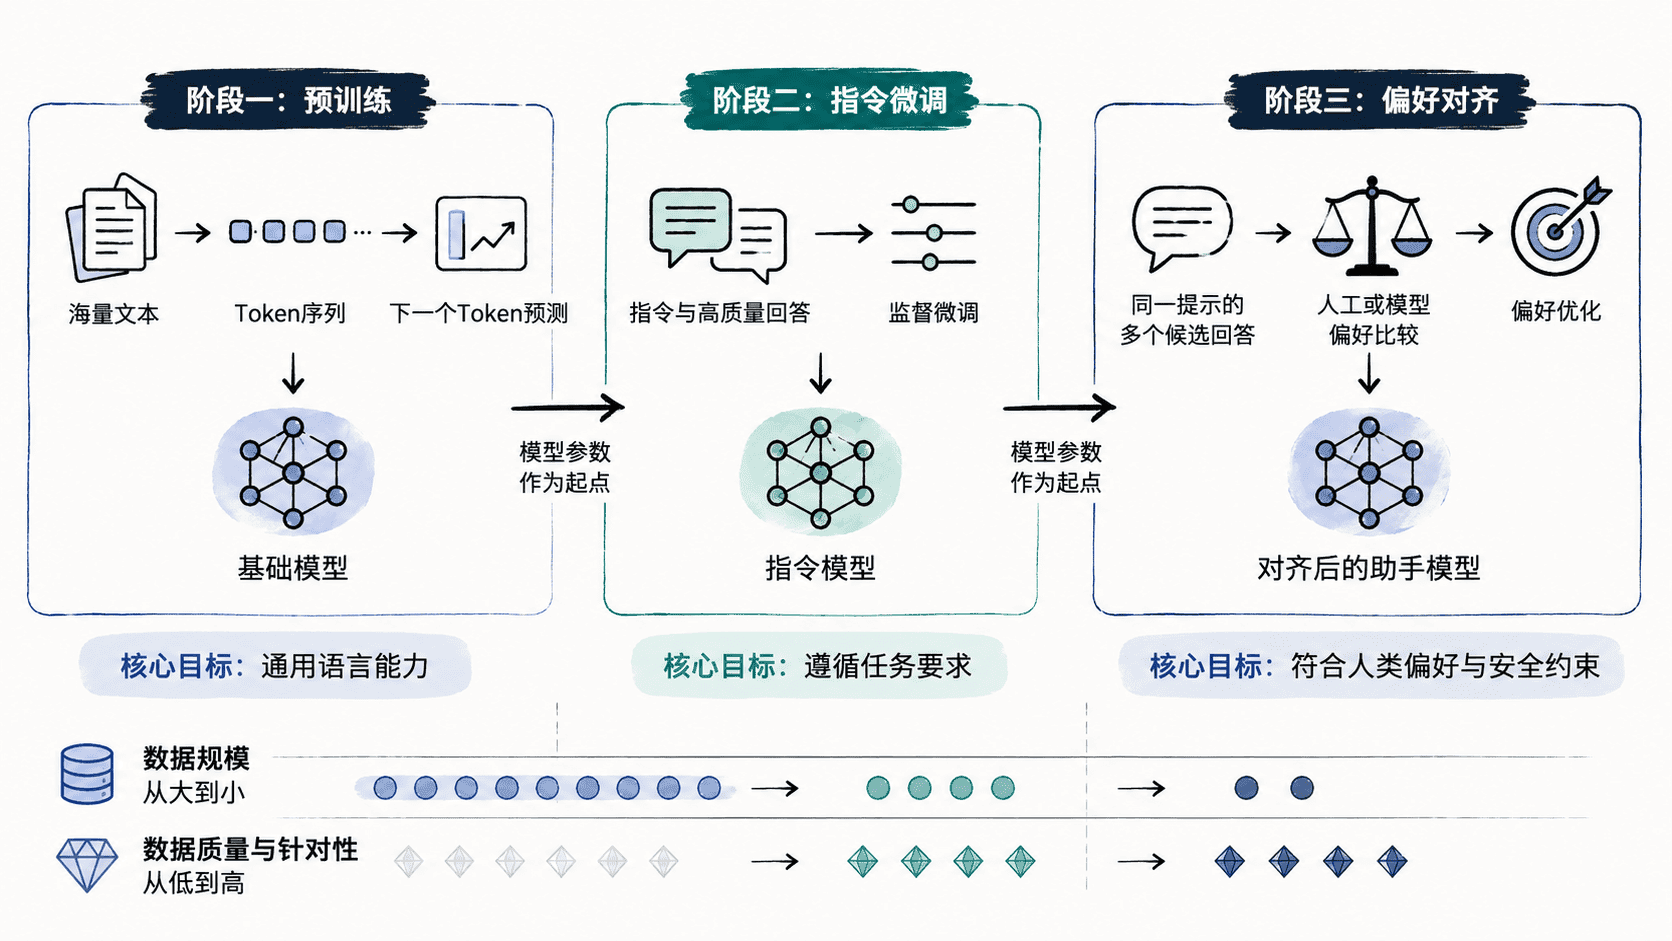
偏好对齐关注的不是“哪一句是语料中的真实续写”,而是“多个可行回答中,人类更希望模型输出哪一个”。早期常见方法是基于人类反馈的强化学习:先收集偏好比较,训练奖励模型,再用强化学习优化语言模型。
原始 DPO 使用同一提示下的成对偏好,比较训练模型与参考模型对这两段回答的相对对数概率,直接优化偏好目标。偏好标签体现样本及评价标准,可能奖励冗长等代理特征。应另用评估集检验事实性、安全和指令遵循。
三个阶段不要混为一谈
可以用三个问题区分它们:预训练回答“模型会不会语言和通用任务”,指令微调回答“模型是否知道用户要它怎么做”,偏好对齐回答“多个可能回答中,它应该更倾向哪一种”。
实际训练体系还可能加入领域继续预训练、工具使用训练、推理数据训练和安全专项训练,这些训练可在多个阶段反复进行,也可能同时改变任务能力与行为。阶段名称提供了组织方式,实际效果仍以数据、目标和独立评估为准。
因此,看到一个大模型表现发生变化时,不应只问“它训练了多少数据”。更重要的是确认变化发生在哪个阶段、使用了什么数据以及优化目标是什么,因为这三项共同决定模型最终“会什么”和“倾向怎么回答”。