
机器学习与深度学习 / 系统课时
人工智能的主要分支
人工智能的主要分支
人工智能并不是一种单一技术,而是一组解决不同类型智能任务的方法。本篇从学习方法、视觉与语言领域及机器人系统这几条轴入手,弄清它们分别处理什么问题,以及为什么实际系统经常同时使用多个分支。
学习目标
- 说清机器学习、计算机视觉、自然语言处理和机器人的核心任务
- 根据输入数据和目标判断一个问题主要属于哪个人工智能方向
- 理解不同分支之间可以组合,而不是彼此完全独立
四个分支关注的问题不同
区分人工智能分支时,最实用的方法不是死记名称,而是看系统接收什么信息、需要产生什么结果。机器学习更像一组从数据中学习规律的方法;计算机视觉重点处理图像和视频;自然语言处理面向人类语言;机器人则把感知、决策和动作连接到真实世界。
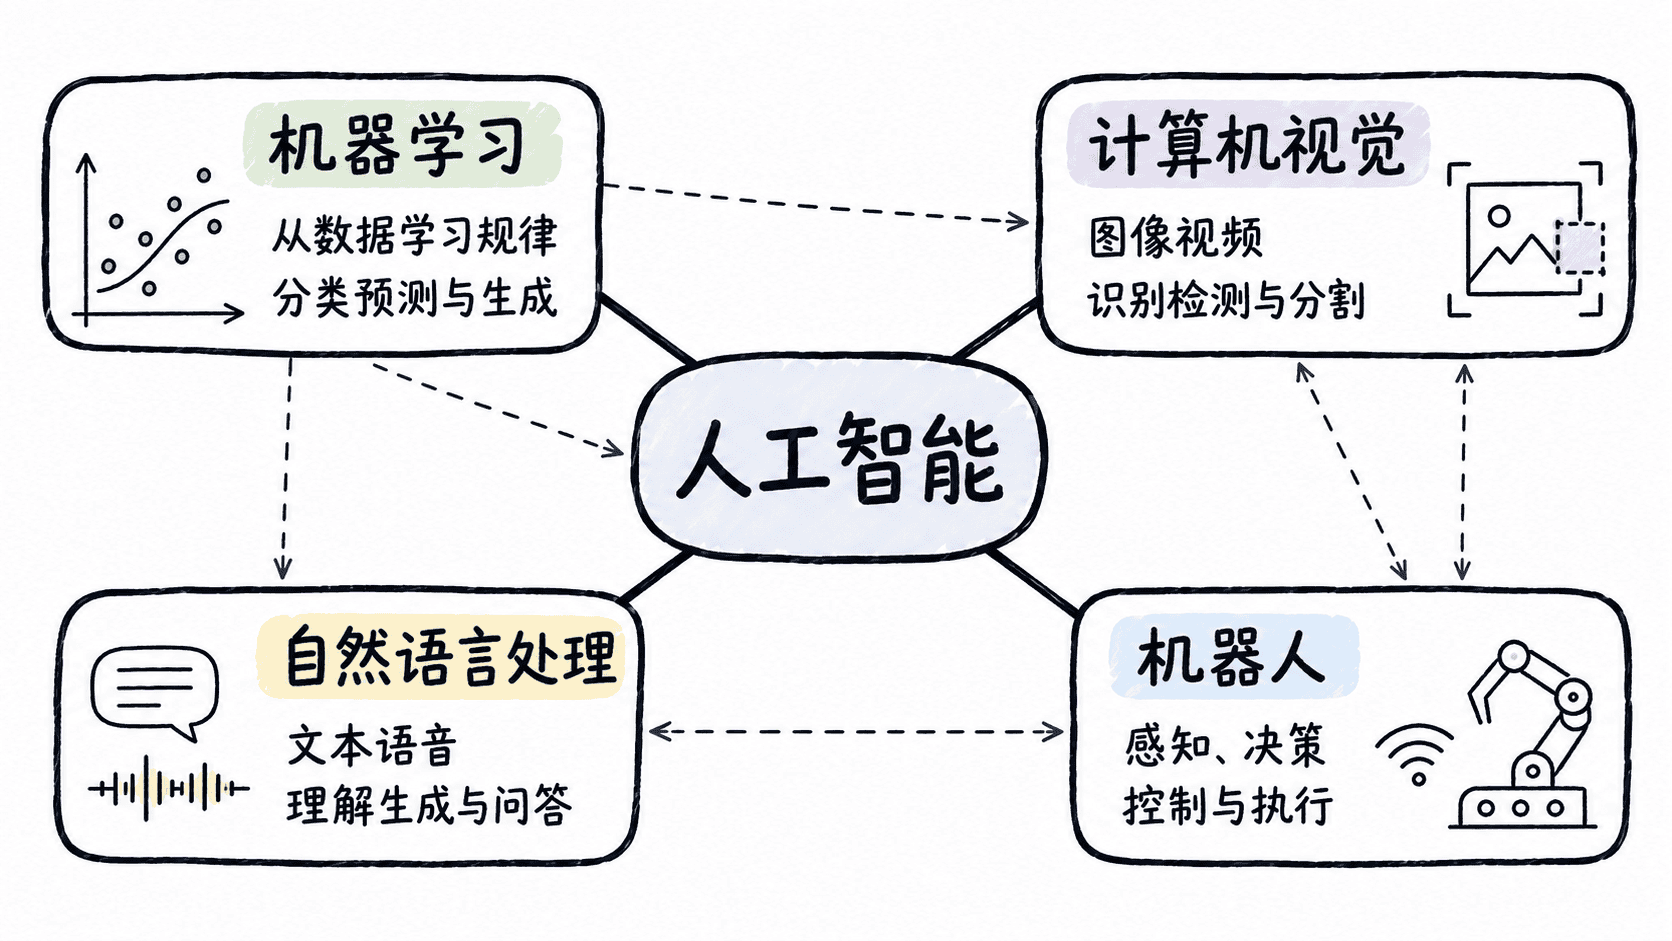
这里有一个容易混淆的地方:这四类并不处在完全相同的分类层级。机器学习更偏向通用方法,视觉和语言更偏向任务领域,机器人则强调智能系统与物理环境交互。 因此,一台机器人可能同时使用机器学习、视觉和语言模型。
机器学习从数据中学习规律
传统程序通常由开发者明确写出规则,而机器学习让模型根据样本数据调整内部参数。例如,垃圾邮件识别系统可以从大量“垃圾邮件”和“正常邮件”样本中学习特征,再判断新邮件属于哪一类。
机器学习常见任务包括分类、数值预测、聚类、推荐和生成。深度学习属于机器学习的重要技术路线,它利用多层神经网络处理复杂模式,视觉、语言和语音都可以使用深度学习,也可按任务选择模板匹配、规则或较小的统计模型。
计算机视觉理解图像和视频
计算机视觉解决的是“机器如何从视觉数据中提取有用信息”。输入通常是照片、视频帧或医学影像,输出可能是类别、物体位置、像素区域或人物姿态。
例如,生产线相机发现零件表面划痕属于视觉检测;手机识别人脸属于视觉识别;自动驾驶系统确定车辆、行人和车道线的位置,则会组合目标检测、分割和跟踪等视觉能力。
自然语言处理理解和生成人类语言
自然语言处理关注文本、语音转写后的文字以及语言之间的关系。搜索意图识别、机器翻译、文本摘要、情感分析、智能问答和对话生成都属于这一方向。
大语言模型让自然语言处理的能力范围进一步扩大,一个模型可以同时完成问答、写作、信息抽取和代码辅助等任务。但模型能够生成流畅语言,并不意味着它产生的每个事实都一定正确,实际应用仍需要数据来源、规则或人工审核进行约束。
机器人把智能转化为动作
机器人系统不仅要“知道发生了什么”,还要决定下一步动作并通过机械装置执行。典型链路是传感器感知环境,算法估计状态并规划动作,控制系统驱动电机或执行器,随后再读取新的环境反馈。
工业机械臂、仓储机器人和服务机器人都属于这一方向。机器人不一定具有人形外观,也不一定使用学习模型。有些机械臂按预定轨迹运行。是否采用视觉识别、规划或数据学习,应看各部件实现。
判断问题时先看输入与目标
看到一个人工智能应用时,可以先问两个问题:系统主要处理的输入是什么,以及最终要产生什么结果。图像识别通常首先归入计算机视觉,文本分类首先归入自然语言处理,销量预测是一个任务,可用历史均值作为基线,也可训练时间序列或回归模型。先明确任务,再说明采用的实现方法。如果系统最终还需要在现实环境中移动、抓取或控制设备,则通常还涉及机器人技术。
真实产品很少只属于一个分支。自动驾驶汽车就是典型例子:视觉系统识别道路环境,机器学习模型进行预测,规划模块做决策,车辆控制系统执行转向和制动。例如质检机器人可用视觉定位零件、学习模型判断类型、规则触发复核,最后由控制器执行动作。下面用测量长度演示有标签的参数学习。两个中心来自样本均值,最近中心给出分类,平局交人工。它演示方法,不代替实际视觉或尺寸公差检查。
from statistics import mean

def fit_centers(samples):
    groups = {}
    for label, length_mm in samples:
        groups.setdefault(label, []).append(length_mm)
    if len(groups) < 2:
        raise ValueError("至少需要两个类别的示例")
    return {label: mean(lengths) for label, lengths in groups.items()}

def predict(centers, length_mm):
    distance = min(abs(length_mm - center) for center in centers.values())
    matches = [label for label, center in centers.items() if abs(length_mm - center) == distance]
    return matches[0] if len(matches) == 1 else "待复核"

samples = [("短件", 4), ("短件", 6), ("长件", 10), ("长件", 12)]
centers = fit_centers(samples)
print(centers)
for length in (6, 8, 10):
    print(length, predict(centers, length))
中心为短件 5 mm、长件 11 mm。6 mm 判短件,8 mm 待复核,10 mm 判长件。真实任务需要另备测试样本,测量误差和样本分布变化也会影响结果。