
机器学习与深度学习 / 系统课时
决策树
决策树
决策树把预测拆成从根节点到叶节点的一连串判断。节点可以判断访问次数是否超过 5,分支表示条件的结果,叶节点输出预测。分类树常用叶节点的类别分布及占比最高的类别。回归树的叶节点输出取决于损失,例如平方误差用均值,绝对误差用中位数。
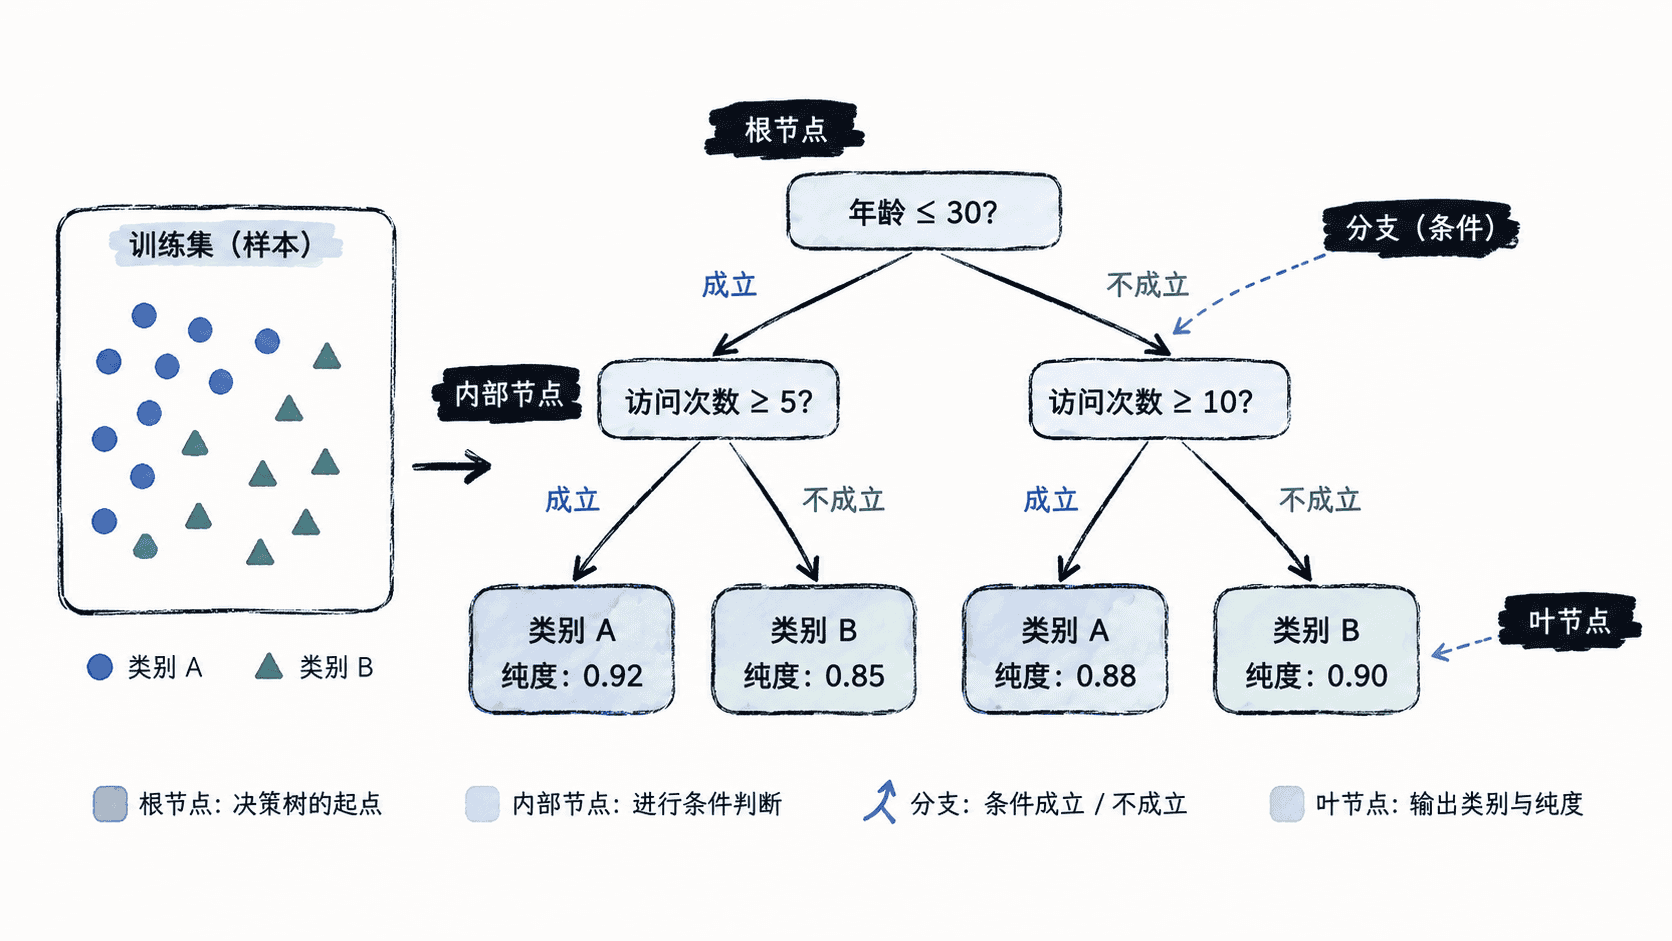
按样本量比较切分
设节点各类占比为 。分类树可用基尼不纯度 ,也可用熵等准则。二叉切分时,按子节点样本数对不纯度加权,再求父节点与切分后的差:
$$
G_{\text{after}}=\frac{n_L}{n}G_L+\frac{n_R}{n}G_R,\qquad \Delta G=G_{\text{parent}}-G_{\text{after}}.
$$
父节点有 6 个正类和 4 个负类,。候选 A 将 4 个正类放到左侧,剩下 2 个正类和 4 个负类在右侧。左节点不纯度为 0,右节点为 ,加权结果是 ,改善约 0.213。候选 B 两侧各有 3 个正类和 2 个负类,两侧类别比例都与父节点相同,改善为 0。下例使用 Python 3.10 或更新版本,以有理数复算。
from fractions import Fraction

def gini(counts):
    total = sum(counts)
    if total == 0:
        raise ValueError("子节点不能为空")
    return 1 - sum(Fraction(count, total) ** 2 for count in counts)

def split_score(left, right):
    left_size, right_size = sum(left), sum(right)
    total = left_size + right_size
    parent = tuple(a + b for a, b in zip(left, right, strict=True))
    weighted = (left_size * gini(left) + right_size * gini(right)) / total
    return weighted, gini(parent) - weighted

for left, right in [((4, 0), (2, 4)), ((3, 2), (3, 2))]:
    weighted, gain = split_score(left, right)
    print(f"切分后={weighted} ({float(weighted):.3f}), 改善={gain}")
常见的树训练器逐节点比较候选,优先采用当前节点得分较好的可行切分。某一层的最优选择是局部的,整棵树的结构会受样本、候选范围和停止条件影响。
走路径并核对输入含义
预测时,从根节点依次判断新样本满足哪一侧条件,直到叶节点。可用路径复盘单次预测。例如访问次数超过 5 且为会员的样本,会进入训练样本购买占比更高的某个叶子。叶子样本量很小时,尤其要谨慎解释占比。
数值特征通常尝试排序后的候选阈值,无需为了比较阈值做标准化。类别特征能否直接输入取决于实现。scikit-learn 的常规决策树需要数值表示,可用只在训练集拟合的独热编码处理无序类别,并定义未知类别的行为。把无序类别编码成连续整数会引入人为顺序,切分条件的意义也随之改变。
用验证结果控制复杂度
限制最大深度、设置最小叶样本数、要求最小不纯度下降或进行代价复杂度剪枝,都可降低小叶子记住噪声的概率。用同一验证方案比较不同设置,关注关键类别和数据切片。若深树训练准确率上升而验证表现下降,优先检查过拟合和切分代表性。随机森林和梯度提升树都可以使用多棵树,单树的节点与叶子仍是理解它们的基础。