
可观测性与稳定性 / 系统课时
整理监控上线检查清单
整理监控上线检查清单
监控平台能显示几张图并不等于已经可以上线。正式交付前,需要同时确认采集目标、标签、Dashboard、告警规则、历史数据保留以及 Prometheus 自身健康状态。本节把这些检查收敛为一套可重复执行的上线门禁,减少“有监控但出事时用不了”的情况。
学习目标
- 建立覆盖采集、展示、告警、存储和自监控的上线检查顺序
- 识别 Target、Label 和 Dashboard 中常见的上线风险
- 使用 Prometheus 自带接口和
promtool完成基础技术验证
把上线检查变成连续门禁
检查顺序很重要。Target 还在失败时,继续验收 Dashboard 没有意义;标签设计不稳定时,告警路由和面板变量也容易随后返工。建议按“采集 → 标签 → 展示 → 告警 → 保留 → 自监控”的顺序逐关确认。
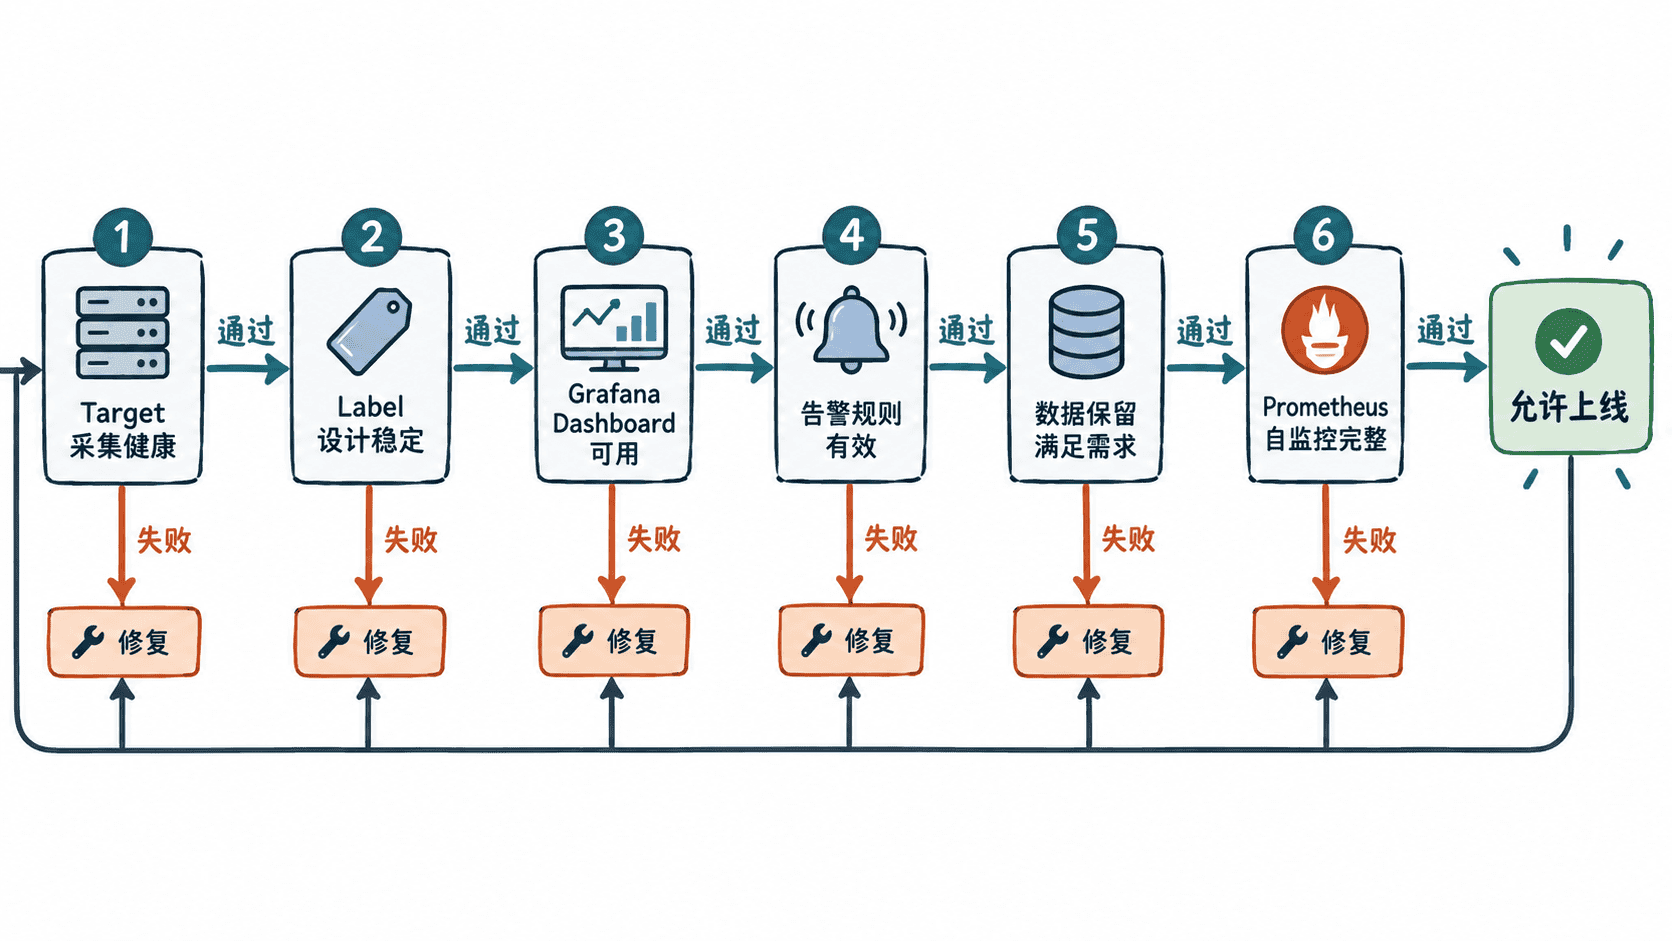
这套顺序可以避免后面的 Dashboard 和告警建立在错误数据上。上线检查最好由另一位维护者按照清单重新走一遍,因为“配置作者自己能看懂”并不能证明故障发生时其他人也能快速定位。
检查 Target 与 Label
Target 首先要满足两个条件:应该采集的实例全部存在,并且持续处于可抓取状态。短暂成功不能替代持续稳定,还要观察抓取时延、失败次数以及是否存在频繁上下线的目标。
Label 则承担检索、聚合、Dashboard 变量和告警路由的基础职责。至少检查 job、instance 以及团队约定的环境、区域或角色标签是否稳定;不要把请求 ID、时间戳、随机字符串等高基数字段放进常驻标签。
| 检查项 | 上线前应确认的结果 |
|---|---|
| Target | 预期实例均被发现并正常抓取 |
job |
能稳定表示采集任务或服务类别 |
instance |
能唯一定位实际被监控实例 |
| 环境类标签 | 命名统一,可用于筛选与告警路由 |
| 高基数风险 | 不存在持续产生大量新取值的业务标签 |
最简单的全局检查可以从 up 开始:结果为 0 的时间序列必须逐个解释,不能因为 Dashboard 上“多数服务器正常”就忽略少数失败实例。
验收 Dashboard 与告警规则
Dashboard 的验收重点不是布局是否漂亮,而是故障时能否回答问题。服务器监控至少应能快速确认主机是否在线、CPU 与负载是否异常、内存是否紧张、磁盘容量和 I/O 是否异常,以及网络是否存在明显变化。
面板变量还要实际切换多个实例验证,避免查询表达式把主机写死。没有数据时应能区分“指标确实为零”和“查询条件没有匹配任何时间序列”。
告警规则则需要检查表达式、阈值、持续时间和标签信息是否能支撑处理动作。规则中的摘要可以描述现象,但用于定位的 instance、文件系统、设备或服务等标签必须保留下来。上线前至少手工模拟一次可控故障,确认告警能够触发并在故障恢复后解除。
验证 Prometheus 配置和服务状态
下面的检查适合放入上线前操作记录。promtool 用于验证 Prometheus 配置以及配置中引用的规则文件;HTTP readiness 接口用于确认当前 Prometheus 进程已经可以正常提供服务。
set -euo pipefail
PROMETHEUS_URL=${PROMETHEUS_URL:-http://127.0.0.1:9090}
CONFIG_PATH=${CONFIG_PATH:-/etc/prometheus/prometheus.yml}

promtool check config "$CONFIG_PATH"
curl -fsS "$PROMETHEUS_URL/-/ready"预期输出:promtool 应以退出码 0 完成,并显示配置检查成功;不同 Prometheus 版本的详细文字可能不同。readiness 接口成功时返回服务已就绪的信息。
Checking <PATH>
SUCCESS
Prometheus Server is Ready.
如果这里失败,不应继续做上线操作。配置语法错误、规则文件无法加载或 Prometheus 尚未就绪,都意味着后续 Dashboard 与告警验证缺乏可信数据源。
核对数据保留与自监控
历史数据保留时间要根据排障周期和容量规划确定,而不是沿用测试环境配置。确认 Prometheus 实际启动参数或部署配置中设置的 TSDB 保留策略,并估算当前序列规模增长后磁盘是否仍有足够余量。若使用远程写入,还要把远端存储可用性和写入积压纳入检查。
Prometheus 自己也必须被监控。至少应能确认 Prometheus 进程存活、自身指标可采集、规则能够持续计算,并观察资源占用和时间序列规模是否出现异常增长。最基础的自检可以同时查询 prometheus_build_info 和 up。
set -euo pipefail
PROMETHEUS_URL=${PROMETHEUS_URL:-http://127.0.0.1:9090}

curl -fsSG "$PROMETHEUS_URL/api/v1/query" --data-urlencode 'query=prometheus_build_info'
curl -fsSG "$PROMETHEUS_URL/api/v1/query" --data-urlencode 'query=count(up == 0)'
预期结果:两个请求的 HTTP 调用都应成功并返回 Prometheus API 的 JSON;第一个查询至少能取得当前 Prometheus 实例的构建信息。第二个查询返回当前不可抓取 Target 的数量,理想情况下应为 0,如果不是 0,每个失败 Target 都应有明确原因和处理结论。
prometheus_build_info: status = success,存在结果
count(up == 0): status = success,结果为 0 或已确认的异常数量
固化最终上线清单
真正可复用的上线清单应记录“是否通过”和“如何证明通过”,而不只是勾选一句“已检查”。可以把每次上线至少固定为以下六项:Target 无未解释失败;Label 命名与基数符合约定;Dashboard 能从总览下钻到具体实例;告警经过规则校验和一次故障演练;数据保留与磁盘容量匹配;Prometheus 自身存在健康与容量监控。
当这六项都有可以复查的证据时,服务器监控平台才从“能看到数据”进入“出现故障时能够被依赖”的状态。