
可观测性与稳定性 / 系统课时
Linux 内存指标该关注哪些
Linux 内存指标该关注哪些
监控 Linux 内存时,最容易犯的错误是只盯着“空闲内存”判断是否告急。本课用 Node Exporter 的 MemTotal、MemAvailable 和 Swap 指标建立更可靠的判断方式,并给出可直接执行的 PromQL 查询。
学习目标
- 区分总内存、空闲内存与可用内存,避免把缓存占用误判为内存不足。
- 使用 Node Exporter 指标计算内存使用压力和 Swap 使用量。
- 知道什么时候需要结合 Swap 判断持续性的内存压力。
为什么不能只看 MemFree
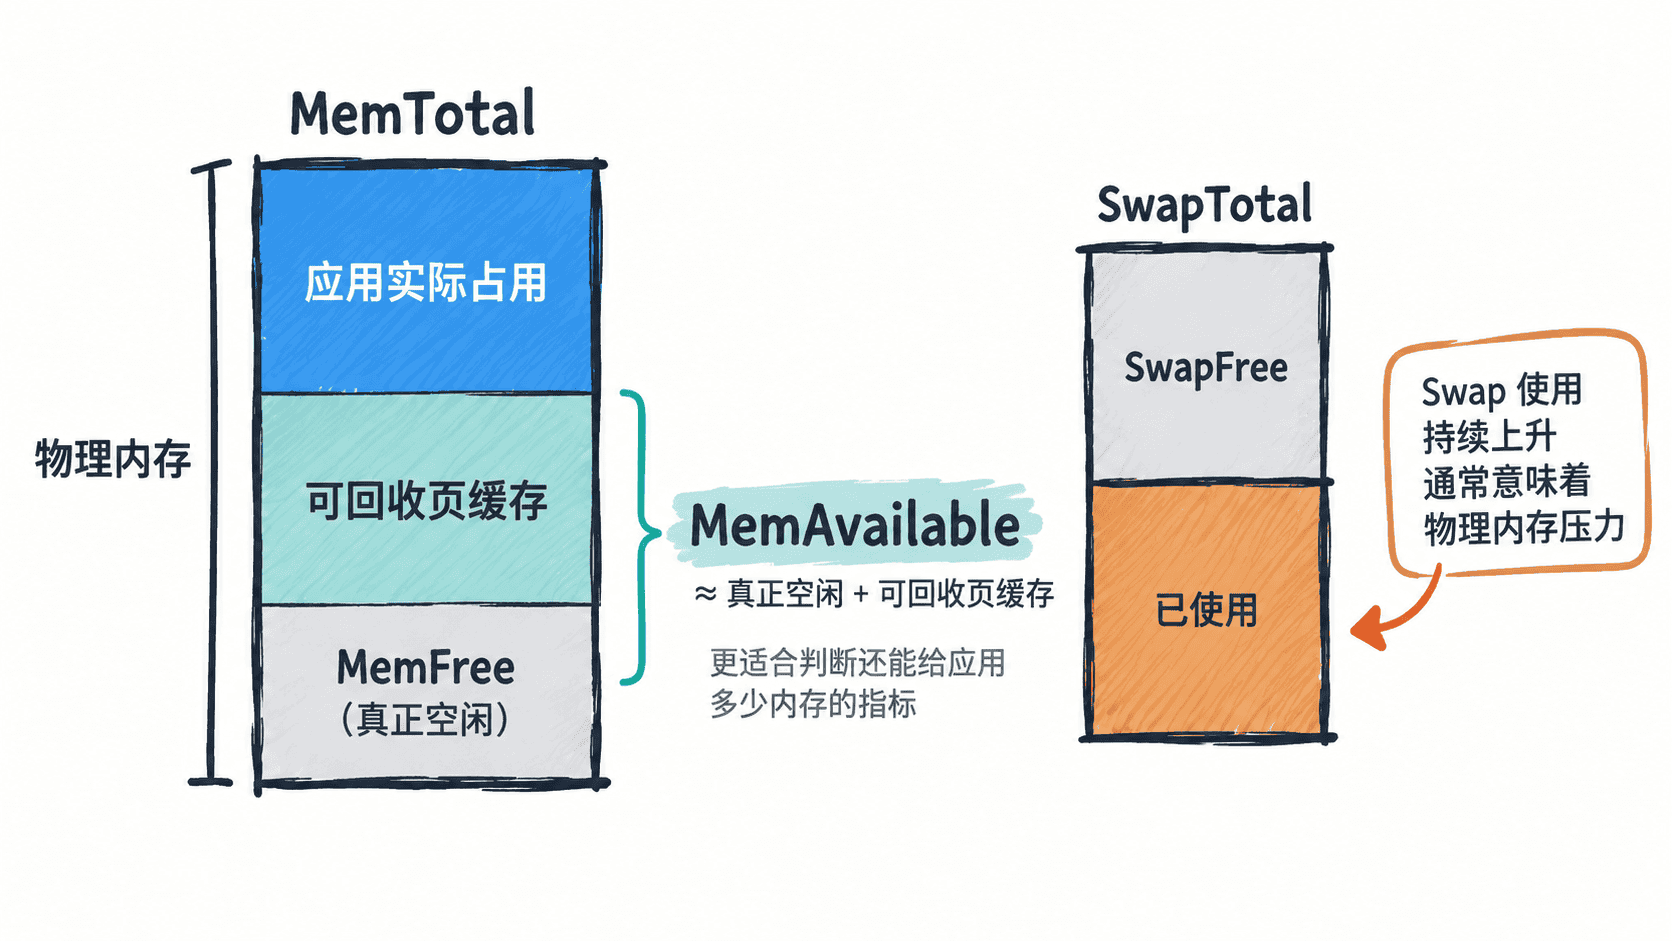
Linux 会主动把暂时不用的内存用于页缓存等用途,因此“没有被任何东西占用”的内存可能很少,但其中一部分缓存可以在应用需要时回收。node_memory_MemFree_bytes 只对应真正空闲的内存,单独看它很容易把正常的缓存利用误判成内存不足。
更适合作为容量判断基础的是 node_memory_MemAvailable_bytes。它表示在不发生 Swap 的前提下,系统估计还能提供给新应用使用的内存。总容量则由 node_memory_MemTotal_bytes 表示。
用 PromQL 计算内存压力
常用的“内存使用率”可以按 MemAvailable 反推:可用比例越低,内存压力越高。下面的查询按每个实例计算物理内存中不可用部分的百分比。示例假设 Prometheus 运行在 localhost:9090,并且本机已经安装 curl 与 jq。
curl -s 'http://localhost:9090/api/v1/query' \
  --get \
  --data-urlencode 'query=100 * (1 - node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes)' \
  | jq -r '.data.result[] | "instance=\(.metric.instance) memory_pressure_percent=\(.value[1])"'
预期输出
instance=<HOST>:<PORT> memory_pressure_percent=<VALUE><HOST>、<PORT> 和 <VALUE> 会随监控目标与采样时刻变化。这个比例适合做容量趋势和告警阈值的基础,但不应只凭一次瞬时尖峰判定故障,应结合持续时间和业务负载观察。
再看 Swap 是否正在被消耗
Node Exporter 中 node_memory_SwapTotal_bytes 是 Swap 总量,node_memory_SwapFree_bytes 是剩余量,两者之差就是已使用 Swap。可以直接查询已使用字节数:
curl -s 'http://localhost:9090/api/v1/query' \
  --get \
  --data-urlencode 'query=node_memory_SwapTotal_bytes - node_memory_SwapFree_bytes' \
  | jq -r '.data.result[] | "instance=\(.metric.instance) swap_used_bytes=\(.value[1])"'
预期输出
instance=<HOST>:<PORT> swap_used_bytes=<VALUE>如果机器没有配置 Swap,总量可能为 0,此时不要直接计算 Swap 百分比。若 MemAvailable 长时间偏低,同时 Swap 使用持续增加,通常比“MemFree 很小”更值得优先排查;还应继续结合进程内存、OOM 日志和业务延迟确认根因。
建立可执行的监控判断
日常看板至少保留 MemTotal、MemAvailable 和 Swap 已使用量三类信息。容量告警优先围绕“可用内存比例持续偏低”设计,而不是围绕 MemFree 单点告警;Swap 则用于补充判断压力是否已经影响到内存回收与换页。这样既能避免把正常缓存当故障,也更容易发现真正持续的内存紧张。