
可观测性与稳定性 / 系统课时
请求量应该怎样计算
请求量应该怎样计算
请求监控通常拿到的是不断累加的请求总数,而不是现成的“每秒请求数”。本篇用 PromQL 把 Counter 转成请求速率,再按服务和接口聚合,让流量曲线真正反映系统当前承受的请求压力。
学习目标
- 理解为什么请求累计值不能直接作为实时请求量
- 使用
rate()计算一段时间内的平均每秒请求数 - 按服务、接口等标签聚合请求速率并控制维度
从累计值转成每秒请求数
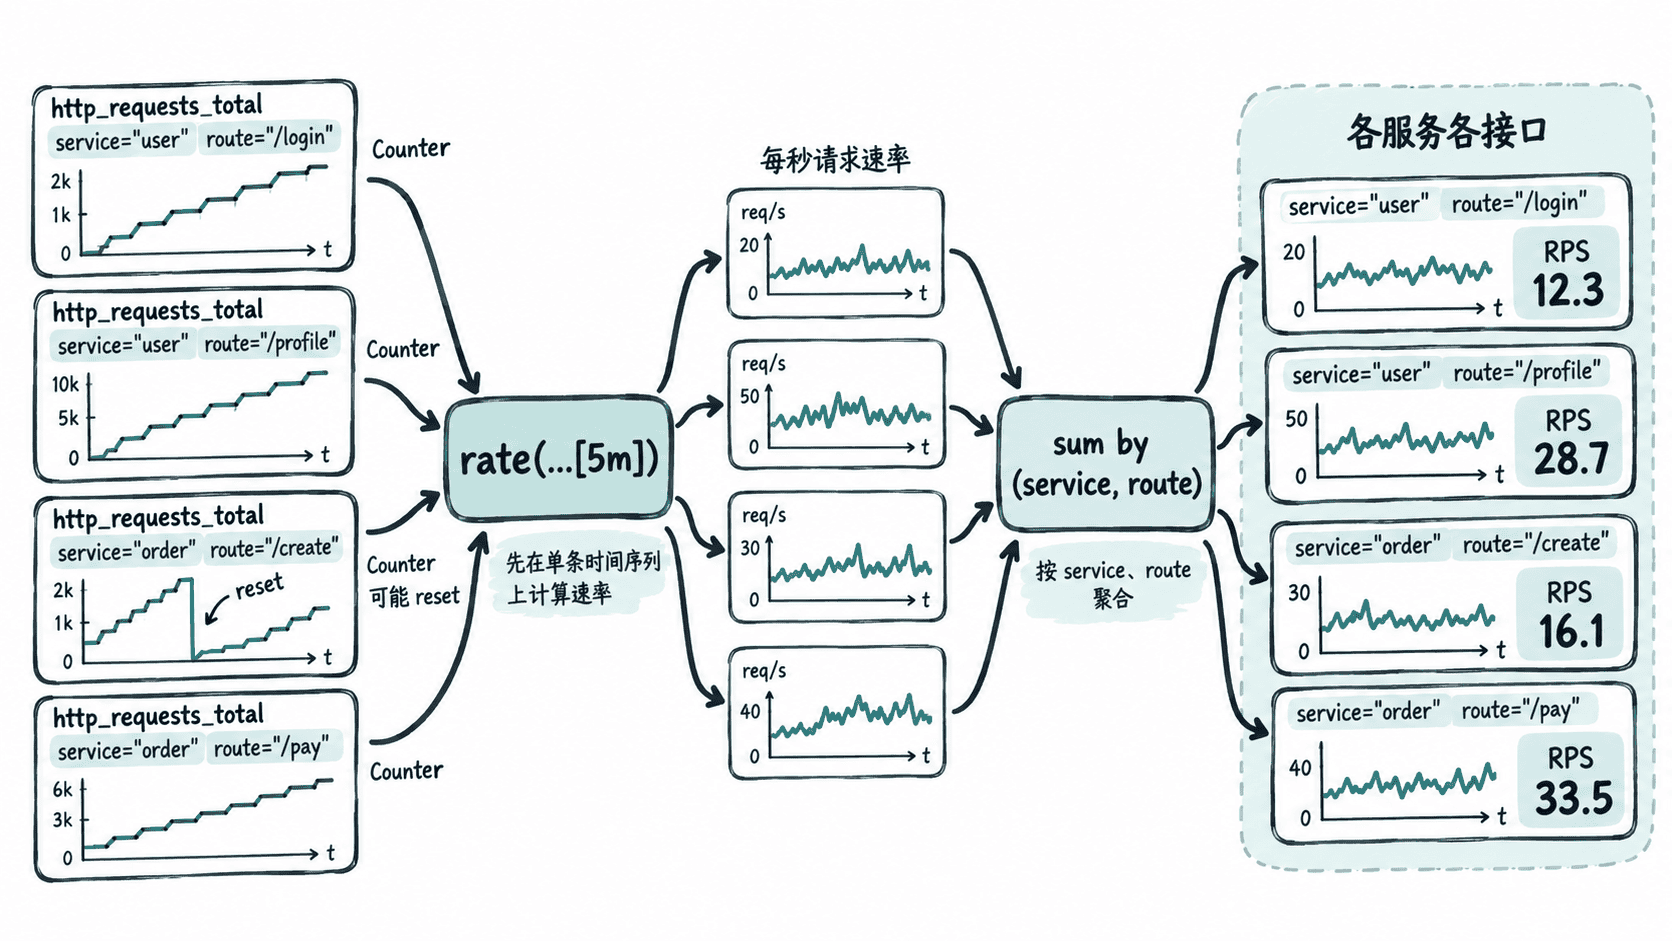
应用通常把请求次数暴露为 Counter,例如 http_requests_total。它在每次请求到来时递增,进程重启时可能从较小值重新开始。因此,直接绘制 Counter 得到的只是持续上升的累计曲线,无法回答“现在每秒有多少请求”。
rate() 会读取指定时间窗口中的 Counter 样本,计算平均每秒增长速度,并处理常见的 Counter 重置。对于 [5m],结果表达的是最近 5 分钟范围内估算出的每秒平均增长量,也就是常说的 RPS。
按服务和接口聚合流量
假设应用暴露的 http_requests_total 至少带有 service 和 route 标签,可以先对每条原始时间序列计算速率,再按需要的维度求和。实际环境中的指标名和标签名应以应用真实暴露的数据为准。
在 Prometheus 表达式浏览器中执行:
sum by (service, route) (
  rate(http_requests_total[5m])
)
预期结果:
{service="checkout", route="/orders"} <RPS>
{service="checkout", route="/payments"} <RPS>
{service="catalog", route="/products"} <RPS>
<RPS> 表示查询时刻计算出的每秒请求数,实际值会随流量变化。若只关心整个服务,可以只保留 service;如果希望观察全站总请求量,则可以去掉 by (...) 分组。
这里应保持“先 rate(),再 sum”的顺序。原始 Counter 可能分别发生重置,先对每条序列计算速率才能在聚合前正确识别这些变化;把多条 Counter 先相加再计算速率,会丢失单条序列的重置信息。
选择合适的时间窗口
时间窗口决定曲线在灵敏度和稳定性之间如何取舍。较短窗口能更快显示突发流量,但样本较少时曲线容易波动;较长窗口更加平滑,却可能把短时间尖峰平均掉。
对于常见的十几秒级抓取周期,[5m] 是适合观察稳定趋势的起点。排查短暂流量尖峰时可以缩短窗口,但应确保窗口中能够包含多个抓取样本,而不是机械地追求越短越好。
标签也需要控制。route="/orders/:id" 这类归一化路由适合聚合,而把真实订单 ID、用户 ID 或完整 URL 放进标签会制造大量时间序列,使查询和存储成本迅速增加。
请求量监控最终关注的不是 Counter 当前累计到了多少,而是它在一段时间内增长得多快。先对原始 Counter 求速率,再按稳定、有限的业务标签聚合,就能得到适合 Grafana 展示、容量观察和后续错误率计算的流量基线。