
可观测性与稳定性 / 系统课时
一张仪表盘应该放多少指标
一张仪表盘应该放多少指标
一张 Dashboard 的价值不在于塞进多少指标,而在于能否让值班人员快速判断“是否异常、异常在哪里、下一步看什么”。本课用分层设计代替图表堆积,把指标数量控制在真正支持判断和定位的范围内。
学习目标
- 根据监控任务决定一张仪表盘应展示的指标数量与粒度
- 按整体状态、资源、服务和异常线索组织信息层级
- 识别重复、低价值和不适合放在首屏的图表
指标数量没有固定答案
“放 10 个还是 30 个指标”不是最重要的问题。真正需要控制的是用户在同一时刻必须处理的信息量。如果一个页面同时出现几十条曲线,即使每条数据都正确,也可能让关键异常淹没在视觉噪声中。
设计时应先明确这张仪表盘要回答什么问题。例如主机总览首先要回答“哪些机器异常”,单机详情则需要回答“异常主要来自 CPU、内存、磁盘还是网络”。不同问题应由不同层级的 Dashboard 承担,而不是全部塞进一个页面。
一个实用原则是:首屏只保留能够改变判断或下一步操作的指标。仅仅因为 Prometheus 已经采集到某个指标,并不意味着它必须拥有一个 Panel。
用四层信息组织页面
监控页面可以从上到下分成四层:整体状态、核心资源、服务表现和异常线索。阅读顺序应从“有没有问题”逐步深入到“问题可能在哪里”。
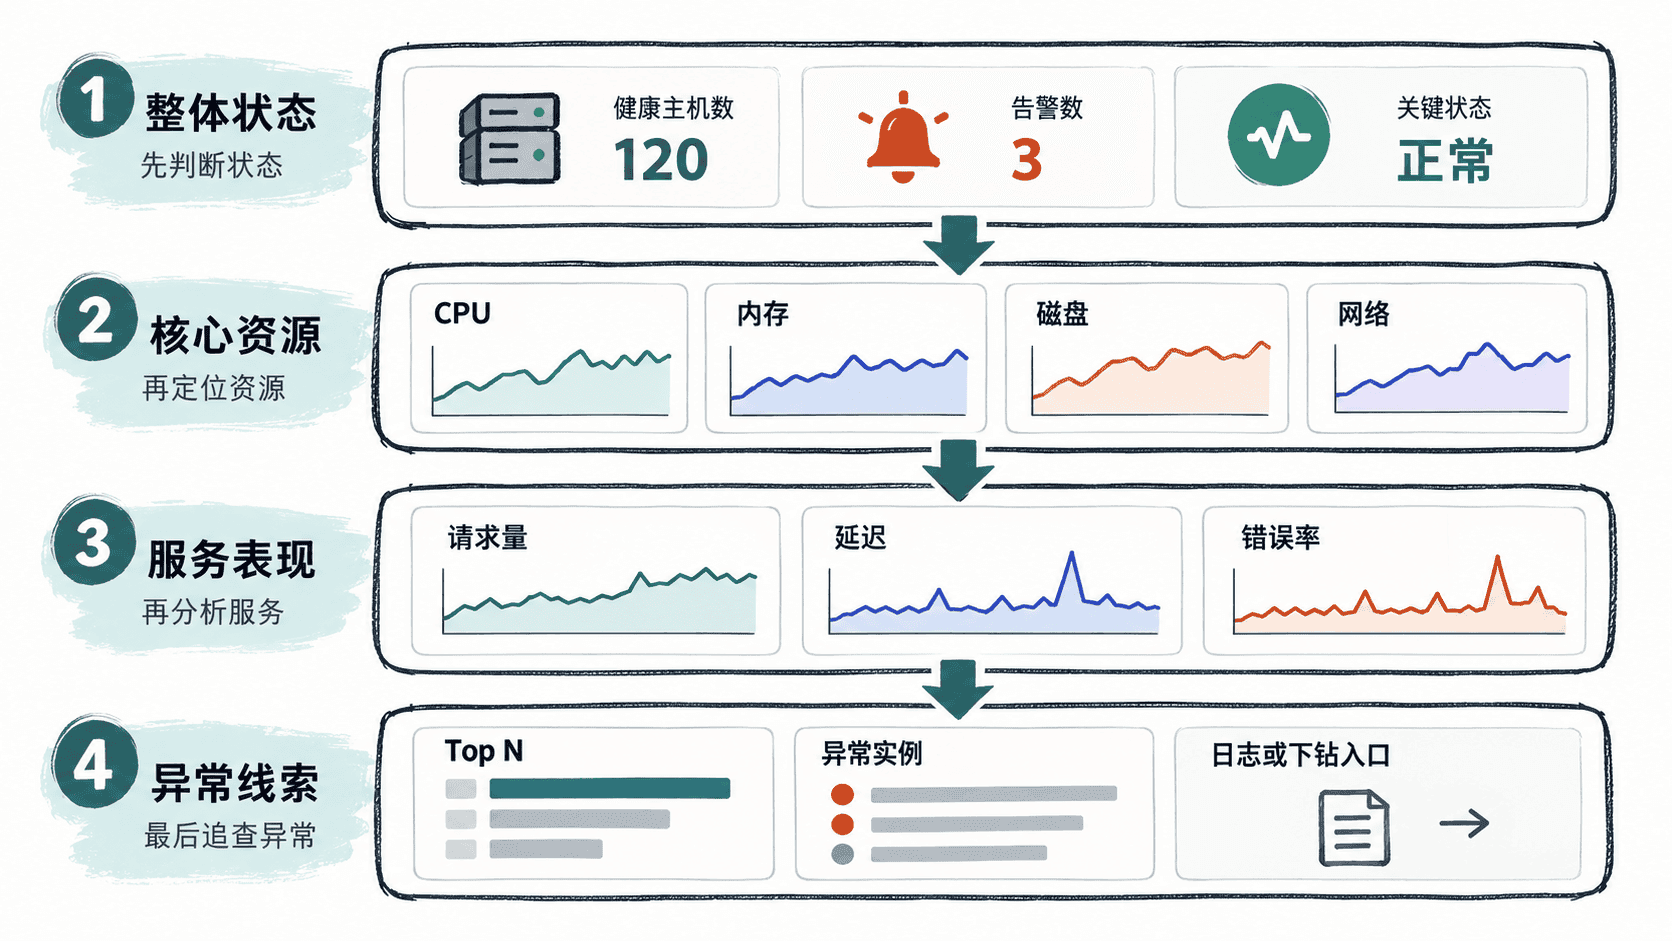
整体状态区域通常只需要少量 Stat、Gauge 或状态时间线,用来暴露告警数、不可用实例数、关键 SLI 是否越界等信息。这里不适合出现十几条详细趋势线。
核心资源区域再展开 CPU、内存、磁盘和网络。每类资源通常保留一到两个最能解释问题的趋势,例如 CPU 使用率配合负载,磁盘同时关注使用率与 I/O 压力,而不是把所有 exporter 指标逐一画出来。
服务与异常区域则用于进一步定位。如果当前 Dashboard 只负责基础主机监控,没有应用指标,就不必为了形式完整强行加入服务层。
删除不能支持判断的图表
判断一个 Panel 是否值得保留,可以连续问三个问题:看到它之后能否判断状态,异常时能否改变排查方向,和附近的图表是否提供了重复信息。如果三个问题都是否定答案,这个 Panel 通常应该删除或移动到下钻页面。
常见的冗余包括同时展示多个表达同一含义的 CPU 百分比、把几十个文件系统固定展开、为几乎不会变化的系统信息持续画趋势,以及在总览中绘制每个 CPU 核心的独立曲线。
控制每个区域的视觉重点
Panel 数量还要和屏幕空间一起考虑。首屏中最重要的状态应该无需滚动即可看到;趋势图数量过多时,与其不断缩小 Panel,不如拆分页面或使用变量进行实例切换。
同一层级中应保持一致的视觉语义。例如红色只用于明确异常,正常状态不要使用大量高饱和色。多条时间序列共享一个 Panel 时,也要限制系列数量;如果图例长到必须滚动,通常说明聚合维度或页面层级需要重新设计。
对值班场景而言,一张好仪表盘并不是“信息最多”的页面,而是能让人沿着固定路径完成判断:先看整体状态,再看核心资源,必要时进入服务或异常详情。指标数量最终由这个判断链路决定,而不是由数据源里有多少指标决定。