
可观测性与稳定性 / 系统课时
网络指标能发现什么问题
网络指标能发现什么问题
服务器“网络慢”不能只看一个带宽数字。Node Exporter 的网卡累计字节、错误和丢弃计数可以把问题拆成流量变化与异常计数两类信号,帮助你判断是业务流量上升、单机网卡异常,还是需要继续检查链路与应用。
学习目标
- 用收发字节计数计算网卡吞吐速率,区分接收与发送方向
- 用错误和丢弃计数识别值得继续排查的网络异常
- 通过窗口、网卡标签和多指标组合避免把正常流量误判为故障
从累计计数读成速率
node_network_receive_bytes_total 和 node_network_transmit_bytes_total 是持续累加的 Counter。原始值表示自网卡统计开始以来累计收发了多少字节,真正适合画趋势的是一段时间内的增长速率。
| 指标 | 含义 | 常见观察方式 |
|---|---|---|
node_network_receive_bytes_total |
网卡累计接收字节 | rate() 得到每秒接收字节 |
node_network_transmit_bytes_total |
网卡累计发送字节 | rate() 得到每秒发送字节 |
node_network_receive_errs_total |
接收错误累计数 | 观察是否持续增长 |
node_network_transmit_errs_total |
发送错误累计数 | 观察是否持续增长 |
node_network_receive_drop_total / node_network_transmit_drop_total |
接收或发送丢弃累计数 | 结合流量和主机范围判断 |
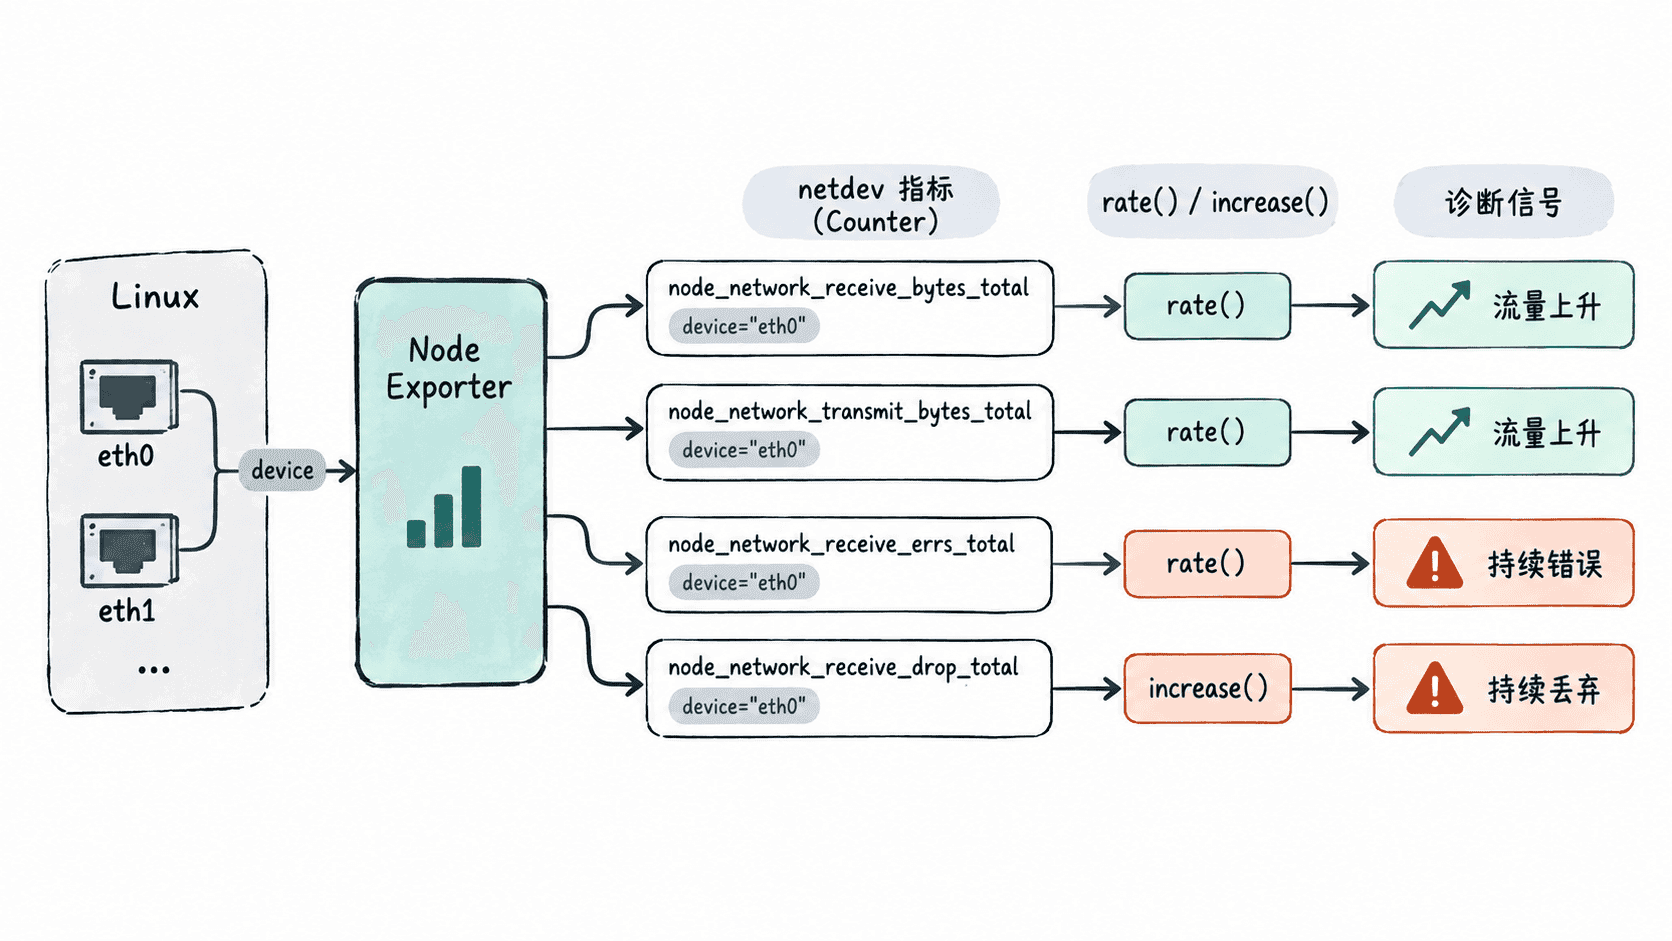
下面的 PromQL 计算每台主机、每块非回环网卡过去 5 分钟的平均接收速率,单位是字节/秒:
sum by (instance, device) (
  rate(node_network_receive_bytes_total{device!="lo"}[5m])
)
预期结果
每个 instance + device 返回一条瞬时序列,样本值表示该网卡过去 5 分钟平均每秒接收的字节数;实际数值随流量变化。发送方向只需对 node_network_transmit_bytes_total 使用同样的窗口。若要换算为 bit/s,可将结果乘以 8;是否接近瓶颈仍要与该网卡的已知链路速率比较,不能仅凭“数值很大”判断拥塞。
错误和丢弃比高流量更值得警惕
高吞吐可能只是业务繁忙,而错误计数持续增长通常更值得继续调查。下面把接收和发送错误转换为每秒错误事件数:
sum by (instance, device) (
  rate(node_network_receive_errs_total{device!="lo"}[5m])
  +
  rate(node_network_transmit_errs_total{device!="lo"}[5m])
)
预期结果
正常网卡通常长期接近 0;若某个 instance + device 持续出现大于 0 的值,说明错误计数正在增长,应继续检查网卡、驱动、链路或宿主机网络状态。drop_total 的增长表示数据包被丢弃,但它并不直接告诉你丢包发生的根因。接收丢弃可能与队列、缓冲区或驱动处理能力有关,发送丢弃也可能与发送队列或系统网络栈有关,因此要把它当作“需要继续定位”的证据,而不是最终结论。
用多指标组合判断问题范围
观察网络问题时,先看方向,再看异常,再看影响范围。收发速率同步上升且错误、丢弃保持接近 0,通常更像正常流量增长;吞吐没有明显变化但错误或丢弃突然增加,则更像链路或主机侧异常。
如果只有一台服务器的一块网卡异常,而同组其他实例正常,优先检查该主机;如果许多实例在同一时间出现流量突变或错误增长,则应把视线扩大到上游交换网络、负载均衡、依赖服务或统一发布变更。
选择合适的观察窗口
短窗口更敏感,长窗口更稳定。1 分钟窗口适合发现突发,但低流量主机上更容易抖动;5 分钟通常适合通用仪表盘;稀疏错误可用 10~15 分钟的 increase() 判断“这段时间是否真的发生过”。
最终要把网络指标当作一组证据:字节速率回答“流量有多大”,错误和丢弃回答“链路是否出现异常迹象”,instance 与 device 标签回答“问题集中在哪里”。三者一起看,才比单独盯一条带宽曲线更有诊断价值。