
可观测性与稳定性 / 系统课时
搭建服务器总览 Dashboard
搭建服务器总览 Dashboard
这一节把 Prometheus 已采集的 Node Exporter 指标整理成一个可值班使用的服务器总览页:先按主机筛选,再用状态、CPU、内存、磁盘和网络面板回答“哪台机器异常、异常发生在哪一类资源”两个问题。
学习目标
- 用
instance变量在同一 Dashboard 中切换不同服务器。 - 为在线状态、CPU、内存、磁盘和网络选择合适的 PromQL 与面板类型。
- 通过统一单位、阈值和刷新周期检查总览页是否适合日常监控。
先确定总览页的阅读顺序
总览页不是把所有指标都堆在一起,而是让人从“是否在线”逐步下钻到“哪类资源有压力”。推荐第一行放在线状态、CPU、内存和根分区使用率,第二行放网络收发趋势;这样进入页面后,先看到结论,再看变化过程。
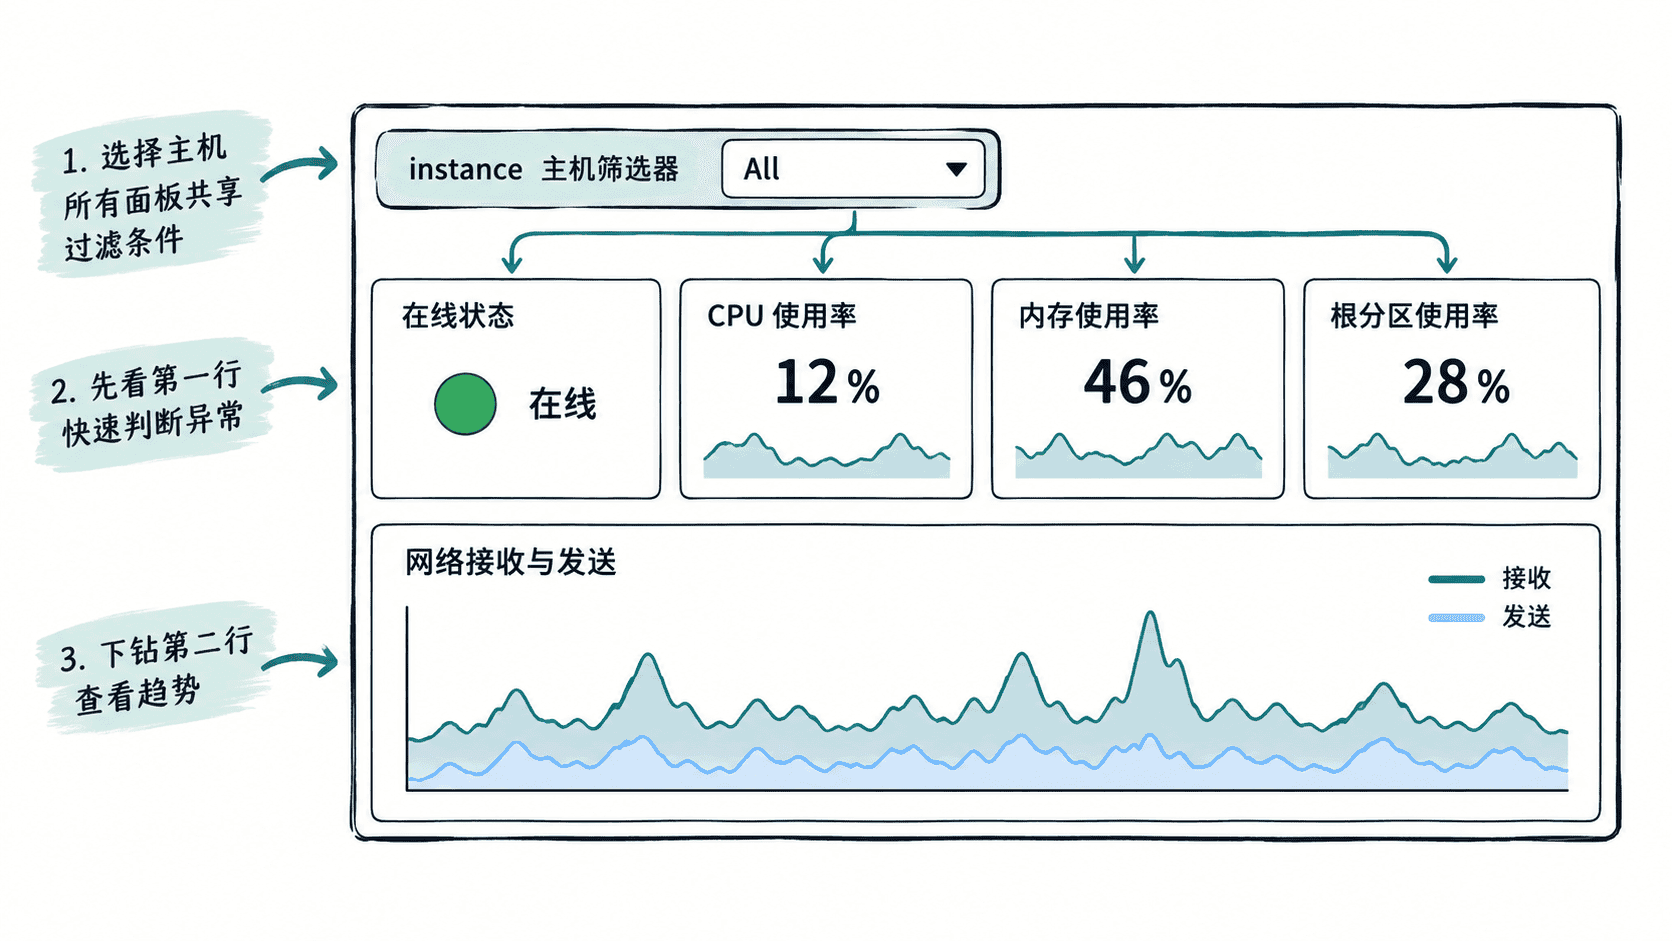
建立主机筛选变量
在 Dashboard 编辑状态下新增一个 Query 变量,名称设为 instance,数据源选择 Prometheus,查询类型选择 Label values,标签选择 instance,并把指标范围限定到 up{job="node"}。如果你的 Prometheus 抓取任务不是 node,把这里以及后续查询中的 job="node" 改成实际标签值。
面板查询引用变量时使用 ${instance}。例如在线状态面板可以查询 up{job="node",instance="${instance}"},值为 1 表示 Prometheus 最近一次抓取成功,值为 0 表示目标当前不可达。这个面板适合使用 Stat,并把 1 映射为“在线”、0 映射为“离线”。
添加核心资源面板
CPU 面板应显示“非 idle 时间占比”,而不是直接读取某个累计计数器。下面的查询按主机计算最近 5 分钟平均 CPU 使用率,可直接放入 Prometheus 查询编辑器执行。
100 * (
  1 - avg by (instance) (
    rate(node_cpu_seconds_total{
      job="node",
      instance="${instance}",
      mode="idle"
    }[5m])
  )
)
预期结果
{instance="<HOST>:<PORT>"} <VALUE><VALUE> 是当前 CPU 使用率百分比,实际数值会随负载变化。Grafana 中把 Unit 设为 Percent (0-100),总览页可使用 Gauge 或 Time series;如果只想快速看当前值,Stat 更紧凑。
其余面板可沿用同一筛选条件。内存使用率查询为 100 * (1 - node_memory_MemAvailable_bytes{job="node",instance="${instance}"} / node_memory_MemTotal_bytes{job="node",instance="${instance}"});根分区使用率为 100 * (1 - node_filesystem_avail_bytes{job="node",instance="${instance}",mountpoint="/"} / node_filesystem_size_bytes{job="node",instance="${instance}",mountpoint="/"})。
网络面板适合同时画接收和发送两条时序线,分别使用 rate(node_network_receive_bytes_total{job="node",instance="${instance}",device!="lo"}[5m]) 与 rate(node_network_transmit_bytes_total{job="node",instance="${instance}",device!="lo"}[5m]),单位设为 bytes/sec。多网卡服务器会返回多条序列,应在图例中保留 device,避免把不同接口误认为同一条曲线。
统一显示与阈值
同类指标要使用一致单位,否则总览页很难横向比较。CPU、内存、磁盘统一使用百分比;网络统一使用字节每秒;在线状态使用离散状态映射。阈值颜色可以作为视觉提示,但不要把固定阈值当成所有服务器的通用容量标准。
时间范围可先设为最近 1 小时,自动刷新使用适合采集间隔的值,例如采集每 15 秒一次时可从 30 秒或 1 分钟刷新起步。刷新过快只会增加查询压力,不会让原本每 15 秒采集一次的数据凭空更细。
验收 Dashboard
切换 instance 后,所有面板都应同时切换到同一台服务器;停止某台测试机上的 Node Exporter 后,在线状态应在下一次抓取后变为离线,而其他资源面板会逐渐停止产生新数据。重新启动 Exporter 后,状态恢复为在线并继续出现新样本。
最后检查两个细节:根分区面板是否确实筛选了 mountpoint="/",网络图例是否能区分不同 device。这两个条件满足后,这个总览页就已经具备用于值班巡检和后续告警联动的基础结构。