
可观测性与稳定性 / 系统课时
历史数据应该保留多久
历史数据应该保留多久
保留周期不是“越长越好”。本节用查询需求、采样速率和磁盘预算三项约束,确定 Prometheus 本地应保留多久,并判断哪些历史数据应该转交长期存储,而不是把单机 TSDB 无限扩容。
学习目标
- 根据排障、趋势分析和审计需求确定本地保留窗口
- 用采样速率与磁盘容量估算可承受的保留周期
- 配置时间与容量双重限制,并识别需要长期存储的场景
先从实际查询窗口反推
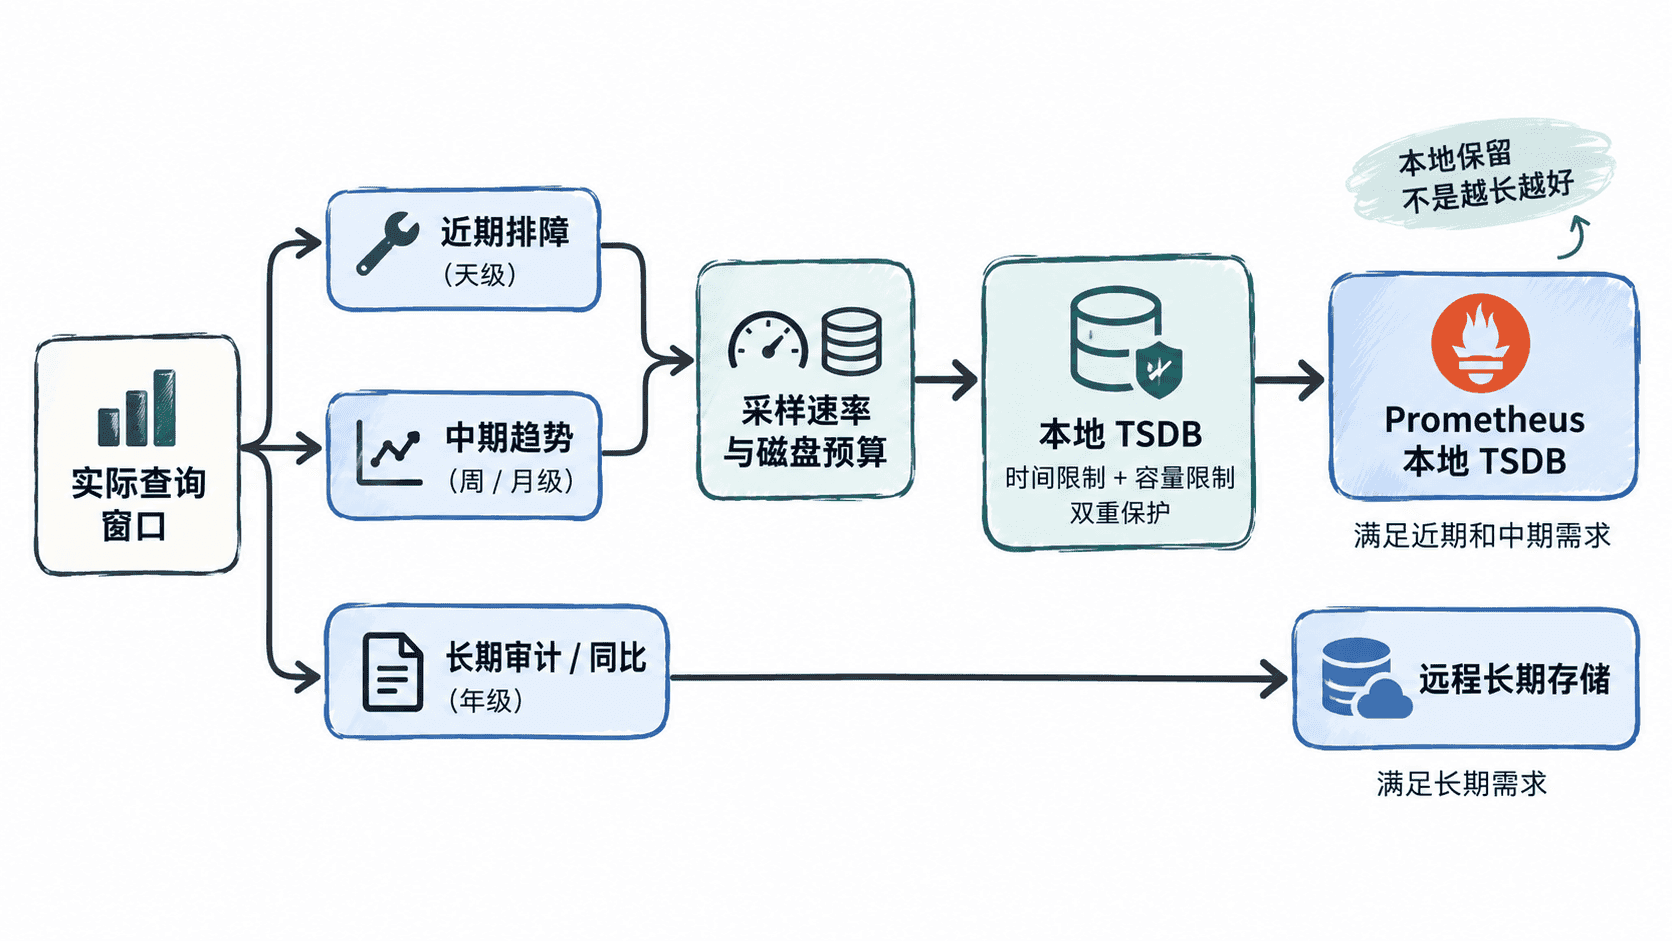
先统计真正会查询的时间跨度,而不是先拍一个“90 天”或“1 年”。故障排查往往只需要最近几天,容量趋势可能需要数周到数月,而同比分析、合规留档才会跨季度或跨年度。
可以把需求分成三层:最近数据要求查询快且随时可用;中期数据用于趋势和复盘;长期数据更看重成本、耐久性与跨实例保存。若一年以前的数据只偶尔用于报表,就没有必要让 Prometheus 本机磁盘长期承担全部历史。
用磁盘预算给周期设上限
Prometheus 官方给出的粗略容量估算是:本地样本平均约占 1~2 字节,因此可以先用“保留秒数 × 每秒写入样本数 × 每样本字节数”估算数据量,再为 WAL、Head 数据、索引和压缩期间的临时空间留余量。官方同时建议,当使用容量保留限制时,最多只占分配磁盘的大约 80%~85%,避免压缩时新旧块短暂共存把磁盘顶满。([普罗米修斯][1])
例如每秒写入 50,000 个样本,按 1.5 字节/样本粗估,保留 30 天仅样本数据就约 194 GB;这还不是最终磁盘需求。实际规划应继续观察真实 TSDB 增长速度,再调整保留周期,而不是只依赖理论值。
同时设置时间与容量两道边界
当前 Prometheus 配置支持在 storage.tsdb.retention 下设置保留时间和容量;如果两者同时存在,先达到的条件会淘汰最老数据。若都没有配置,时间保留默认是 15 天。最新命令行文档已把对应的 --storage.tsdb.retention.time 与 --storage.tsdb.retention.size 标记为弃用,配置文件字段优先。([Prometheus][2])
片段示例:把下面的 storage 段合并进现有 prometheus.yml,保留原有的抓取与规则配置。
storage:
  tsdb:
    retention:
      time: 30d
      size: 80GB
这表示最多保留 30 天,同时把持久化块的容量限制在 80 GB;任何一项先触发都会开始清理最老块。上线前应先做配置语法校验,应用后持续观察磁盘占用、最早可查询时间以及压缩是否正常,确认容量限制没有比业务需要更早截断历史。
什么时候应该使用长期存储
Prometheus 本地 TSDB 是单节点存储,本身不提供集群复制;官方也提供 remote read/write 接口与外部存储集成。([普罗米修斯][1]) 当你需要跨月或跨年的长期保存、跨 Prometheus 实例统一查询,或者不能接受单机磁盘故障造成历史丢失时,应把长期数据交给专门的远程存储体系。
常见做法是让本地 Prometheus 只保留满足快速排障和近期看板的窗口,例如 15~45 天,再把更长周期交给长期后端。这样本地磁盘负责“快”,远程系统负责“久”,保留策略也就从一个孤立数字变成可验证的容量设计。