
可观测性与稳定性 / 系统课时
Prometheus 自己也需要监控吗
Prometheus 自己也需要监控吗
需要。Prometheus 既是监控系统,也是一个会抓取失败、规则执行失败、时间序列膨胀和磁盘耗尽的服务。本节建立一组最小自监控信号,并补上“Prometheus 整体宕机时无法给自己报警”的盲区。
学习目标
- 识别抓取、规则、时间序列和磁盘四类核心自监控信号
- 使用 Prometheus 自身指标编写最小告警规则
- 理解单实例自监控的失效边界,并设计外部存活检测
先理解自监控的边界
Prometheus 会在自己的 /metrics 端点暴露运行指标,默认示例配置也会让 Prometheus 抓取自身,因此“用 Prometheus 看 Prometheus”是正常做法。([普罗米修斯][3]) 但单实例存在一个天然盲区:如果进程退出、主机断电或磁盘彻底写满到无法继续工作,这个实例也可能失去执行规则和发送告警的能力。
因此应把监控分成两层:实例内部指标负责发现性能和功能退化;另一个独立的 Prometheus、外部探针或平台级存活检查负责确认这个 Prometheus 本身是否仍可访问。
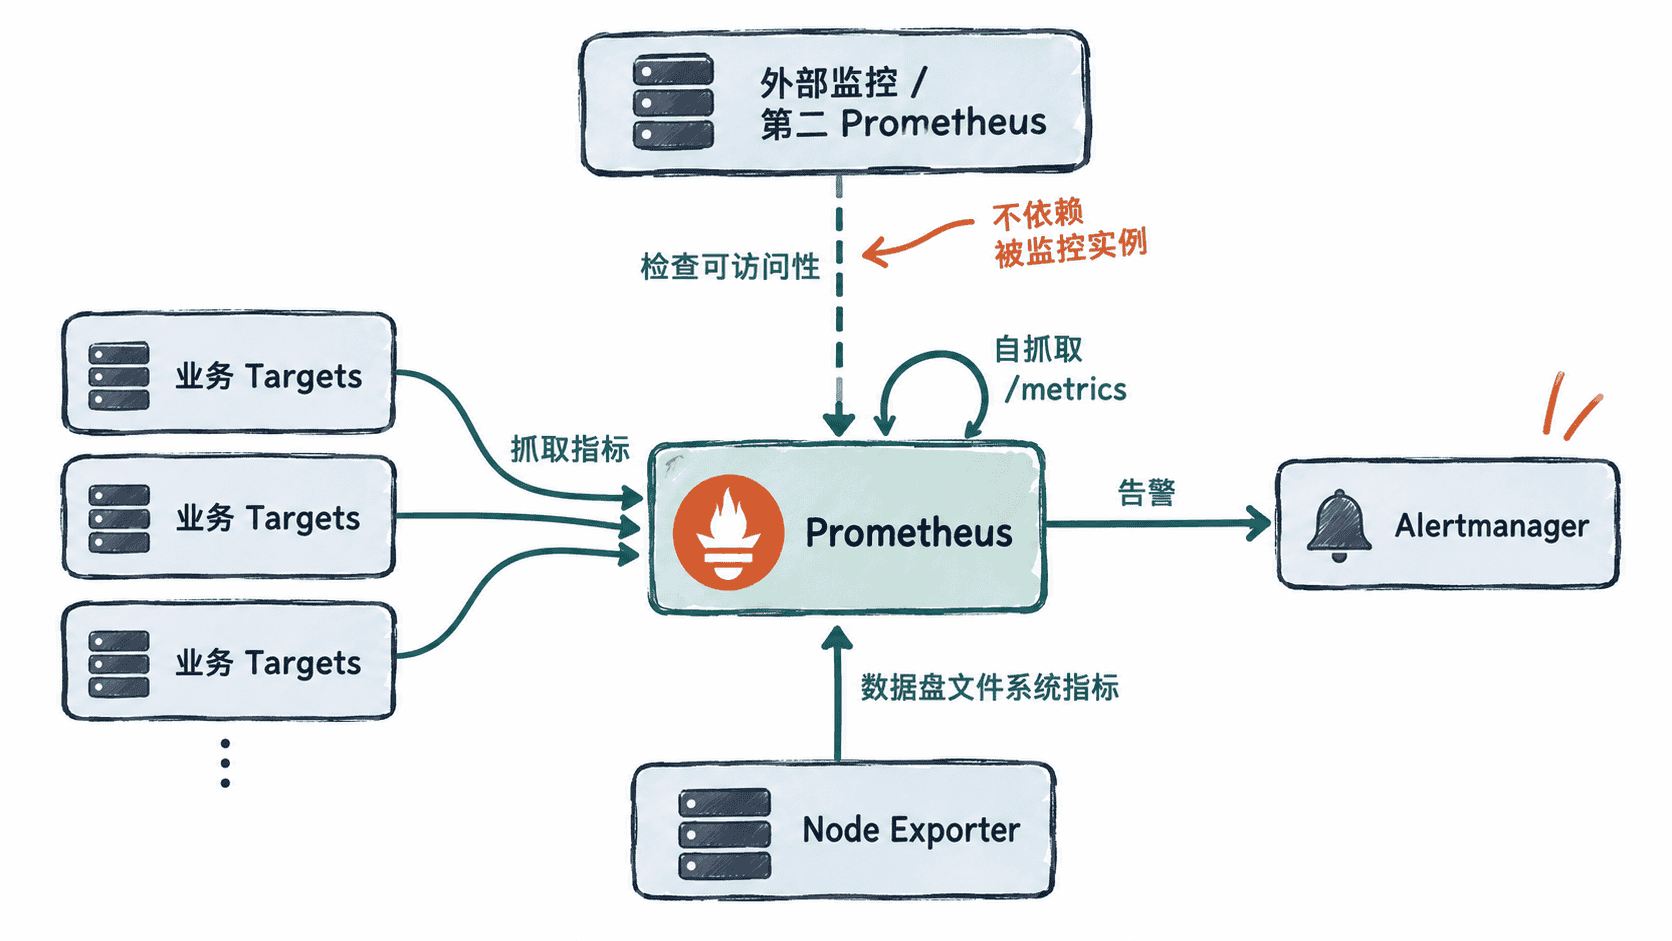
四类信号先覆盖最常见故障
| 关注点 | 推荐指标或表达式 | 主要含义 |
|---|---|---|
| 抓取失败 | up == 0、prometheus_target_scrapes_exceeded_sample_limit_total |
目标不可抓取,或抓取因样本上限被拒绝 |
| 规则执行 | prometheus_rule_evaluation_failures_total、prometheus_rule_group_iterations_missed_total |
规则报错,或规则组执行太慢而错过周期 |
| 时间序列规模 | prometheus_tsdb_head_series |
Head 中当前活跃序列数量,适合观察基线和突增 |
| 磁盘空间 | node_filesystem_avail_bytes / node_filesystem_size_bytes |
Prometheus 数据盘剩余比例 |
这些指标名称可在 Prometheus 当前代码和官方维护的 Prometheus mixin 告警规则中找到,其中 prometheus_tsdb_head_series 直接表示 Head 中的序列数,规则失败与错过执行周期也有对应的自监控指标。([GitHub][4])
时间序列数量不适合直接套一个通用阈值。更稳妥的做法是先观察正常业务周期的基线,再对持续增长、突增比例或逼近已知容量上限进行告警;否则同一个“100 万序列”在不同机器和标签模型下可能完全不是同一种风险。
配一组最小告警规则
下面是规则文件片段示例,需要保存到现有规则文件,并由 prometheus.yml 的 rule_files 引入。<PATH> 要替换为 Prometheus TSDB 所在文件系统的实际挂载点。
groups:
  - name: prometheus-self
    rules:
      - alert: PrometheusTargetDown
        expr: sum(up == 0) > 0
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "Prometheus 存在持续抓取失败的目标"

      - alert: PrometheusRuleEvaluationFailures
        expr: increase(prometheus_rule_evaluation_failures_total[5m]) > 0
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "Prometheus 规则执行出现失败"

      - alert: PrometheusDataDiskLow
        expr: node_filesystem_avail_bytes{mountpoint="<PATH>"} / node_filesystem_size_bytes{mountpoint="<PATH>"} < 0.15
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "Prometheus 数据盘可用空间低于 15%"
生效后,健康状态下这三条规则都应保持不触发。验证时可以临时停止一个非关键测试目标,确认 PrometheusTargetDown 在持续 5 分钟后进入 firing,再恢复目标并观察告警消退;规则文件本身应先通过 Prometheus 的规则校验,再加载到实例中。
磁盘告警依赖 Node Exporter 或等价的主机文件系统指标。如果 Prometheus 运行在容器或 Kubernetes 中,必须让 mountpoint 对应实际承载 TSDB 的卷,而不是误看容器根文件系统。
把“Prometheus 挂了”交给外部系统
实例内部告警能发现很多退化,但不能证明“这个 Prometheus 一定活着”。生产环境至少再准备一种独立存活检查,例如另一套 Prometheus 抓取它、黑盒探针检查 HTTP 健康端点,或由平台监控检测进程、Pod 与节点状态。
这样,内部指标回答“Prometheus 工作得好不好”,外部检查回答“Prometheus 还在不在”。两层同时存在,才不会在最需要监控时因为监控系统自身失效而失去告警。