
可观测性与稳定性 / 系统课时
服务 Down 告警怎样配置
服务 Down 告警怎样配置
Prometheus 每次抓取监控目标时都会生成 up 指标,因此判断一个已配置目标是否持续不可访问,并不需要自行探测 HTTP 状态。关键是理解 up == 0 的含义,再通过 for 排除短暂网络抖动,形成可操作的服务 Down 告警。
学习目标
- 根据
up指标准确判断 Prometheus 抓取目标是否失败 - 配置带持续时间、标签和注释的 Target Down 告警规则
- 区分短暂抓取失败、持续不可访问和目标完全未被发现等情况
up 指标直接反映抓取结果
对于 Prometheus 已经发现并尝试抓取的目标,up 通常只有两个值:1 表示最近一次抓取成功,0 表示最近一次抓取失败。因此最基本的异常查询就是:
up == 0预期结果
{instance="server-a:9100",job="node"} 0如果查询没有返回任何序列,表示当前没有满足 up == 0 的时间序列;它并不自动证明“所有应该存在的服务都正常”,因为未被服务发现机制发现的目标本身可能没有对应的 up 序列。
用 for 避免一次失败立即报警
一次抓取失败可能来自瞬时丢包、目标进程重启或部署切换。通常不应该因为一个抓取周期失败就立刻通知值班人员,可以要求异常持续一段时间后再进入 firing 状态。
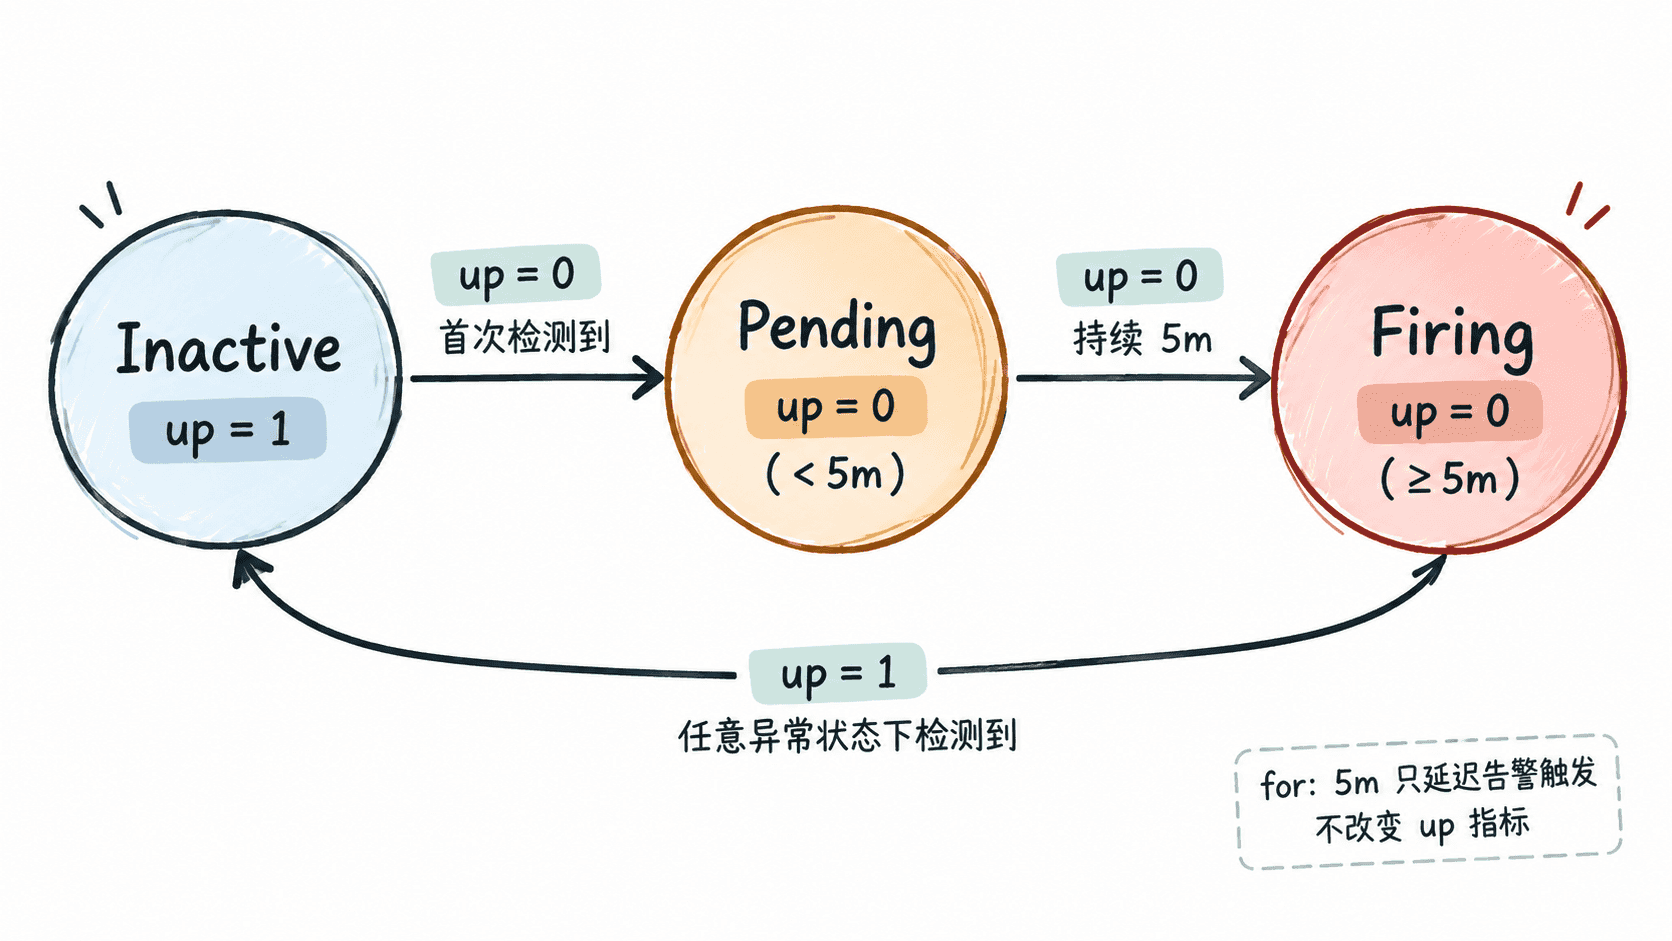
例如 for: 5m 表示表达式连续满足 5 分钟才正式触发告警。如果期间 up 恢复为 1,Pending 状态会被取消,而不是继续累计之前的异常时间。
编写 Target Down 告警规则
下面是一条可以直接放入 Prometheus 规则文件的最小规则。它检测所有已抓取目标,如果持续 5 分钟 up == 0,就产生 critical 告警。
groups:
  - name: availability-alerts
    rules:
      - alert: TargetDown
        expr: up == 0
        for: 5m
        labels:
          severity: critical
        annotations:
          summary: "Prometheus target is down"
          description: "Target {{ $labels.instance }} in job {{ $labels.job }} has been unreachable for 5 minutes."
instance 与 job 是 Prometheus 目标上常见的标签,将它们写入告警描述,可以让接收者立即知道是哪一个抓取目标失败。告警系统实际还可以继续携带环境、集群或团队标签,但这些标签应来自你的监控模型,而不是在规则中随意编造。
保存为 availability-alerts.yml 后,可以先检查规则文件:
promtool check rules availability-alerts.yml预期输出
Checking availability-alerts.yml
  SUCCESS: 1 rules found
不同 Prometheus 版本的输出排版可能略有不同;校验成功时应出现 SUCCESS,并以成功状态退出。
确认规则真的进入 Pending 和 Firing
规则加载后,可以在测试环境临时停止某个 exporter 或让 Prometheus 无法访问其抓取端口,然后查询目标对应的 up。只要 Prometheus 仍在尝试抓取这个目标,就应该看到数值变为 0。
up{job="node",instance="server-a:9100"}预期结果
up{job="node",instance="server-a:9100"} 0实际 job、instance 和端口会随环境变化。异常持续时间不足 5 分钟时,告警应处于 Pending;超过 5 分钟仍未恢复时才进入 Firing。恢复目标后,下一次成功抓取会让 up 返回 1,告警随后退出异常状态。
up 等于零覆盖不了所有失联场景
up == 0 检测的是“Prometheus 已知这个目标,并且抓取失败”。如果目标因为服务发现配置错误而根本没有被发现,就可能连 up 时间序列都不存在;如果 Prometheus 自己停止运行,它也无法继续评估这条规则。因此 Target Down 规则解决的是抓取目标可用性问题,而不是整个监控系统的全部可用性问题。
实际配置时,应根据抓取间隔、网络稳定性和业务恢复目标决定 for。up == 0 提供故障信号,for 控制持续时间,清晰的标签与注释负责把信号变成值班人员可以立即处理的告警。