
可观测性与稳定性 / 系统课时
区间向量和瞬时向量是什么
区间向量和瞬时向量是什么
PromQL 不只是“查一个数”。同一个时间序列既可以在某个评估时刻取一个样本,也可以向前取一段时间内的多个样本。理解瞬时向量与区间向量,是正确使用 rate()、avg_over_time() 等时间窗口函数的基础。
学习目标
- 区分瞬时向量与区间向量包含的数据形态
- 理解
[5m]这类范围选择器实际选择了什么 - 判断常见时间函数为什么需要区间向量作为输入
瞬时向量表示当前观察值
瞬时向量是一组时间序列,每条序列在某个评估时刻只提供一个样本。执行下面的表达式时,Prometheus 会针对每个匹配的序列寻找当前评估时刻可用的最新样本:
up{job="node"}预期结果
up{instance="web-01:9100",job="node"} 1
up{instance="web-02:9100",job="node"} 1这里的“瞬时”不是说指标只保存一个历史值,而是说本次表达式求值时,每条序列只进入计算一个样本值。Grafana 绘制时间曲线时,会在多个评估时刻重复执行这类表达式,于是最终形成连续曲线。
区间向量携带一段历史样本
在时间序列选择器后增加范围选择器,例如 [5m],就会得到区间向量。它不是每条序列只有一个值,而是包含评估时刻向前一段时间内的多个样本:
node_cpu_seconds_total{instance="web-01:9100",mode="idle"}[5m]预期结果
每条匹配的 node_cpu_seconds_total 时间序列包含最近 5 分钟内的多个样本。
样本时间戳与具体数值取决于抓取间隔和实际采集结果。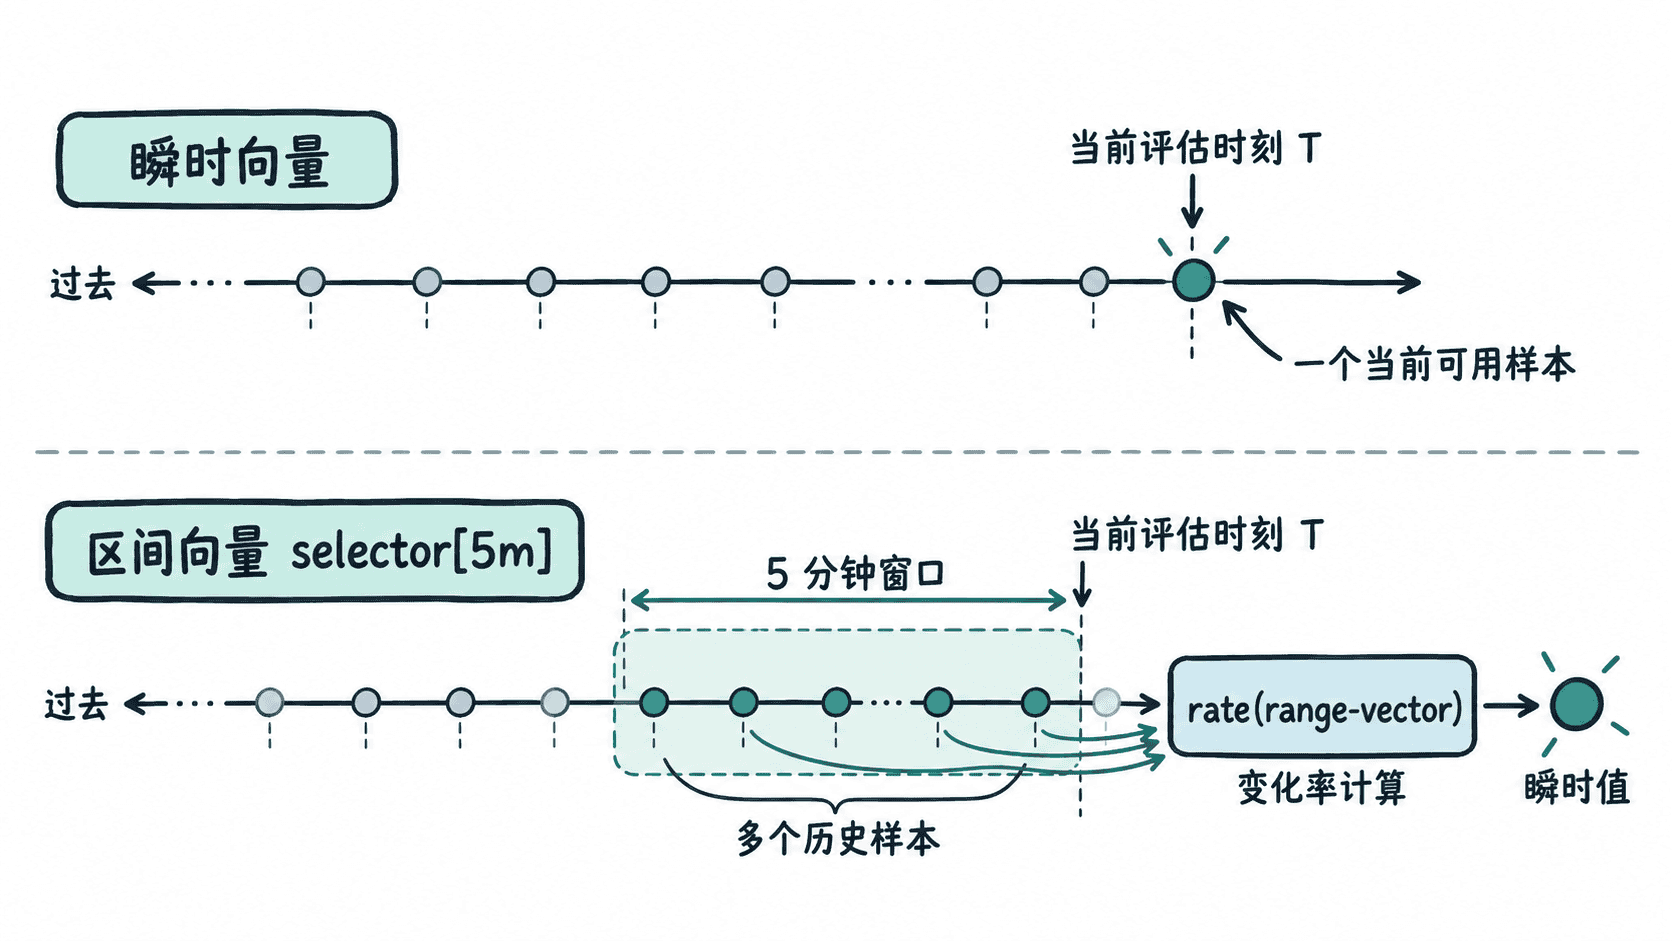
[5m] 描述的是相对于当前评估时刻的回看窗口。假设评估时刻不断向前移动,这个五分钟窗口也会随之向前移动,而不是固定指向某一段绝对时间。
时间函数为什么需要一个窗口
很多监控问题无法从单个样本判断。例如计数器当前值是 12000,并不能告诉你最近一分钟增长得快不快。rate() 必须看到一段时间内的多个样本,才能估算每秒平均增长速率。
rate(node_cpu_seconds_total{instance="web-01:9100",mode="idle"}[5m])预期结果
{cpu="0",instance="web-01:9100",job="node",mode="idle"} <VALUE>
{cpu="1",instance="web-01:9100",job="node",mode="idle"} <VALUE>
...这个表达式的数据类型发生了两次变化:node_cpu_seconds_total{...} 先选中时间序列,[5m] 为每条序列取出一段历史样本形成区间向量,rate() 再把每条序列的这一组样本计算成当前评估时刻的一个速率,因此结果重新成为瞬时向量。
不同函数需要不同输入形态
判断函数能否使用时,先看它需要的是“当前值”还是“一段历史”。例如 sum() 可以直接聚合瞬时向量,而 rate()、increase()、avg_over_time() 需要观察一段时间,因此通常接收区间向量。
avg_over_time(node_memory_MemAvailable_bytes{instance="web-01:9100"}[10m])预期结果
{instance="web-01:9100",job="node"} <VALUE>这里 [10m] 提供最近十分钟的多个内存可用量样本,avg_over_time() 将它们压缩成一个平均值。实际 <VALUE> 由服务器当时的内存状态和抓取样本决定。
写 PromQL 时可以用一个简单判断:如果问题是“现在是多少”,通常从瞬时向量开始;如果问题包含“最近几分钟增长多少、平均多少、变化多快”,就需要先构造区间向量,再交给相应的时间函数计算。