
可观测性与稳定性 / 系统课时
为什么不能只靠人工巡检
为什么不能只靠人工巡检
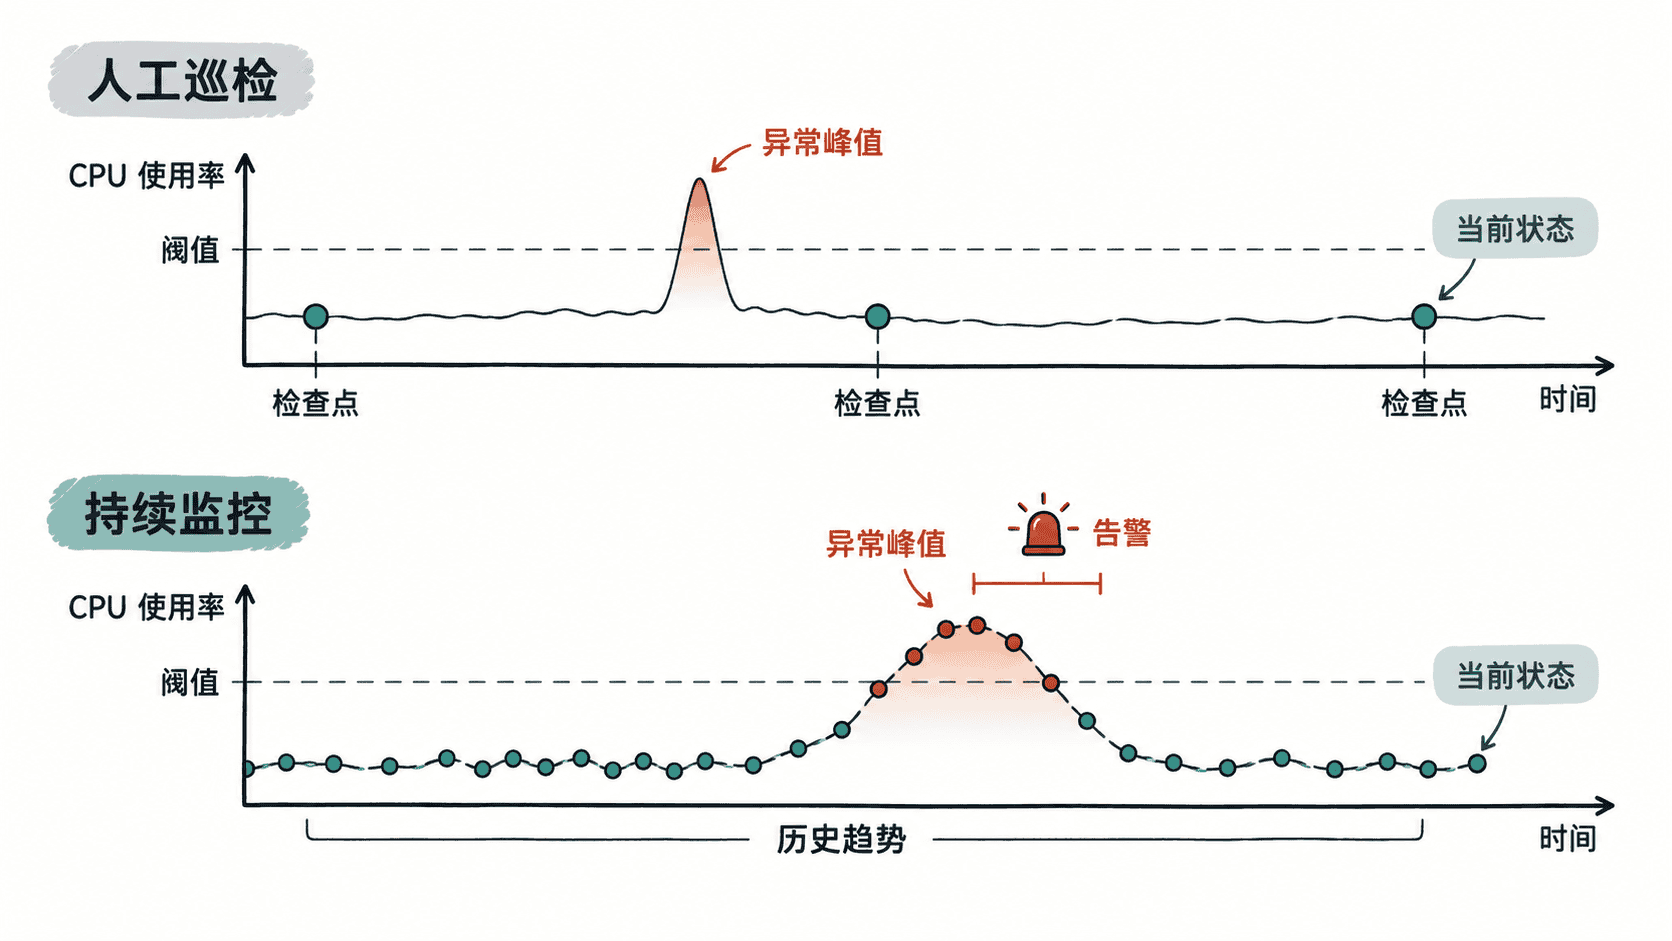
人工巡检适合快速确认服务器“现在怎么样”,但它很难连续回答负载何时开始升高、异常持续多久、问题是否反复出现。本篇把人工检查与持续监控放在同一时间轴上比较,帮助你判断哪些问题必须交给监控系统持续记录和告警。
学习目标
- 说清人工巡检只能看到时间点状态的局限
- 理解持续监控如何形成历史趋势并触发异常告警
- 判断人工检查与自动监控各自适合的使用场景
人工巡检得到的是一个时间点
登录服务器后执行 top、free、df 或查看服务状态,可以迅速确认当前 CPU、内存、磁盘和进程是否异常。这种方式的问题不在于数据不准确,而在于观察是离散的:上午 10 点看到正常,并不能证明 10 点 20 分没有发生过短暂故障。
如果故障已经恢复,人工再登录时往往只能看到恢复后的现场。没有历史样本,就很难回答“异常从什么时候开始”“峰值多高”“是否每天同一时段发生”。
持续监控补上时间维度
持续监控会按固定间隔采集指标,把每次观测保存成时间序列。这样同一个 CPU 使用率不再只是一个数,而是一串带时间戳的样本,可以观察趋势、峰值和周期性变化。
监控系统还可以把条件变成自动判断。例如磁盘可用空间持续低于阈值一段时间时触发告警,不必等待管理员恰好登录服务器后才发现问题。
人工检查仍然有价值
持续监控并不会替代人工排查。监控更擅长“持续观察并告诉你哪里不对”,人工检查更擅长“进入现场解释为什么不对”。实际运维通常把两者组合使用:监控负责发现和保留证据,管理员再根据告警进入主机检查进程、配置、日志和网络。
因此,服务器巡检不应被取消,而应从主要发现手段变成验证和深入排障手段。只靠人工巡检容易错过瞬时和周期性问题;持续监控则把这些不可见的时间空档变成可查询、可比较、可告警的历史数据。
按自己的节奏,确认真正理解。