
可观测性与稳定性 / 系统课时
Target 突然 Down 怎么排查
Target 突然 Down 怎么排查
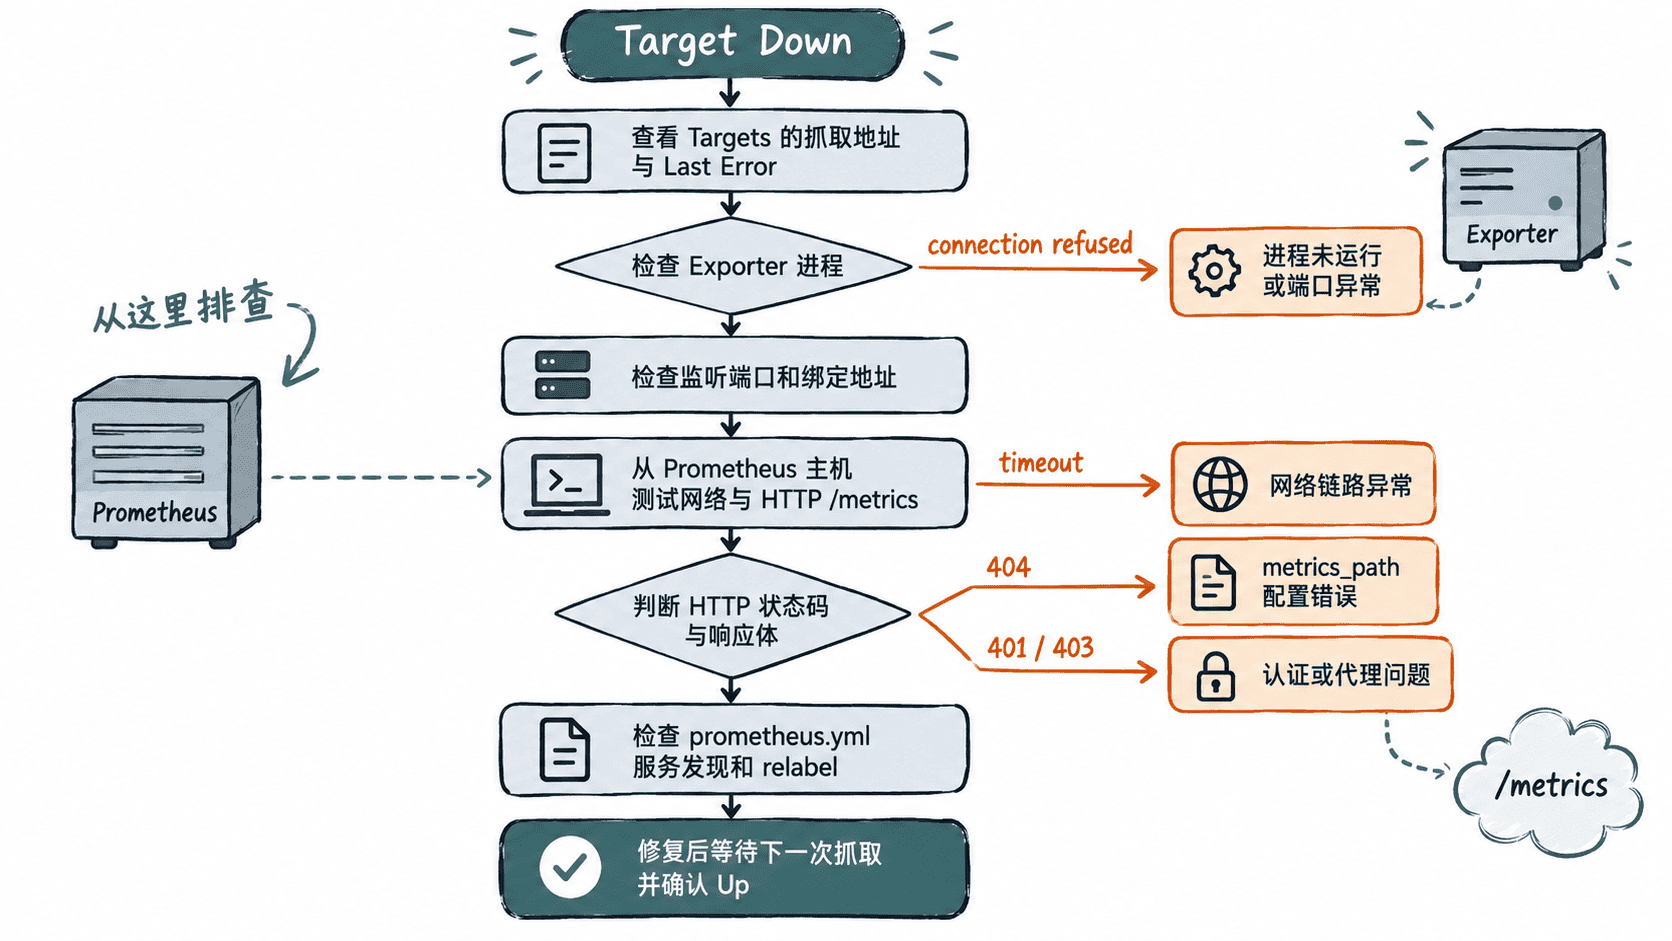
Prometheus 中 Target 从 Up 变成 Down,说明最近一次抓取没有成功完成。排查时不要先改配置,而应沿着“Exporter 是否运行 → 端口是否监听 → Prometheus 主机能否访问 → HTTP 是否返回正确内容 → 抓取配置是否匹配”的链路逐层缩小范围。
学习目标
- 按固定顺序定位 Target Down 的故障层级。
- 用进程、端口、网络和 HTTP 检查区分常见根因。
- 在修复后验证 Target 已恢复抓取,而不是只看进程重新启动。
先看 Prometheus 给出的失败信息
先打开 Prometheus 的 Targets 页面,找到变为 Down 的目标,记录实际抓取地址和 Last Error。错误文本通常已经能把问题缩小到某一层:连接被拒绝多半指向进程或监听端口,超时更像网络或防火墙问题,404 常见于路径不对,而 401、403 往往与认证或反向代理有关。
同时确认目标地址是不是你预期的那一个。服务发现或 relabel 配置改变后,Prometheus 可能仍然“找到”目标,但抓取到的是错误主机、错误端口或错误路径。
从 Exporter 主机确认进程和监听端口
先在 Exporter 所在服务器检查服务是否存活,以及预期端口是否真的处于监听状态。下面以 systemd 管理的 node_exporter 为例,把 <PORT> 替换成实际监听端口;实际服务名和端口可能不同。
PORT="<PORT>"

if systemctl is-active --quiet node_exporter; then
  echo "service=active"
else
  echo "service=inactive"
fi

if ss -lntH | awk '{print $4}' | grep -Eq ":${PORT}$"; then
  echo "listen=yes"
else
  echo "listen=no"
fi
预期输出
service=active
listen=yes
如果服务是 inactive,先检查该服务自己的日志和启动参数;如果服务正常但 listen=no,重点确认 Exporter 是否绑定到了不同端口或不同地址。只监听 127.0.0.1 时,远端 Prometheus 也无法直接访问。
从 Prometheus 主机验证网络与 HTTP
下一步必须从 Prometheus 所在主机发起访问,因为“在 Exporter 本机能 curl 通”不能证明跨主机网络可达。把 <HOST>、<PORT> 替换为 Targets 页面显示的目标地址;实际值可能不同。
HOST="<HOST>"
PORT="<PORT>"
OUT="/tmp/prometheus-target-metrics"

if CODE=$(curl --connect-timeout 3 --max-time 10 -sS -o "$OUT" -w '%{http_code}' "http://${HOST}:${PORT}/metrics"); then
  echo "http=${CODE}"
  if [ "$CODE" = "200" ] && [ -s "$OUT" ]; then
    echo "body=non-empty"
  else
    echo "body=unexpected"
  fi
else
  echo "http=curl_failed"
fi
预期输出
http=200
body=non-empty
curl_failed 说明连接、DNS、路由、防火墙或 TLS 建连阶段就失败了;能连通但不是 200,则检查抓取路径、认证、反向代理和协议是否正确。返回 200 但内容为空或不是 Prometheus 文本格式时,还要继续检查 Exporter 本身或中间代理。
再检查 Prometheus 配置
如果从 Prometheus 主机直接访问目标正常,而 Targets 页面仍然 Down,就回到 Prometheus 的抓取配置。先做语法检查,避免因为 YAML 修改错误导致你以为配置已经生效。把 <PATH> 替换为实际配置目录。
CONFIG="<PATH>/prometheus.yml"

if promtool check config "$CONFIG" >/dev/null 2>&1; then
  echo "config=valid"
else
  echo "config=invalid"
fi
预期输出
config=valid语法正确不代表逻辑正确。继续核对 job_name、目标主机、端口、metrics_path、scheme、认证配置和 relabel 结果,并确认 Prometheus 已成功重载这份配置。若使用服务发现,还要确认当前发现结果中仍存在这个目标。
修复后要验证完整抓取链路
修复动作完成后,不要只看 Exporter 进程是否恢复。回到 Targets 页面等待至少一个抓取周期,确认状态变为 Up、Last Scrape 时间持续更新,并且 Last Error 消失。随后用一个该目标确定存在的指标做查询,确认最新样本时间继续推进。
如果 Target 很快再次变 Down,应把注意力转向反复出现的资源耗尽、进程崩溃、连接数限制、代理超时或网络抖动,而不是重复重启服务。固定按照同一条链路记录每次失败点,通常比随机修改 Prometheus 配置更快找到真正根因。