
可观测性与稳定性 / 系统课时
一个监控系统由哪些部分组成
一个监控系统由哪些部分组成
持续监控不是把图表画出来就结束,而是要让指标能够被采集、存储、查询、展示,并在异常时主动通知。本篇用一条完整数据链说明 Exporter、Prometheus、Grafana 和 Alertmanager 各自负责什么,以及它们为什么要分工。
学习目标
- 说清 Exporter、Prometheus、Grafana 与 Alertmanager 的职责边界
- 理解指标从服务器到仪表盘、再到告警通知的数据流
- 能判断一个监控需求应该由哪个组件承担
四个核心组件各做什么
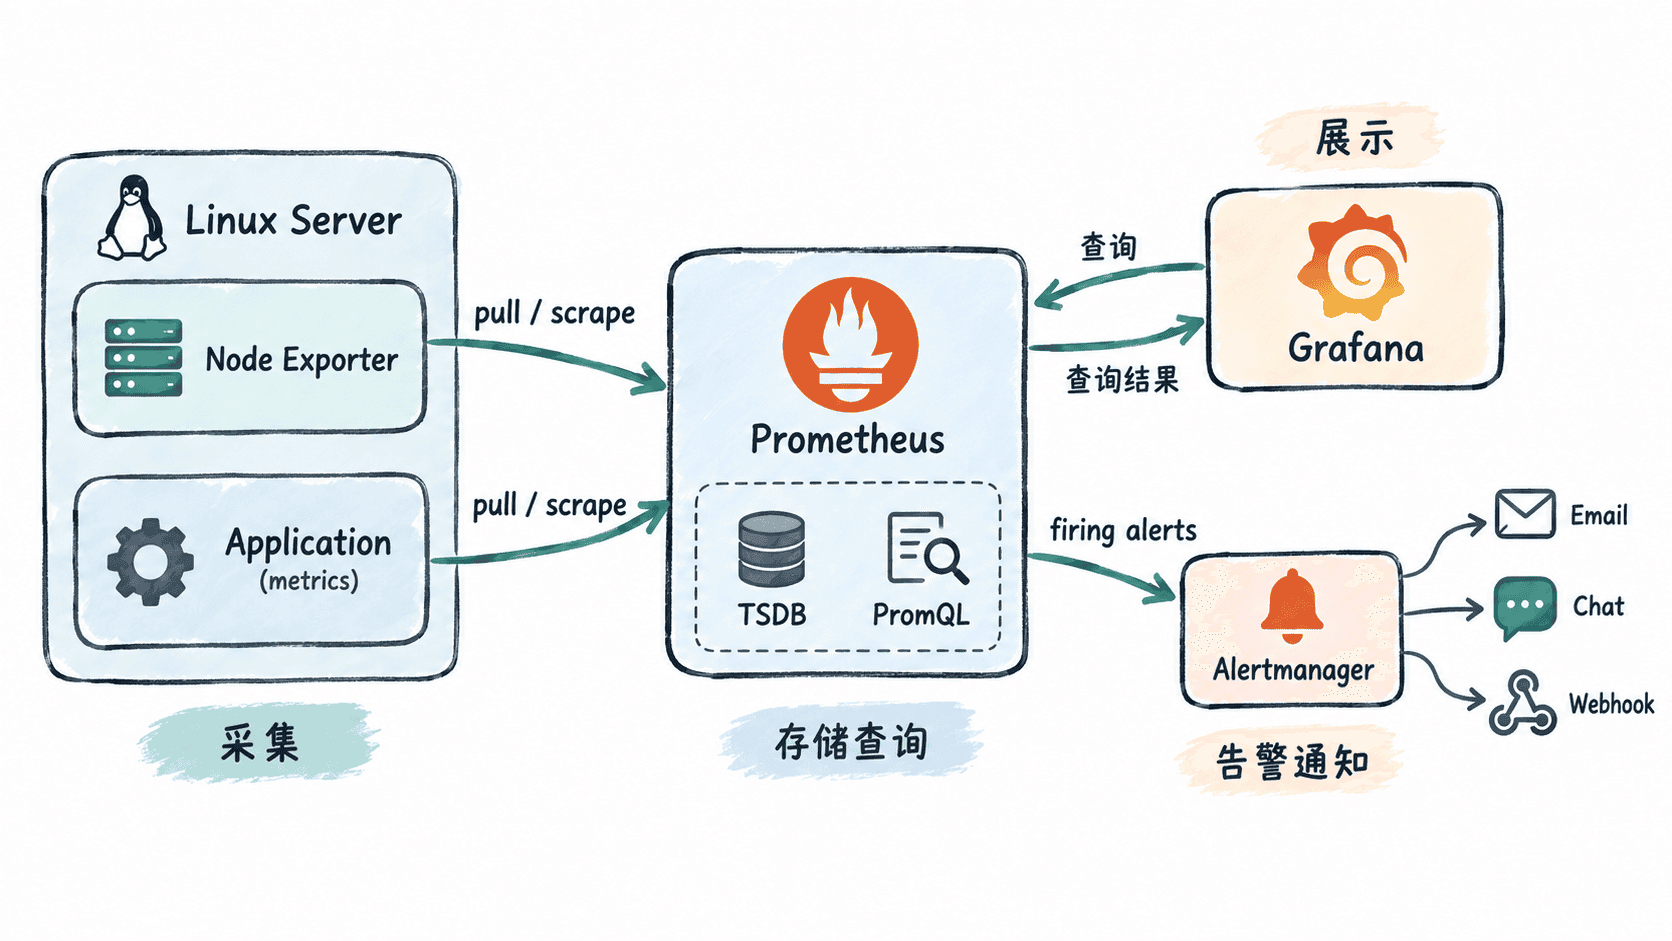
Exporter 负责把被监控对象的状态转换成 Prometheus 能抓取的指标格式。例如 Node Exporter 暴露 CPU、内存、磁盘、网络等主机指标,但它本身不负责长期保存数据,也不绘制仪表盘。
Prometheus 是监控链路的核心。它按配置周期主动抓取 Exporter 或应用暴露的指标,将带时间戳的样本写入时序数据库,并提供 PromQL 查询能力。规则计算和告警规则也通常在这里执行。
Grafana 负责可视化。它把 Prometheus 作为数据源,通过查询生成折线图、仪表盘和面板。Grafana 展示的是查询结果,并不替代 Prometheus 进行指标采集。
Alertmanager 负责处理 Prometheus 产生的告警事件,例如去重、分组、抑制和路由,再把通知发送到邮件、聊天工具或其他接收端。
指标怎样在系统里流动
以一台 Linux 服务器为例,Node Exporter 在本机监听一个 HTTP 端点并持续暴露最新指标。Prometheus 根据抓取配置定期访问这个端点,每次得到一批当前样本,再连同时间写入本地时序存储。
当用户打开 Grafana 仪表盘时,Grafana 会把面板里的 PromQL 发送给 Prometheus。Prometheus 对历史样本进行查询和聚合,再把结果返回给 Grafana。因此仪表盘刷新慢或无数据时,需要区分是采集失败、Prometheus 查询异常,还是 Grafana 面板配置有误。
告警链路与展示链路不同。Prometheus 根据告警规则判断条件是否持续满足,生成告警后发送给 Alertmanager。Alertmanager 再决定哪些告警合并发送、哪些暂时抑制、最终发给哪个通知渠道。
用最小配置理解抓取关系
下面的 Prometheus 配置只表达一件事:每 15 秒抓取一次运行在 <HOST>:9100 的 Node Exporter。实际主机地址应替换 <HOST>。
global:
  scrape_interval: 15s

scrape_configs:
  - job_name: node
    static_configs:
      - targets:
          - "<HOST>:9100"
保存配置并让 Prometheus 使用该文件启动后,目标可达时,它会周期性抓取 /metrics。这段配置的重点不是 Grafana 或告警,而是确认 Prometheus 与 Exporter 之间存在明确的抓取关系。
预期结果
Prometheus targets 页面中,job=node 的目标状态为 UP;实际抓取时间和地址会因环境不同而变化。组件边界为什么重要
如果服务器没有指标,首先检查 Exporter 是否运行、端点是否能访问,以及 Prometheus 目标是否为 UP;不要先改 Grafana。若 Prometheus 中能查询到数据,但仪表盘为空,再检查 Grafana 数据源和面板查询。
同样,告警没有发到聊天工具时,也要沿链路分层定位:Prometheus 是否产生告警、是否成功发送给 Alertmanager、Alertmanager 的路由是否匹配、接收端是否可达。分清职责后,监控系统的排障就从“看哪里都像有问题”变成沿数据流逐段验证。