
可观测性与稳定性 / 系统课时
RED 方法应该监控哪些指标
RED 方法应该监控哪些指标
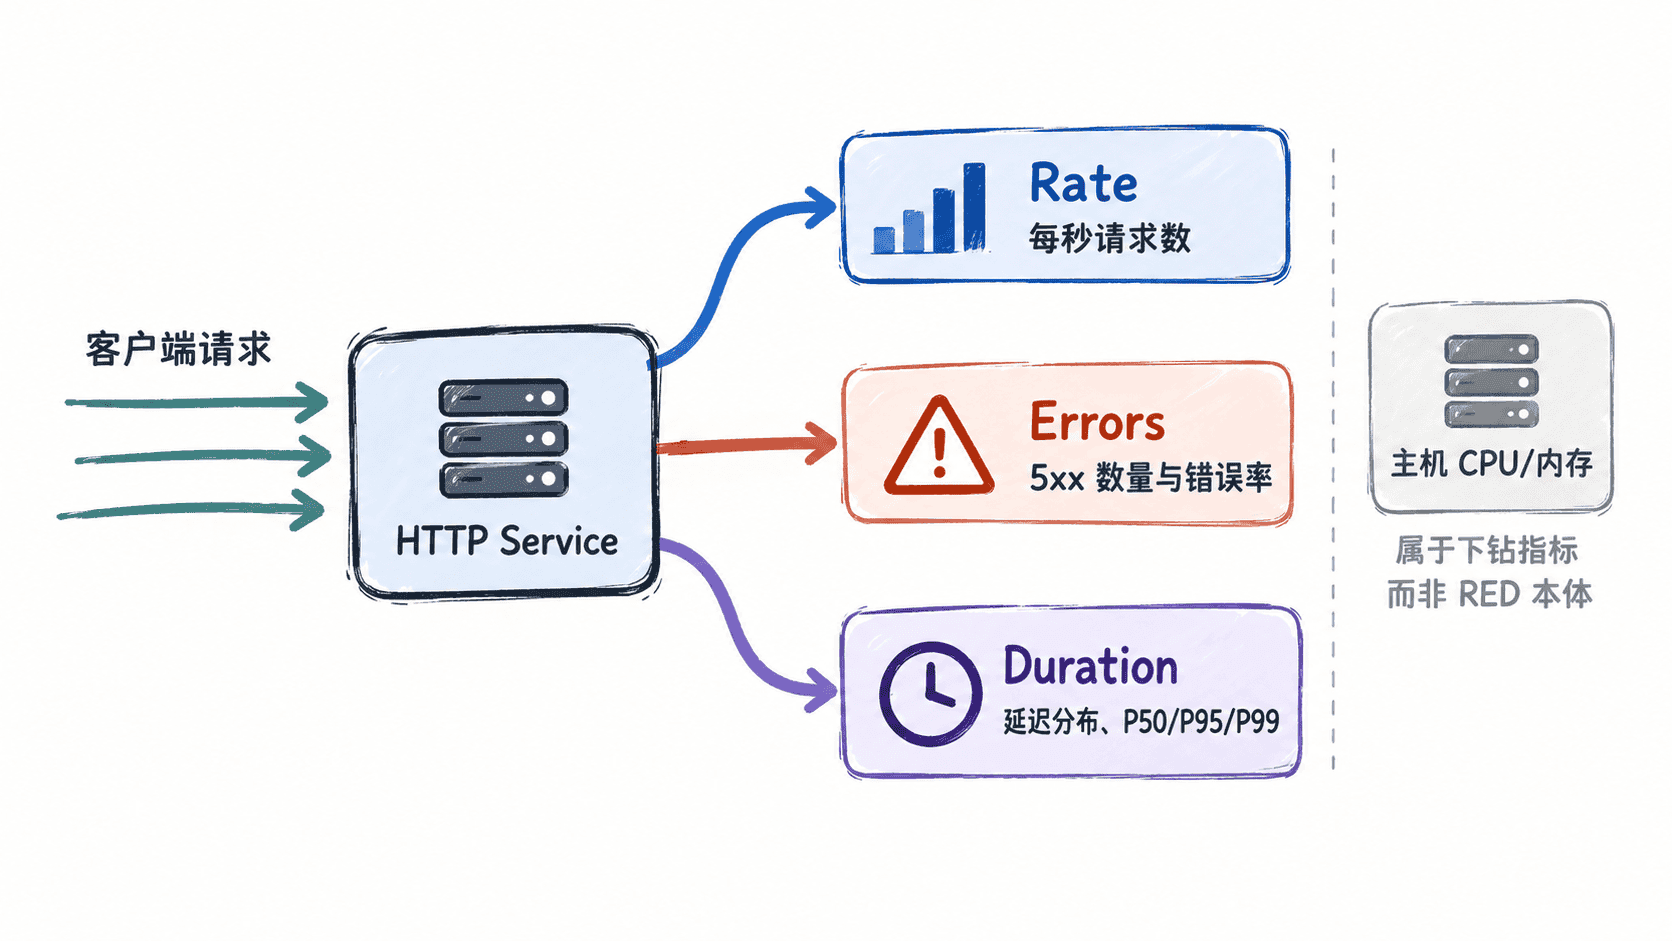
RED 方法把服务监控聚焦到三个直接反映用户体验的信号:请求速率、错误率和请求耗时。它不替代 CPU、内存等主机指标,而是先回答“服务现在是否在被使用、是否出错、是否变慢”,再决定是否需要继续下钻基础设施。
学习目标
- 解释 Rate、Errors、Duration 分别回答什么问题
- 为 HTTP 服务选择可计算 RED 的 Prometheus 指标
- 用 PromQL 计算请求速率、错误率和 P95 延迟
用三个信号看服务是否健康
RED 中的 Rate 是单位时间内处理的请求量,Errors 是失败请求占比或失败请求速率,Duration 是请求耗时分布。三者应一起看:流量突增可能推高延迟,错误率升高可能来自依赖故障,而低流量时单个错误又可能让错误率显得异常高。
Rate 看服务承受了多少请求
假设应用暴露计数器 http_requests_total,并至少带有 route、method、status 等低基数标签。计数器只会累加,不能直接拿当前值当“请求速率”,应使用 rate() 计算一段时间内的平均增长速度。
sum by (route) (
  rate(http_requests_total[5m])
)
预期结果
{route="/api/orders"} <RATE>
{route="/api/users"} <RATE>
<RATE> 是对应路由近 5 分钟的平均每秒请求数,实际值会随流量变化。按 route 聚合通常比按原始 URL 聚合安全,因为把订单 ID、用户 ID 放进标签会造成高基数。
Errors 看失败是偶发还是持续
对 HTTP 服务,常见做法是把 5xx 视为服务端错误,再用错误请求速率除以总请求速率。比单看“每秒 5xx 数量”更重要的是比例,因为 10 个错误发生在 20 个请求和 10 万个请求中的意义完全不同。
sum(rate(http_requests_total{status=~"5.."}[5m]))
/
sum(rate(http_requests_total[5m]))
预期结果
<ERROR_RATIO><ERROR_RATIO> 取值通常在 0 到 1 之间,例如 0.02 表示约 2% 请求为 5xx。没有请求时分母可能为 0,因此告警应同时考虑最小流量,避免在极低流量下被单个失败请求放大。
Duration 看尾部延迟而不是只看平均值
请求耗时更适合用 Histogram 记录。若应用暴露经典直方图 http_request_duration_seconds_bucket,可以先对 bucket 求速率,再用 histogram_quantile() 估算分位数。
histogram_quantile(
  0.95,
  sum by (le, route) (
    rate(http_request_duration_seconds_bucket[5m])
  )
)
预期结果
{route="/api/orders"} <SECONDS>
{route="/api/users"} <SECONDS>
<SECONDS> 是估算出的 P95 请求耗时,单位与指标名一致,这里是秒。P95 比平均值更容易暴露“多数请求正常、少量请求非常慢”的尾延迟;如果要判断用户体验,P95 或 P99 通常比平均耗时更有解释力。
让三个指标形成同一个判断窗口
Rate 负责提供负载背景,Errors 反映正确性,Duration 反映响应速度。服务总览中应让三类图表使用相同时间范围,并优先按稳定维度如 service、route、method 下钻。只有当 RED 显示异常后,再结合 CPU、内存、磁盘、连接池或依赖服务指标追根因,才能避免一上来就在几十个基础设施面板里盲目搜索。