
可观测性与稳定性 / 系统课时
指标突然变成巨大数值为什么
指标突然变成巨大数值为什么
Counter 在进程重启后会从较小值重新开始累计。如果监控链路把“当前值减上一次值”当成增量,又在后续把负数转换成无符号整数,就可能得到接近 2^64 的巨大正数。正确做法是识别 Counter reset,并使用适合 Counter 的函数计算速率或增量。
学习目标
- 理解进程重启为什么会让 Counter 出现 reset
- 能解释错误差值计算如何把负数变成巨大正数
- 能用
rate()或increase()避免把 Counter reset 当成真实流量突增
Counter 重启后为什么会回到较小值
Counter 只保证在单个进程生命周期内单调递增。应用重启、容器重建或指标实例被替换后,新进程通常会从 0 重新累计。例如某实例先上报 1020,重启后下一次只上报 12,这不是业务量减少了 1008,而是时间序列发生了 Counter reset。
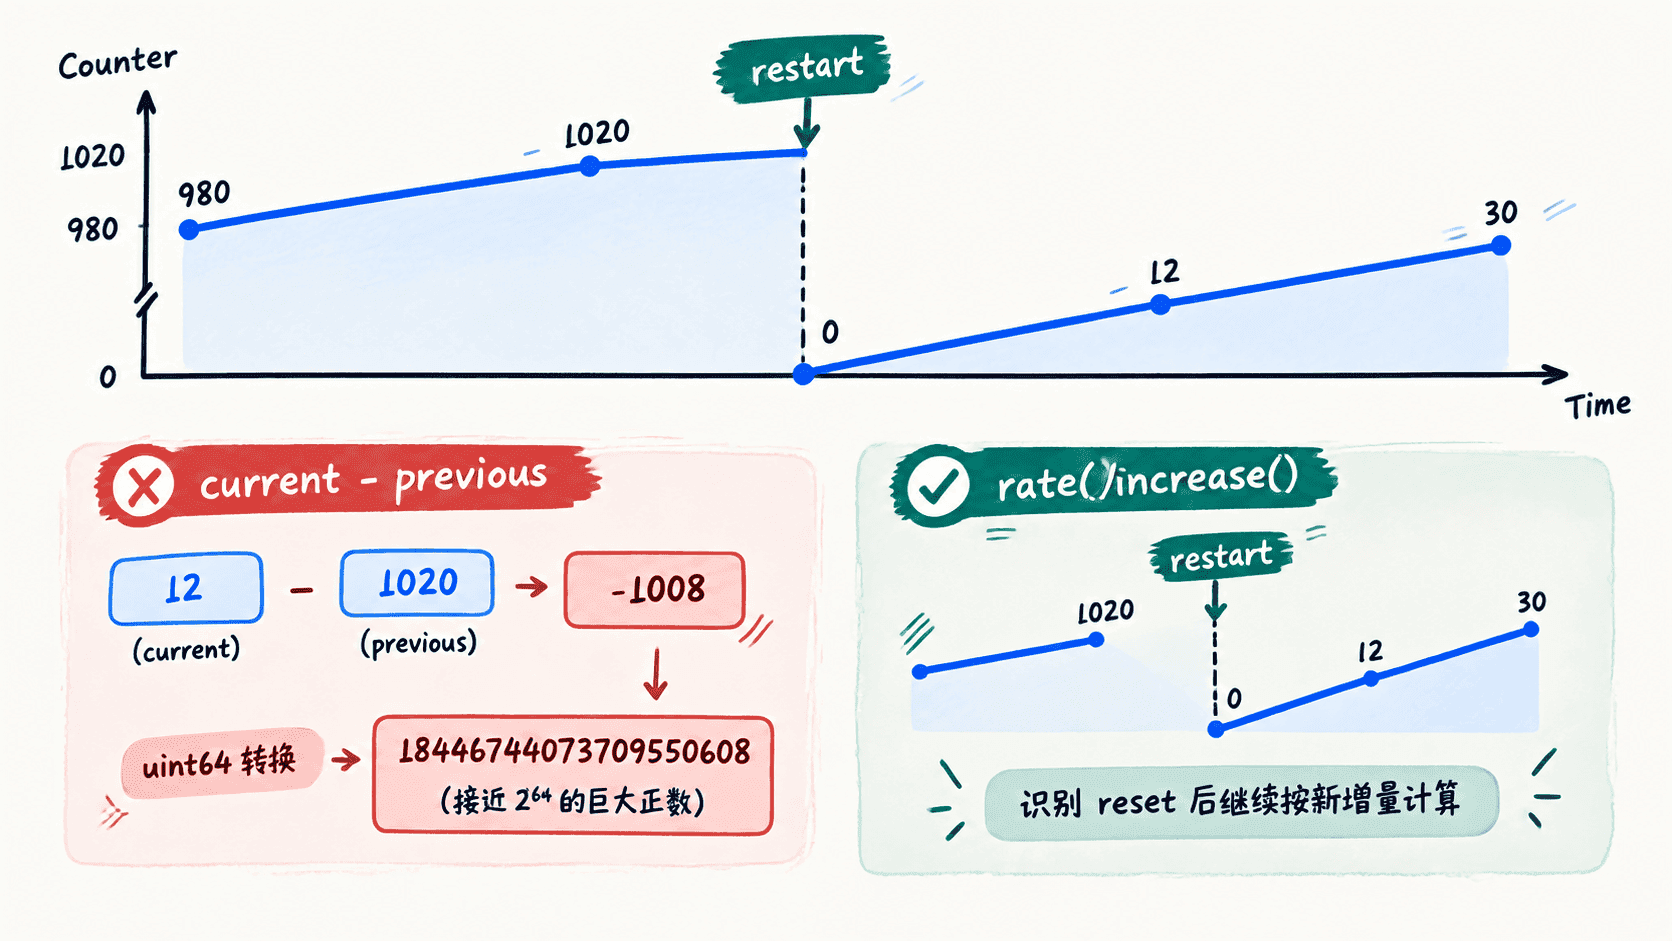
Prometheus 保存 Counter 时,并不会把不同进程生命周期拼成一个永远递增的大整数。查询阶段必须采用理解 Counter reset 的计算方式,才能避免把回退误判成异常变化。
巨大数值通常来自错误的差值处理
如果某个程序、Grafana Transform、脚本或下游系统直接计算两次采样的差值,重启后的第一段差值会变成负数。负数本身通常比较容易发现;真正“巨大”的值往往发生在这个负数又被转换成无符号 64 位整数时。
下面用一个最小示例演示这种下溢现象:
python3 - <<'PY'
previous = 1020
current = 12
diff = current - previous
as_uint64 = diff % (1 << 64)
print(diff)
print(as_uint64)
PY
预期输出
-1008
18446744073709550608
这里的巨大值并不代表真实请求量,而是 -1008 在无符号 64 位数值空间中的环绕结果。若图表中突然出现接近 18446744073709551615 的数字,应优先检查是否存在直接差值、无符号类型转换或类似的数据处理逻辑。
Counter 应使用 rate 或 increase
在 Prometheus 中,不要用适合 Gauge 的普通差值思路计算 Counter。请求数、错误数、处理任务数这类 Counter,应根据展示目标选择 rate() 或 increase()。
例如查询最近 5 分钟的请求增量:
curl -G -s 'http://localhost:9090/api/v1/query' \
  --data-urlencode 'query=increase(http_requests_total[5m])'
预期输出
{"status":"success","data":{"resultType":"vector","result":[{"metric":{"instance":"<HOST>:<PORT>","job":"<JOB>"},"value":[<TIME>,"<INCREASE>"]}]}}<HOST>、<PORT>、<JOB>、<TIME> 和 <INCREASE> 会随环境变化。increase() 会按照 Counter 语义处理查询窗口中的 reset;如果要展示每秒平均增长速率,则使用 rate(http_requests_total[5m])。
排查时先确认是不是重启
看到异常尖峰时,先把 Counter 原始值与进程启动时间放到同一时间范围观察。常见的 process_start_time_seconds 指标可以帮助确认异常点附近是否发生进程重启;容器环境还可以结合 Pod 重建时间或应用启动日志交叉验证。
如果原始 Counter 在同一时刻明显从高值回落到接近 0,而进程启动时间也发生变化,就可以确认发生了 reset。此时应继续检查面板或下游计算是否使用 rate()、increase(),以及是否存在把负差值强制转换为无符号整数的步骤。
验证修复是否真正生效
修复后应重新观察至少一个完整查询窗口。正确结果应表现为:Counter 原始值仍允许在进程重启时回落,但基于 rate() 或 increase() 的图表不会再出现由 reset 造成的巨大尖峰。若尖峰仍存在,再检查标签是否错误合并了多个实例、采样间隔是否异常,以及指标本身是否真的在短时间内快速增长。