
可观测性与稳定性 / 系统课时
构建 Linux 服务监控闭环
构建 Linux 服务监控闭环
本节把主机指标和服务 RED 指标串成可验证闭环:Prometheus 采集指标,Grafana 提供总览与下钻,告警规则发现异常,再通过停止测试服务验证通知、定位和恢复。目标不是“有图表”,而是异常发生后能被发现、解释并确认恢复。
学习目标
- 为 Linux 主机和 HTTP 服务设计一组最小但可行动的指标
- 组织 Prometheus 采集、Grafana 总览和告警规则之间的关系
- 注入服务异常并验证告警、下钻、恢复的完整链路
先定义闭环的验收路径
一个可用的监控闭环至少包含五个动作:采集、展示、告警、定位、恢复。这里假设每台 Linux 主机运行 node_exporter,示例 HTTP 服务暴露 http_requests_total 与 http_request_duration_seconds_bucket,Prometheus 负责抓取,Grafana 查询 Prometheus,Alertmanager 已连接一个通知渠道。
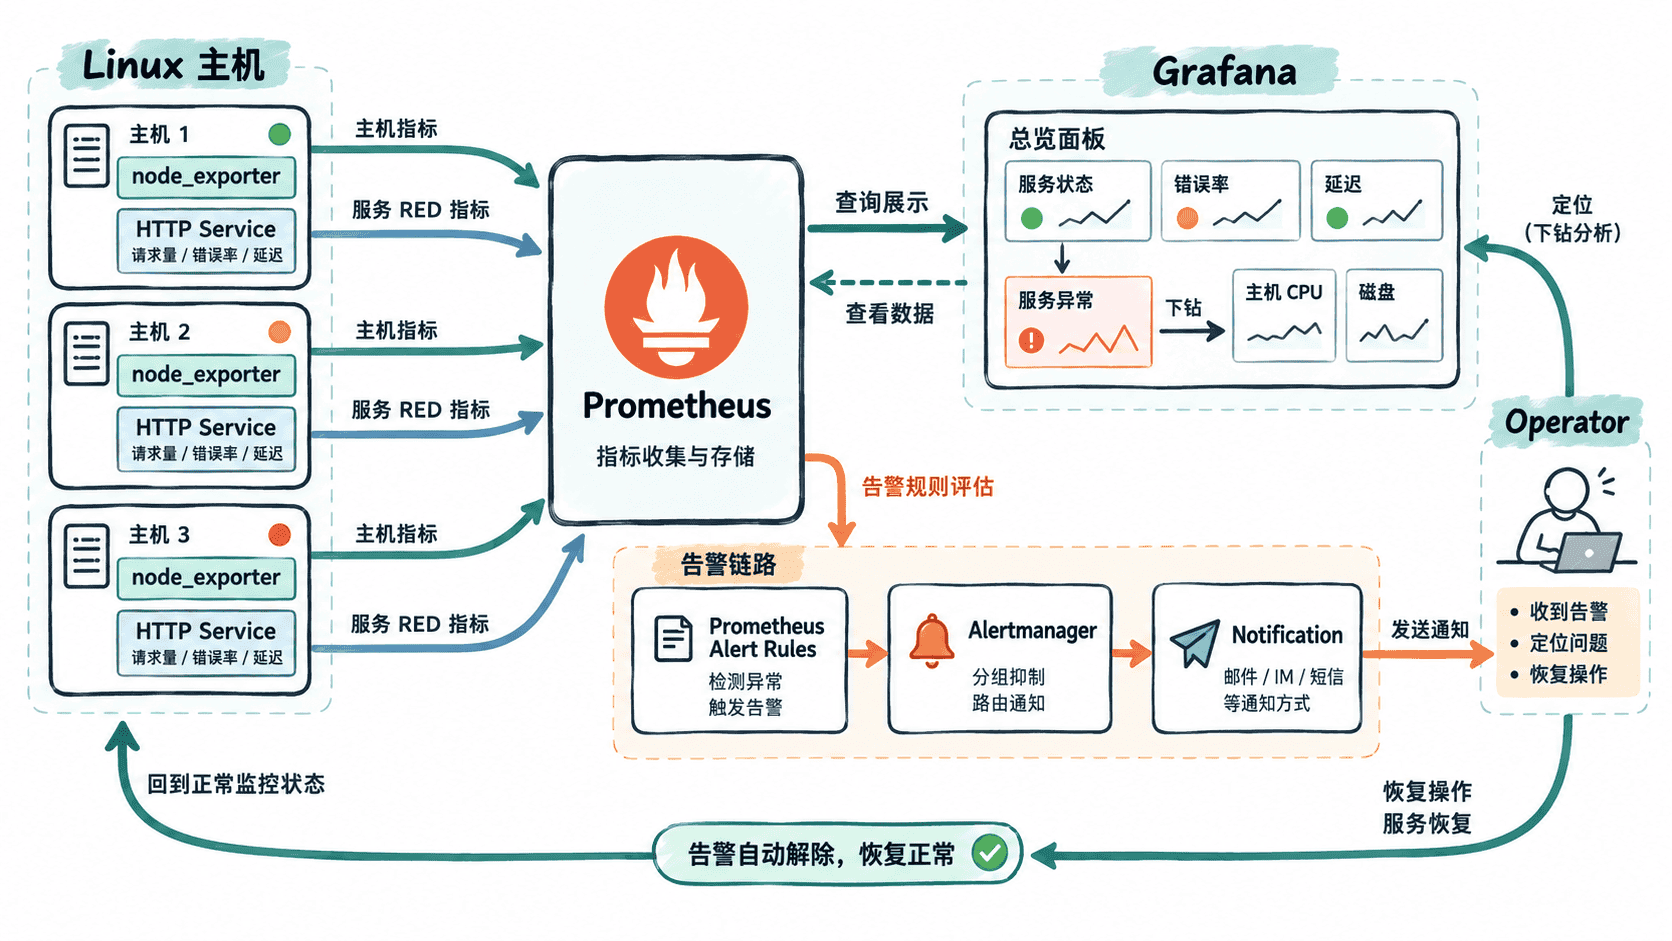
验收时应能回答三个问题:异常发生后多久被发现;告警里能否直接看到受影响实例和服务;恢复后告警是否自动回到正常。只要这三点有一项依赖人工猜测,闭环就还没有完成。
配置采集目标和最小指标集
Prometheus 可以把主机和应用拆成两个 job,便于后续聚合与告警。下面是配置片段,<HOST> 替换为真实主机名或 IP,端口按实际 exporter 与服务配置调整。
scrape_configs:
  - job_name: node
    static_configs:
      - targets:
          - "<HOST>:9100"

  - job_name: demo-api
    metrics_path: /metrics
    static_configs:
      - targets:
          - "<HOST>:8080"
这段配置生效后,Prometheus 的 Targets 页面应能看到两个目标为 UP。主机侧至少保留可用性、CPU、内存、文件系统空间;服务侧至少保留请求速率、5xx 错误率和 P95 延迟。不要在第一版总览里堆几十个指标,优先保证每个指标都能支持一个明确动作。
用 PromQL 连接总览与下钻
Grafana 总览建议先放四类面板:实例可用性、CPU 使用率、服务错误率和 P95 延迟。下面的查询可直接作为面板表达式,先看是否存在异常,再按 instance 或 route 下钻。
100 * (
  1 - avg by (instance) (
    rate(node_cpu_seconds_total{job="node",mode="idle"}[5m])
  )
)
预期结果
{instance="<HOST>:9100"} <CPU_PERCENT><CPU_PERCENT> 是近 5 分钟平均 CPU 使用率百分比。
sum by (instance) (
  rate(http_requests_total{job="demo-api",status=~"5.."}[5m])
)
/
sum by (instance) (
  rate(http_requests_total{job="demo-api"}[5m])
)
预期结果
{instance="<HOST>:8080"} <ERROR_RATIO>histogram_quantile(
0.95,
sum by (le, instance) (
rate(http_request_duration_seconds_bucket{job="demo-api"}[5m])
)
)预期结果
{instance="<HOST>:8080"} <SECONDS>实际值会随负载变化。总览只负责指出“哪台实例、哪类信号异常”,详细面板再补充磁盘剩余空间、内存、进程或依赖服务,避免把所有排障信息同时塞进首屏。
用告警规则把异常变成可行动事件
下面的规则分别检测应用抓取失败和持续高错误率。规则文件是配置片段,加载后应在 Prometheus Rules 页面看到对应规则;Alertmanager 路由成功后,触发的告警应进入已配置的通知渠道。
groups:
  - name: demo-api
    rules:
      - alert: DemoApiDown
        expr: up{job="demo-api"} == 0
        for: 2m
        labels:
          severity: critical
        annotations:
          summary: "demo-api target is down"
          description: "Prometheus cannot scrape {{ $labels.instance }} for 2 minutes."

      - alert: DemoApiHighErrorRate
        expr: |
          (
            sum by (instance) (
              rate(http_requests_total{job="demo-api",status=~"5.."}[5m])
            )
            /
            sum by (instance) (
              rate(http_requests_total{job="demo-api"}[5m])
            )
          ) > 0.05
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "demo-api error rate is above 5%"
description: "Instance {{ $labels.instance }} has sustained 5xx errors."这里把“短暂抖动”和“持续故障”区分开:for 可以减少瞬时失败造成的噪声,但也会增加发现延迟。生产环境应根据业务 SLO、采集间隔和故障容忍度调整阈值,而不是机械复用 2 分钟或 5%。
注入异常并完成发现到恢复
选择一台测试主机和一个可安全停止的 systemd 服务,将 <SERVICE> 替换为实际 unit 名。不要在生产高峰执行故障注入。
sudo systemctl stop <SERVICE>
systemctl is-active <SERVICE>
预期输出
inactive如果 Prometheus 直接抓取这个服务的 /metrics,下一次抓取后 up{job="demo-api"} 会变为 0;持续达到规则中的 2 分钟后,DemoApiDown 进入 firing,Alertmanager 应发出通知。收到通知后先在 Grafana 确认服务不可用,再检查同一实例的 CPU、内存和磁盘,验证问题是否仅限服务进程。
恢复服务后再次确认状态:
sudo systemctl start <SERVICE>
systemctl is-active <SERVICE>
预期输出
active随后 up{job="demo-api"} 应恢复为 1,告警状态在下一轮规则评估后回到正常,通知渠道应出现恢复事件或不再显示活动告警,具体呈现取决于 Alertmanager 接收端。到这里,采集、展示、告警、定位和恢复才真正连成一个可重复验证的 Linux 服务监控闭环。