
可观测性与稳定性 / 系统课时
job 和 instance 标签表示什么
job 和 instance 标签表示什么
当 Prometheus 同时抓取多台服务器和多个服务时,仅看指标名无法知道样本来自哪里。job 与 instance 是最常见的目标标签:前者表示一类抓取任务,后者标识其中某个具体抓取目标。
学习目标
- 解释
job与instance的默认来源和职责 - 使用两个标签筛选同类服务或单个目标
- 避免把
job、instance当成业务标签或主机名的固定替代品
两个标签分别回答什么问题
job 回答“这组目标属于哪一类抓取任务”。在常见配置中,它默认来自 scrape_configs 里的 job_name。例如把所有 Node Exporter 节点放到 linux-nodes 任务中,它们通常都会带上 job="linux-nodes"。
instance 回答“这个样本来自哪个具体抓取目标”。如果没有在重标签阶段显式提供 instance,Prometheus 通常会用最终抓取地址生成它,例如 <HOST>:9100。因此同一个 job 下可以有多个不同的 instance。
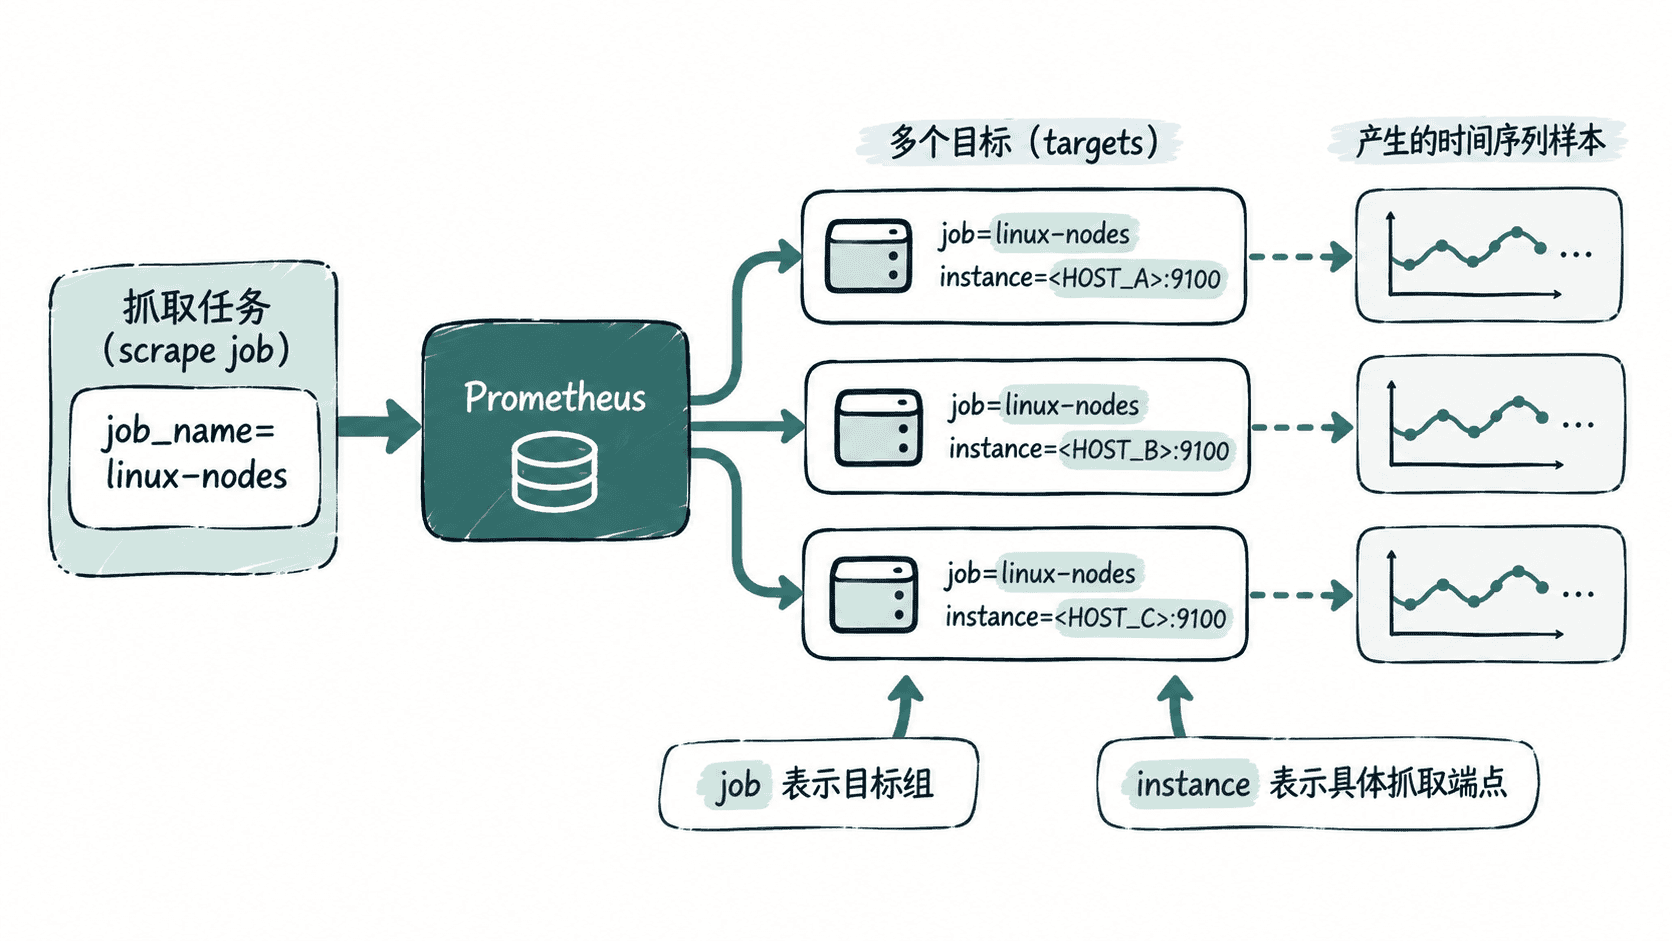
下面是一个最小配置片段。它声明了一个抓取任务和两个目标:
scrape_configs:
  - job_name: linux-nodes
    static_configs:
      - targets:
          - "<HOST_A>:9100"
- "<HOST_B>:9100"这是片段示例,需要放入有效的 Prometheus 配置文件并替换主机占位符。配置加载后,可在目标页面确认两个抓取目标都归属于 linux-nodes,并检查实际生成的 instance 值。
用 PromQL 按来源筛选
查询同一类目标时,通常按 job 过滤:
up{job="linux-nodes"}预期结果
up{instance="<HOST_A>:9100",job="linux-nodes"} 1
up{instance="<HOST_B>:9100",job="linux-nodes"} 1
up 的值为 1 表示最近一次抓取成功;真实环境中的标签集合、目标地址和排序可能不同。
只检查一个目标时,再增加 instance 条件:
up{job="linux-nodes",instance="<HOST_A>:9100"}预期结果
up{instance="<HOST_A>:9100",job="linux-nodes"} 1这种写法适合定位“整类服务异常”还是“单个目标异常”。如果图表按 job 聚合,就能观察服务组整体状态;如果按 instance 分组,就能看到每个目标的差异。
不要把标签含义想得过于固定
job 不是应用进程自动上报的“业务名称”,而是 Prometheus 抓取配置中的目标分组标签。一个应用完全可能因为不同环境或抓取策略而出现在不同 job 中。
instance 也不一定等于操作系统主机名。默认情况下它更接近“Prometheus 实际抓取的目标地址”,可能是主机加端口、服务发现产生的地址,或经过 relabeling 后的值。需要稳定的机器名、集群名、环境名时,应使用语义明确的独立标签,例如 host、cluster、env。
设计查询时怎样使用它们
排查抓取问题时,先看 job 能快速判断某类目标是否普遍失败;再看 instance 可以缩小到具体端点。做容量或业务聚合时,不应默认把 instance 当成永久身份,因为目标地址可能随部署方式变化。
把 job 理解为“目标组”,把 instance 理解为“具体抓取端点”,就能在绝大多数 Prometheus 查询中正确使用这两个标签,同时把真正的业务维度交给更明确的自定义标签。