
可观测性与稳定性 / 系统课时
Label 为什么决定时间序列数量
Label 为什么决定时间序列数量
Prometheus 中最容易被低估的成本不是指标名称有多少,而是同一个指标能组合出多少组 Label 值。每出现一种新的 Label 组合,就会产生新的时间序列;如果把用户 ID、请求 ID 或完整 URL 这类高变化值放进 Label,序列数量可能迅速膨胀。
学习目标
- 理解每一种不同的 Label 组合都会形成独立时间序列
- 能粗略估算多个 Label 组合可能产生的序列数量
- 能识别容易造成高基数的 Label 设计
Label 组合就是序列身份
假设应用暴露下面三条指标:
api_requests_total{method="GET",status="200"} 1200
api_requests_total{method="POST",status="200"} 430
api_requests_total{method="GET",status="500"} 12
它们共享指标名称 api_requests_total,但 Label 组合分别是 GET + 200、POST + 200 和 GET + 500,因此 Prometheus 会维护三条独立时间序列。
如果第一条的值从 1200 变成 1250,不会增加序列数量;如果第一次出现 method="DELETE",status="200",则会新增一条序列。
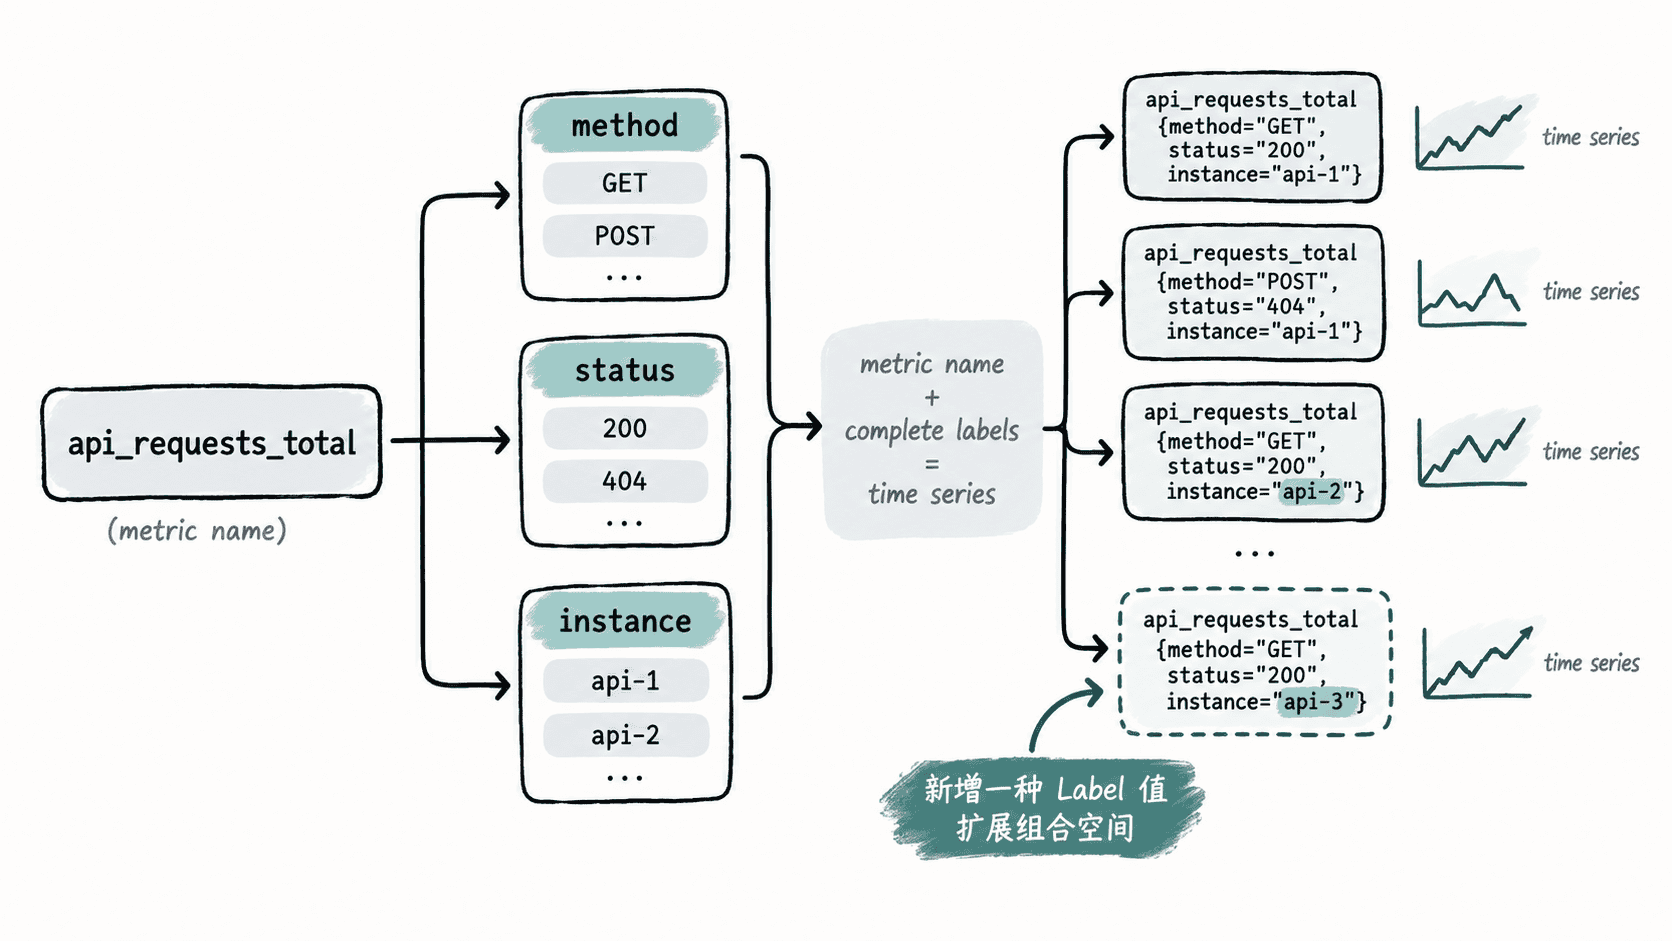
为什么多个 Label 会放大数量
如果一个指标有多个 Label,潜在序列数取决于这些 Label 值实际出现的组合。为了做容量估算,可以先用各维度取值数量的乘积计算一个粗略上界。
假设某个接口指标包含这些维度:
method有 3 种值status有 5 种值path有 200 种值instance有 20 种值
如果所有组合都实际出现,可能产生:
也就是单个指标名称就可能对应 60000 条时间序列。实际系统未必会出现完整笛卡尔积,但这个估算能快速暴露风险:某个 Label 的可选值越多,它对总序列数的放大作用越明显。
高基数 Label 为什么危险
所谓高基数 Label,是指它可能拥有非常多不同值。例如下面的设计会让每个用户形成一组新的序列:
login_requests_total{user_id="100001"} 4
login_requests_total{user_id="100002"} 7
login_requests_total{user_id="100003"} 2
如果系统有一百万个活跃用户,仅 user_id 这一维就可能产生大量时间序列;再叠加 instance、region 或 status,数量还会继续增加。
类似风险还包括 request_id、会话 ID、订单号、完整异常消息以及未经归一化的 URL。这些值通常接近“一次请求一个新值”,不适合作为监控聚合维度。
URL Label 的常见陷阱
下面两条请求实际属于同一种接口模式,但如果直接使用原始路径,就形成不同 Label 值:
http_requests_total{path="/users/1001"} 3
http_requests_total{path="/users/1002"} 5
更适合监控的设计是把动态参数归一化为路由模板:
http_requests_total{route="/users/:id"} 8这样无论访问多少不同用户,监控维度仍然只有一个稳定的 route 值,同时还能回答“这个接口整体请求了多少次、错误率如何、延迟怎样”等运维问题。
设计 Label 时先问三个问题
增加一个 Label 前,先确认它的取值集合是否有限、这些值是否真的需要独立聚合,以及取值数量会不会随请求量或业务对象数量持续增长。
像 method、status、region、固定服务名通常比较稳定;用户 ID、订单 ID、随机 UUID 和原始请求路径则需要格外谨慎。Prometheus 的序列数量并不是由“有几个 Label”简单决定,而是由实际出现了多少种完整 Label 组合决定。控制这些组合的规模,就是控制监控系统基数的核心。