
可观测性与稳定性 / 系统课时
控制高基数与无效指标
控制高基数与无效指标
Prometheus 的存储成本主要由时间序列数量和采样频率共同决定。真正危险的通常不是“指标名很多”,而是标签值不断增长,让一个指标裂变成大量序列。本节从基数检查、采集过滤和标签治理入手,把成本控制放在样本进入 TSDB 之前。
学习目标
- 判断哪些标签会造成时间序列基数快速增长
- 使用 TSDB 状态接口定位高基数指标和标签
- 使用
metric_relabel_configs过滤无效指标并删除不需要的标签
先判断成本来自哪里
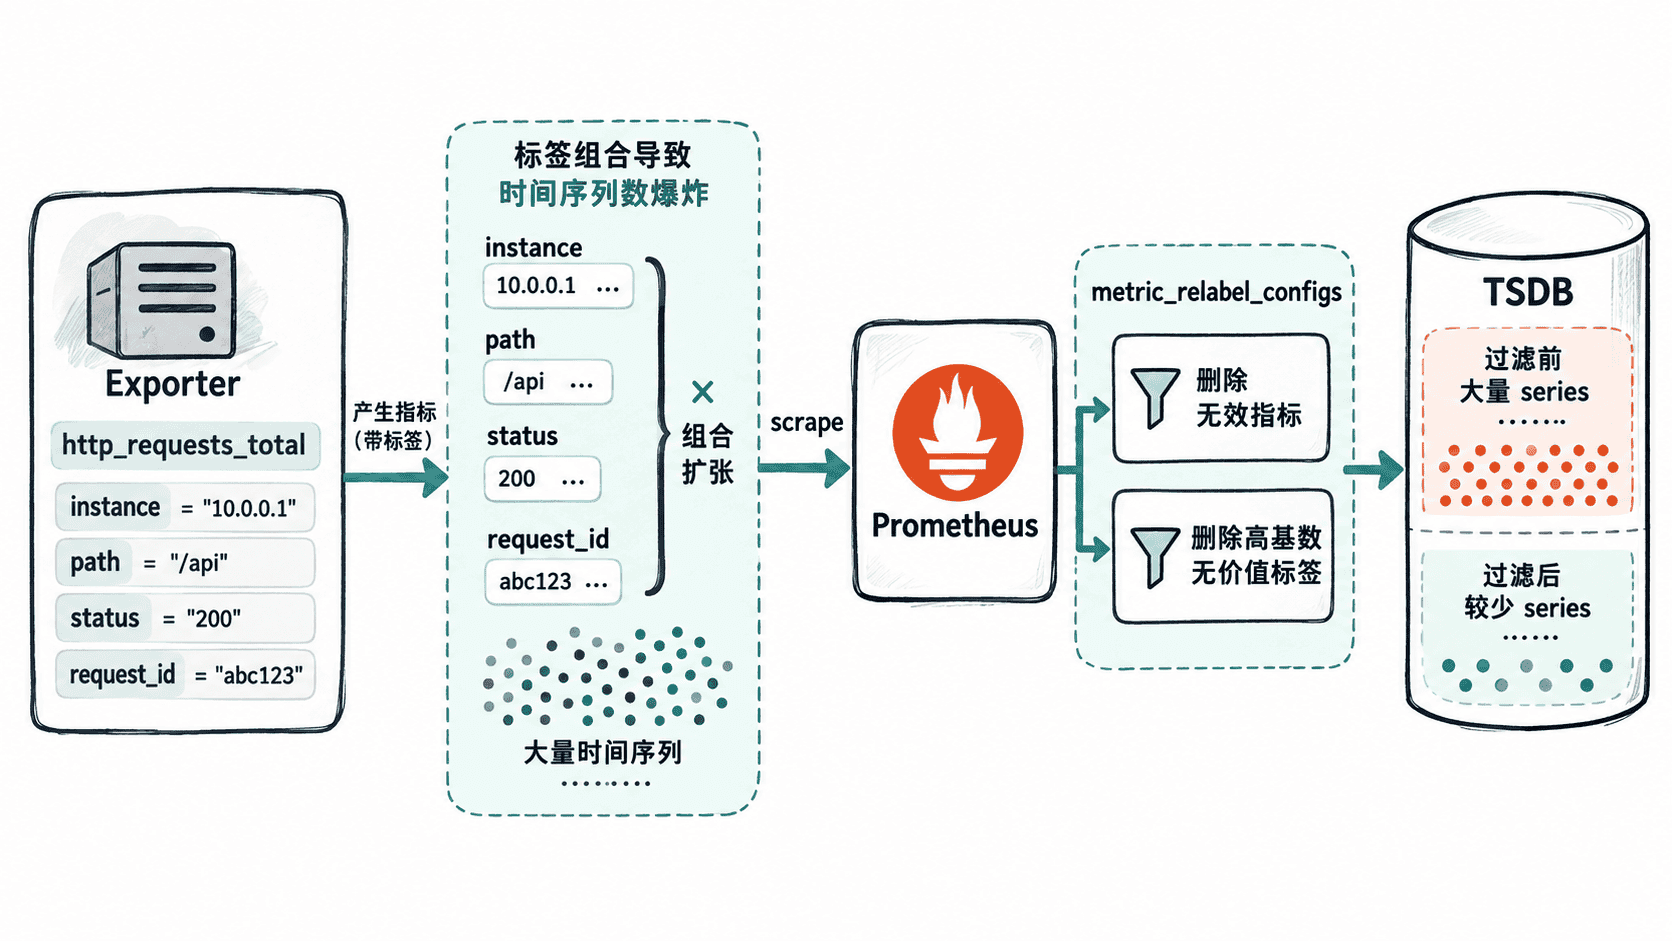
Prometheus 用“指标名 + 完整标签集合”标识一条时间序列。假设一个请求指标带有 instance、path、status 三个标签,200 台主机、50 个路径、5 种状态理论上就可能形成 50000 条序列。若再加入持续变化的 user_id、request_id、trace_id,序列数会迅速失控。
因此要优先警惕两类维度:一类是近似无界的标识符,例如订单号、请求 ID、完整 URL;另一类是虽然有限但组合数量很大的标签,例如设备、挂载点、容器、路径和状态同时出现。日志适合保存单次事件的细节,指标标签更适合保存可聚合的有限维度。
用 TSDB 状态接口找高基数来源
Prometheus 的 /api/v1/status/tsdb 会返回当前 Head 数据的序列总数,以及按指标名和标签名统计的基数信息。先看总量,再找序列数最多的指标,最后追查标签值数量异常的标签,比凭感觉删指标可靠得多。
下面命令假设 Prometheus 运行在本机 <PORT> 端口;实际环境把 <PORT> 替换为监听端口。
curl -fsS "http://localhost:<PORT>/api/v1/status/tsdb?limit=5" | jq '{numSeries: .data.headStats.numSeries, topMetrics: .data.seriesCountByMetricName, topLabels: .data.labelValueCountByLabelName}'预期输出
{
  "numSeries": <COUNT>,
  "topMetrics": [
    {
      "name": "<METRIC>",
      "value": <COUNT>
    }
  ],
  "topLabels": [
    {
      "name": "<LABEL>",
      "value": <COUNT>
    }
  ]
}
实际指标名、标签名和计数会随采集目标变化。发现某个指标占据大量序列后,还要确认它是否真的用于告警、Dashboard 或容量分析;“数量大”本身不是删除理由。
在采集侧过滤无价值样本
metric_relabel_configs 在样本写入 Prometheus 之前处理已抓取的指标,适合丢弃确定不需要的指标族,或删除没有分析价值的标签。下面配置以一个示例 exporter 为目标:团队决定不保存 exporter 自身的 Go 与进程指标,并确认 request_id、trace_id 只是误加的事件级标签。
global:
  scrape_interval: 15s

scrape_configs:
  - job_name: example-exporter
    static_configs:
      - targets:
          - localhost:9200
    sample_limit: 20000
    metric_relabel_configs:
      - source_labels: [__name__]
        regex: 'go_.*|process_.*'
        action: drop
      - regex: 'request_id|trace_id'
        action: labeldrop
drop 会让匹配指标不进入 TSDB;labeldrop 会在保留样本的同时移除指定标签;sample_limit 提供硬性上限,过滤后仍超过限制时该次抓取会被视为失败,因此它是保护栏,不应替代正常治理。
保存为 prometheus.yml 后,可先做语法检查:
promtool check config ./prometheus.yml >/dev/null && echo CONFIG_OK预期输出
CONFIG_OK配置通过语法检查并不代表过滤规则一定合理。修改后还应重新查看 TSDB 基数、目标的 up 状态以及关键告警和 Dashboard,确认成本下降且监控语义没有被破坏。
删除标签前先检查语义冲突
标签并非越少越好。如果两条原本不同的序列只靠 request_id 区分,直接删除这个标签后可能让它们变成完全相同的标签集合,造成同一抓取中样本冲突。更稳妥的顺序是先确认该标签是否参与区分业务维度,再决定删除标签、修改 exporter 暴露方式,还是直接丢弃整个指标。
对 exporter 也应采用同样原则:默认暴露的指标不等于全部都要长期保存。建立“谁使用、为什么采、允许多少序列”的采集规则,持续检查高基数来源,才能避免监控系统随着服务器和业务规模增长而被无效时间序列拖垮。