
可观测性与稳定性 / 系统课时
Target 显示 Down 应该查什么
Target 显示 Down 应该查什么
Prometheus 的 Target 显示 Down,说明目标已经被发现,但最近一次抓取没有成功。排查时不要直接修改 Prometheus 配置,而应沿着“目标地址、网络连接、HTTP 响应、指标内容”逐层缩小范围,最终根据 Last Error 定位根因。
学习目标
- 能根据 Targets 页面中的抓取地址和 Last Error 判断故障所在层级
- 能用
curl验证目标的网络连接与 HTTP 响应 - 能区分连接失败、HTTP 错误和指标格式错误,并完成修复验证
先确认 Prometheus 实际抓取了哪里
Target 为 Down 时,首先查看 Prometheus 的 Targets 页面。重点不是只看红色的 Down,而是确认 Endpoint、Last Scrape、Scrape Duration 和 Last Error。
Prometheus 最终访问的 URL 由目标地址、scheme 和 metrics_path 等配置共同决定。例如期望采集 Node Exporter 时,实际地址通常类似 http://<HOST>:9100/metrics。如果服务部署在其他端口、路径被反向代理改写,或者服务发现产生了错误地址,后面的网络检查即使全部正常也无法成功采集。
常见 Last Error 可以先按层级归类:连接被拒绝通常指向服务未监听或端口错误;超时通常指向网络、目标负载或响应过慢;401、403、404 等状态码属于 HTTP 层问题;解析相关错误则说明已经拿到了响应,但内容不是 Prometheus 能接受的指标格式。
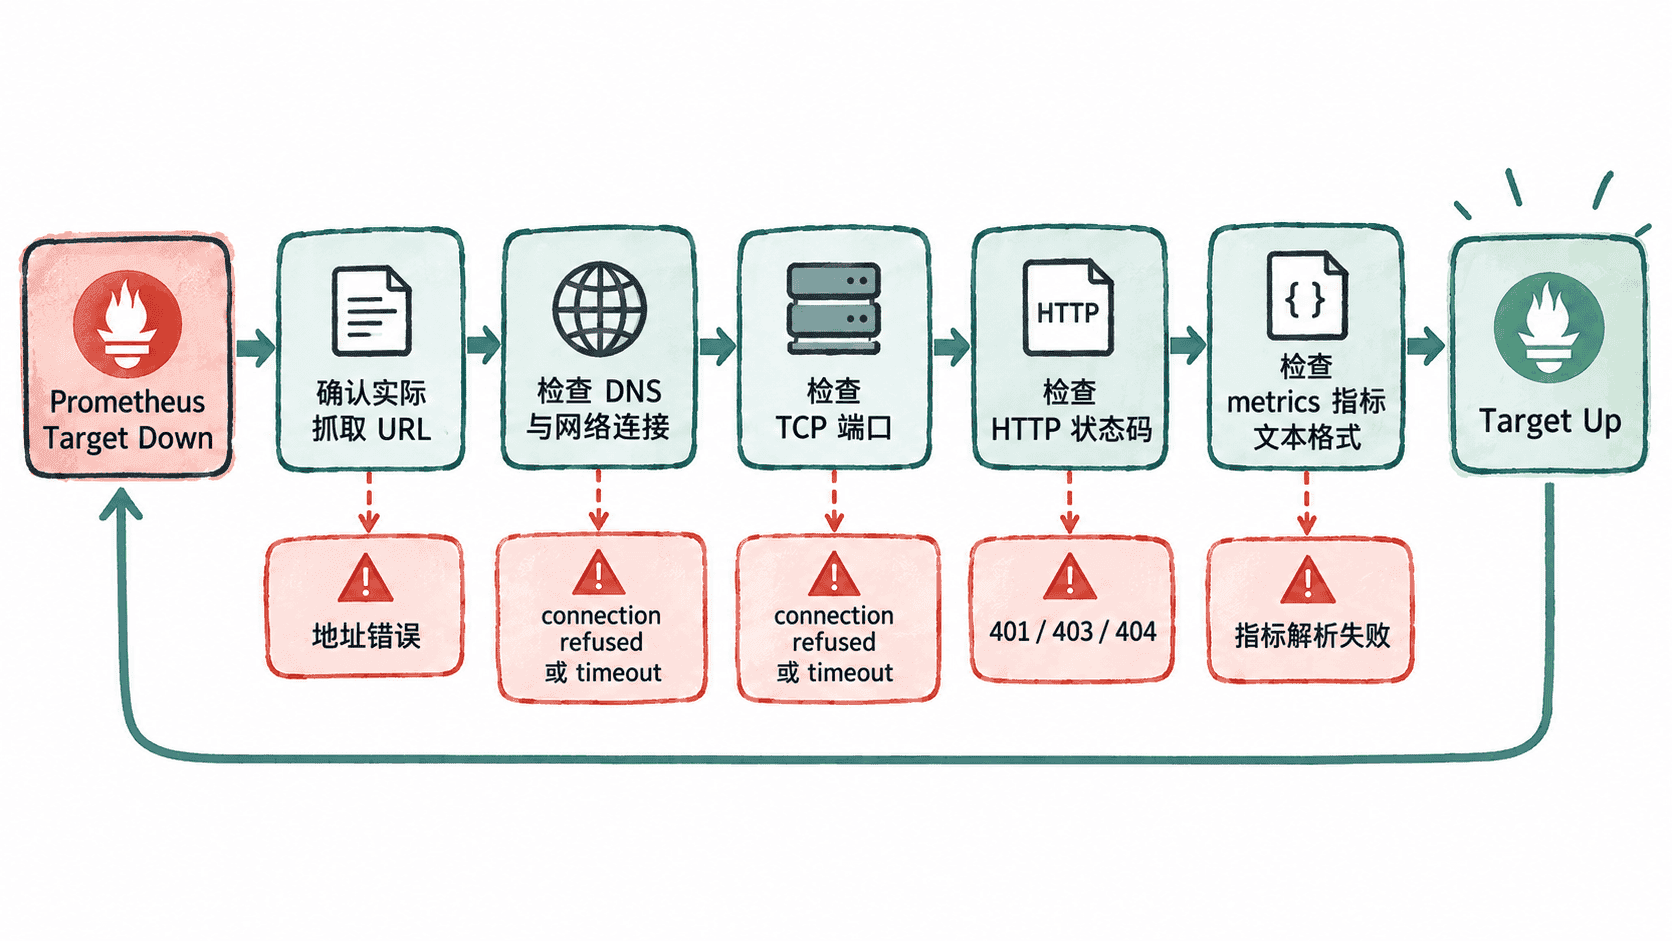
从 Prometheus 所在机器验证 HTTP 请求
排障命令应尽量在 Prometheus 服务器或容器实际所在的网络环境 中执行。你自己的电脑能访问目标,并不代表 Prometheus 所在节点也能访问。
将 <HOST> 替换为 Targets 页面显示的实际主机或 IP,端口也应与 Endpoint 一致:
TARGET='http://<HOST>:9100/metrics'
curl -sS -o /dev/null -w 'HTTP %{http_code}\n' "$TARGET"
预期输出:
HTTP 200实际状态码可能不同。若出现 Could not resolve host,优先检查 DNS 或目标名称;Connection refused 通常意味着目标主机可达但该端口没有服务监听;连接超时则需要继续检查路由、防火墙、安全组以及目标端负载。
如果能够建立连接却得到 401 或 403,应检查认证配置;得到 404 时,应核对 metrics_path 和反向代理路由。不要通过单纯延长超时时间掩盖明显的地址或权限错误。
HTTP 200 之后还要检查指标内容
HTTP 200 只能证明服务器返回了成功响应,并不能保证响应体是合法的 Prometheus 指标。可以直接查看开头几行:
curl -sS 'http://<HOST>:9100/metrics' | head -n 8预期结果通常会看到 Prometheus 文本格式的注释或样本行,具体指标名称会因 Exporter 而不同:
# HELP <METRIC_NAME> <DESCRIPTION>
# TYPE <METRIC_NAME> <TYPE>
<METRIC_NAME> <VALUE>
如果返回的是 HTML 登录页、JSON 错误对象或代理服务器的错误页面,即使状态码是 200,Prometheus 仍可能因解析失败而把 Target 标记为 Down。此时应修正 Exporter、代理路径或认证链路,让 /metrics 返回 Prometheus 支持的 exposition format。
根据 Last Error 修复而不是猜测
排查 Target Down 的关键是让每一步都产生证据。Targets 页面中的 Last Error 往往已经包含最接近根因的信息,应与命令结果互相验证。
例如,connection refused 时先确认目标进程和监听端口;超时时先确认 Prometheus 到目标的网络路径,再检查目标是否响应过慢;HTTP 错误先修复路径或认证;解析错误则检查响应正文,不要继续折腾防火墙。
修复后重新观察 Targets 页面。下一次成功抓取后状态应恢复为 Up,同时 Prometheus 查询 up 指标时,对应目标的值会从 0 恢复为 1。这样才能确认故障已经真正消除,而不仅是从某台机器上手工访问成功。