
可观测性与稳定性 / 系统课时
错误率比错误数量更有意义吗
错误率比错误数量更有意义吗
只看错误数量很容易把高流量服务判断得更糟:一百次错误可能来自十万次请求,也可能来自一千次请求。本篇把错误请求速率除以总请求速率,用比例衡量失败程度,并处理低流量和维度不一致带来的误判。
学习目标
- 理解错误数量与错误率分别回答什么问题
- 使用 PromQL 计算按服务聚合的请求错误率
- 避免低流量和标签维度不一致导致的错误判断
用比例消除流量规模差异
错误数量描述失败事件的绝对规模,而错误率描述请求失败的相对概率。假设服务 A 在一段时间内有 100 次错误和 100000 次请求,错误率是 0.1%;服务 B 只有 30 次错误,却只有 300 次请求,错误率达到 10%。只按错误数量排序会得到完全不同的关注顺序。
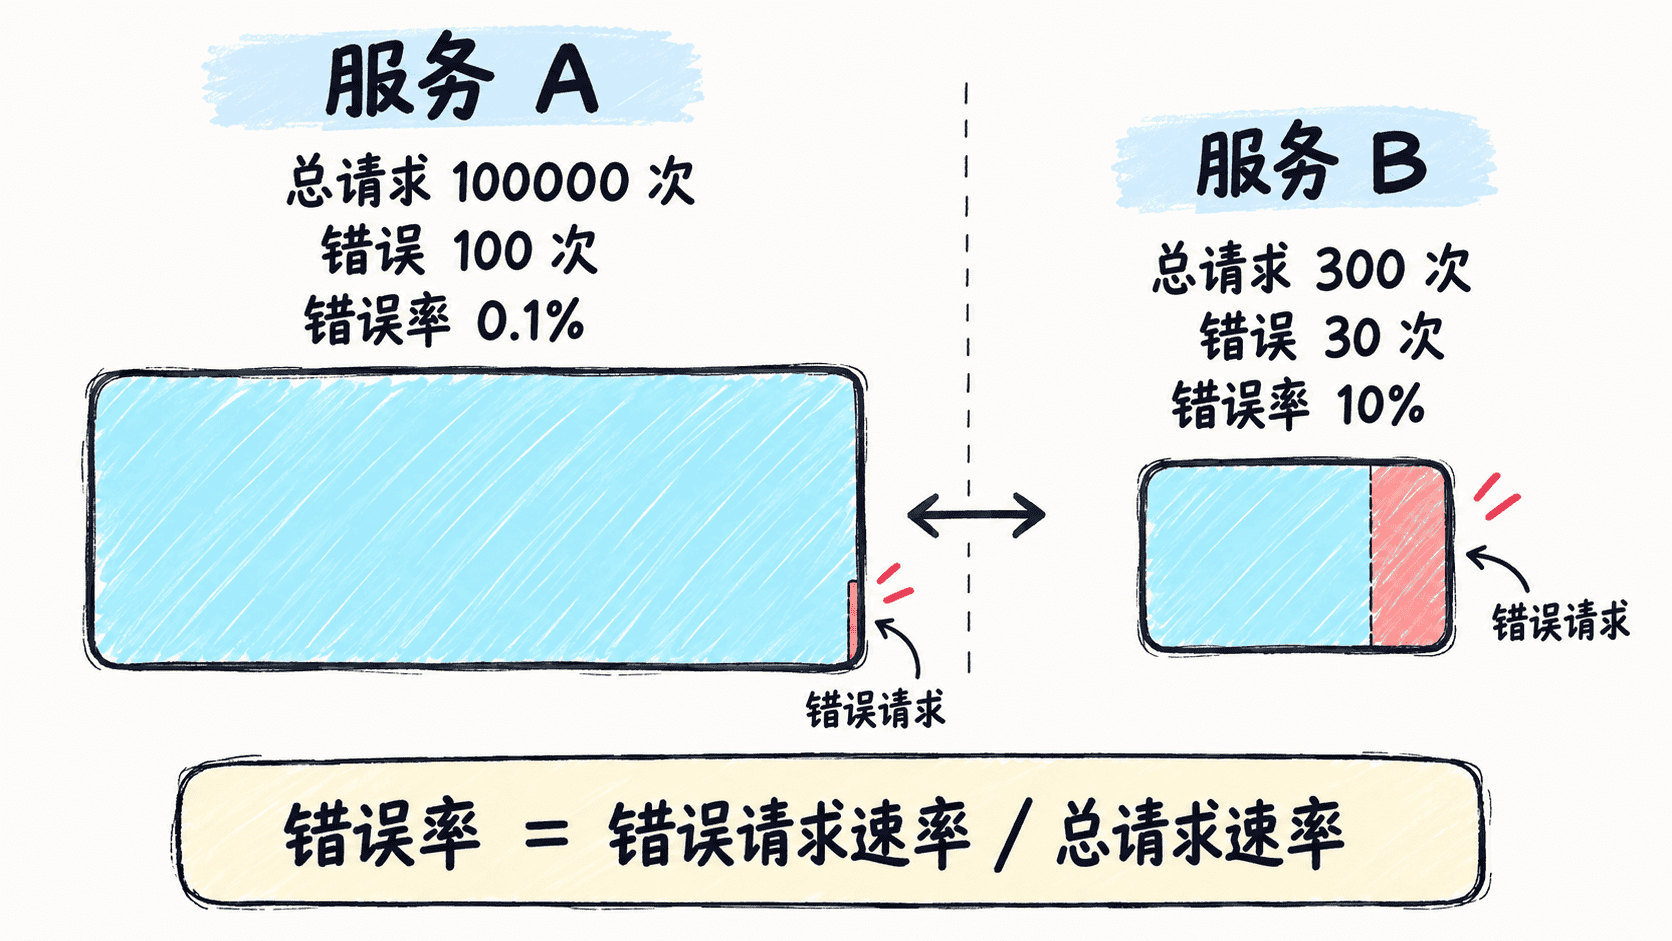
错误率的核心关系可以写成:错误请求速率 ÷ 总请求速率。如果需要百分比,再乘以 100。这样不同流量规模的服务就能够在相同尺度上比较失败程度。
用 PromQL 计算服务错误率
假设 http_requests_total 使用 status 标签记录 HTTP 状态码,并把 5xx 视为当前监控中的错误。下面的表达式先分别计算错误请求和全部请求的每秒速率,再按 service 聚合并相除。
100 *
sum by (service) (
  rate(http_requests_total{status=~"5.."}[5m])
)
/
sum by (service) (
  rate(http_requests_total[5m])
)
预期结果:
{service="checkout"} <ERROR_PERCENT>
{service="catalog"} <ERROR_PERCENT>
<ERROR_PERCENT> 是最近 5 分钟窗口计算出的错误百分比,实际数值随请求数据变化。例如结果为 2.5 时表示约 2.5%,因为表达式已经乘以 100。
5xx 只是 HTTP 服务中常见的一种错误定义。实际系统可能还需要把特定 4xx、gRPC 状态码或业务失败结果纳入计算,因此应先明确“什么算错误”,再设计分子筛选条件,而不是把所有服务机械套用同一规则。
保证分子和分母维度一致
错误率正确的前提是分子确实属于分母。分子按 service 聚合时,分母也应按 service 聚合;如果要分析具体接口,则两边都应使用相同的 service, route 分组和相同时间窗口。
常见错误是分子按接口统计,分母却使用整个服务流量。这样得到的数值不再表示该接口自身的错误比例,而是“接口错误数占全服务请求数”的另一种指标,语义已经发生变化。
另一个问题是标签筛选不一致。例如分子只统计生产环境,分母却包含测试环境,那么错误率会被额外流量稀释。编写查询时应逐项核对环境、服务、路由以及其他业务过滤条件。
低流量时不要只盯百分比
比例在低流量下会非常敏感。某服务 5 分钟只有一次请求并且刚好失败,错误率就是 100%,但这与每秒数百次请求持续失败所代表的影响规模完全不同。
因此,仪表盘最好同时展示请求量与错误率;告警也可以在错误率超过阈值之外,再要求总请求速率达到一个符合业务规模的最低条件。最低流量阈值没有通用数值,应根据服务正常请求规模和可接受的偶发失败确定。
错误数量并没有失去价值:它适合描述实际失败事件规模,错误率则更适合消除流量差异、观察服务质量。把请求量、错误数量和错误率放在同一上下文中,才能区分“流量大所以错误多”和“服务本身正在高比例失败”这两种完全不同的情况。