
可观测性与稳定性 / 系统课时
Histogram 怎样记录请求耗时
Histogram 怎样记录请求耗时
单个请求耗时不断变化,只记录一个“当前值”无法说明延迟分布。Histogram 会把每次请求耗时作为一次 observation,累计到多个 bucket 中,同时维护总次数和耗时总和,因此既能看请求规模,也能估算 P95、P99 等分位延迟。
学习目标
- 理解 Histogram 的 bucket、count 和 sum 分别记录什么
- 读懂经典 Histogram 的累积 bucket 语义
- 使用 bucket 数据计算一段时间内的延迟分位数
一次请求会更新哪些数据
以经典 Histogram 为例,假设请求耗时指标名为 http_request_duration_seconds,并配置了 0.1、0.3、0.5、1 秒等边界。每观察到一次耗时,Prometheus 客户端会更新三类数据:
_bucket{le="..."}:耗时小于等于该上界的累计观察次数_count:已经观察到的请求总数_sum:所有观察值的累计总和
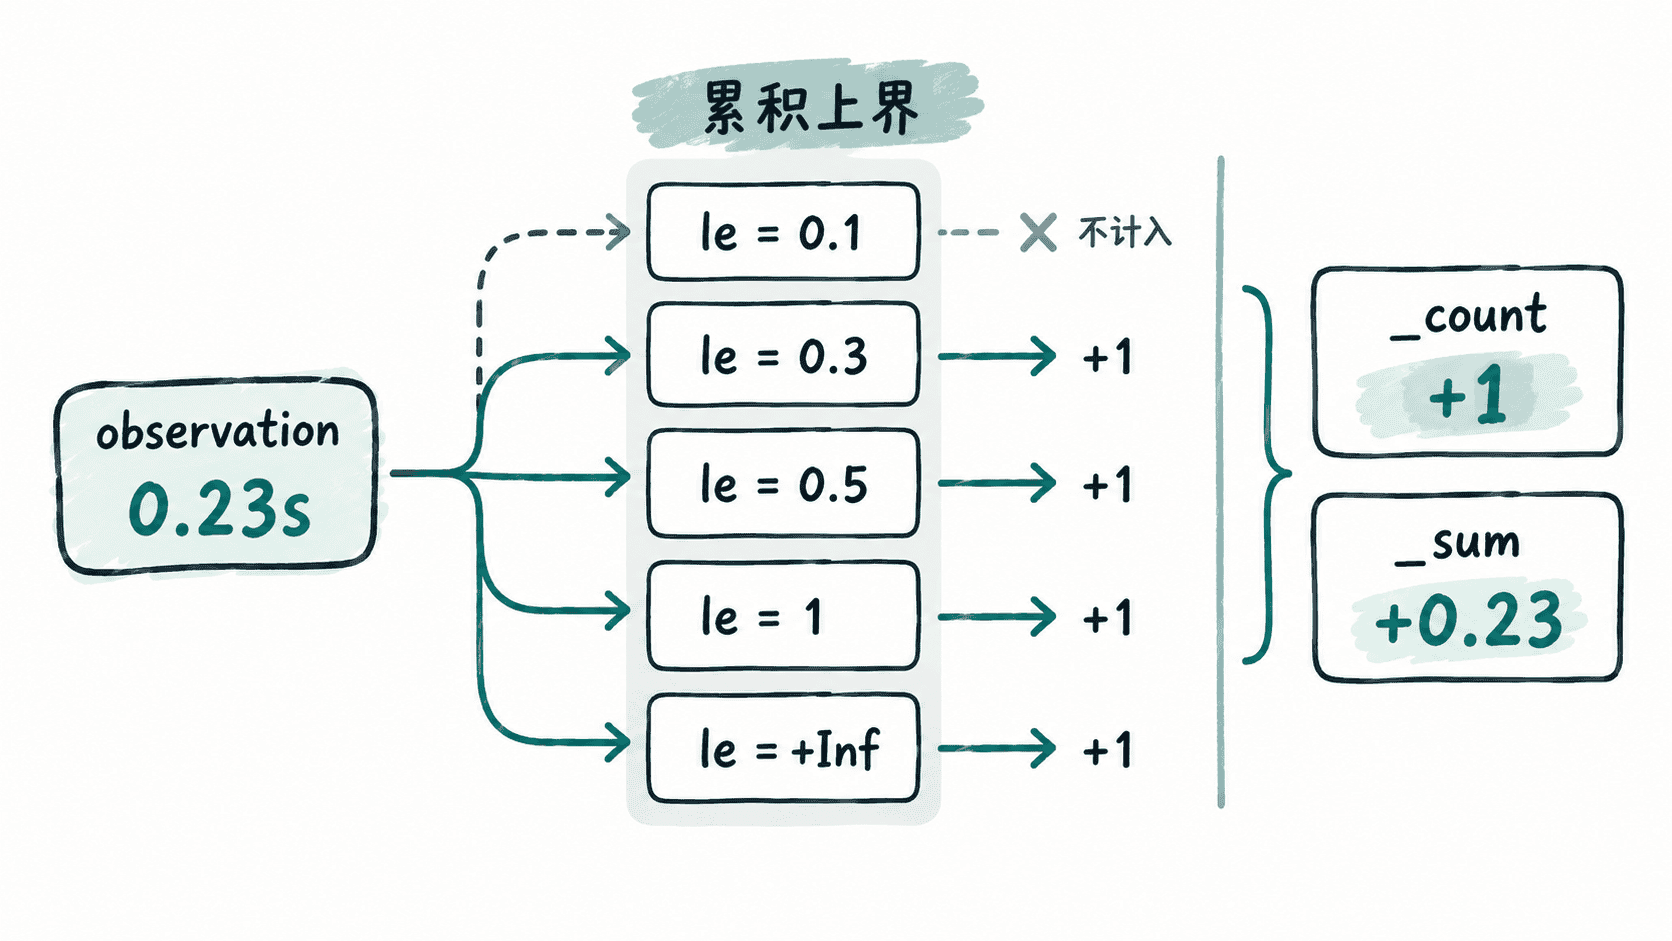
最容易误解的是 bucket:它们是累积的。一个 0.23 秒的请求不仅进入 le="0.3",也会同时计入 le="0.5"、le="1" 和 le="+Inf"。因此后一个 bucket 的计数不会小于前一个。
抓取结果怎样展开
假设服务已经处理了若干请求,经典 Histogram 在暴露端通常会展开为多条时间序列。下面只演示结构,数值用于说明 bucket、count 和 sum 的关系。
http_request_duration_seconds_bucket{le="0.1"} 18
http_request_duration_seconds_bucket{le="0.3"} 67
http_request_duration_seconds_bucket{le="0.5"} 91
http_request_duration_seconds_bucket{le="1"} 99
http_request_duration_seconds_bucket{le="+Inf"} 100
http_request_duration_seconds_count 100
http_request_duration_seconds_sum 24.7
因为 +Inf bucket 会接住所有观察值,所以它通常与 _count 相等。上面的 _sum 表示这 100 次请求耗时之和为 24.7 秒;用 _sum / _count 可以得到累计平均值,但平均值不能告诉你长尾请求有多慢。
本课按经典 Histogram 的 _bucket、_count、_sum 形式理解机制。Native Histogram 仍记录分布、总数和总和,但使用复合样本表达,不再依赖同样的多条经典 bucket 时序展开。
用 bucket 计算 P95
监控请求延迟时,通常关注最近一段时间,而不是进程启动以来的累计分布。经典 Histogram 的 bucket 本质上是递增计数,因此先对 bucket 使用 rate() 得到窗口内速率,再交给 histogram_quantile() 估算分位数。
下面查询把所有实例的 bucket 按 le 聚合,并估算最近 5 分钟整体请求耗时的 P95:
histogram_quantile(
  0.95,
  sum by (le) (
    rate(http_request_duration_seconds_bucket[5m])
  )
)
预期结果
<VALUE><VALUE> 是以秒为单位的 P95 估算值,实际数值取决于最近 5 分钟的请求分布。若还保留了 route、method 等标签,并希望分别观察,就必须在聚合时保留相应标签,同时始终保留经典 Histogram 计算分位数所需的 le。
bucket 边界决定精度
Histogram 并不保存每一个原始耗时,而是保存各个上界下的累计数量,所以分位数只能根据 bucket 估算。如果 SLO 关心“95% 请求低于 300 ms”,却只配置了 0.1 和 1 秒两个相距很远的边界,那么 300 ms 附近的判断会很粗。
因此 bucket 应围绕真正关心的延迟区间设计,而不是盲目增加大量边界。经典 Histogram 每增加一个 bucket,通常也会增加对应时间序列;再叠加高基数标签后,存储和查询成本会迅速放大。
当目标是服务端请求耗时、响应大小这类分布数据,并且需要跨实例聚合后计算分位数时,Histogram 很适合。理解“bucket 是累积计数、count 是总次数、sum 是总和”之后,延迟看板和告警查询就不再只是三个后缀的机械组合。